ROS 2는 왜 ‘실시간’이라고 할까: real time factor 1.0과 마감을 지키는 실시간 컴퓨팅을 숫자로 구분하기
RTF가 1.0이면 그 시뮬레이션 시계로 도는 100 Hz 제어 루프도 매 주기 마감을 지키고 있다고 봐도 될까? 이 질문의 첫 단서는 ROS 2 설계 문서 「Clock and Time」의 한 줄에 있다. 문서는 ‘real time’을 시간이 실제로 흐르는 속도라고 정의하고, 바로 다음 문장에서 이것이 결정적(deterministic, 같은 조건이면 언제 끝나는지가 흔들리지 않는) 마감이 있는 ‘real-time’ 컴퓨팅과는 연결되지 않는다고 적었다. ROS 2는 왜 ‘실시간’이라고 할까라는 물음이 헷갈리는 이유도 여기에 있다. 시뮬레이터 화면의 real time factor와 ‘실시간 제어’는 같은 단어를 쓰면서 서로 다른 양을 잰다.
RTF 1.0이라는 사실만으로는 마감을 지켰는지 판정할 수 없다. RTF는 시뮬레이터가 시계를 얼마나 빨리 돌렸는지의 비율이고, 마감 판정은 콜백 하나하나가 언제 끝났는지에서 나오기 때문이다. 아래에서는 이 차이를 밀리초 사칙연산으로 먼저 세우고, ROS 2 타이머가 늦은 콜백을 처리하는 규칙을 소스에서 확인한 다음, CPU 1개 분량으로 제한한 ROS 2 Jazzy 컨테이너에서 같은 실행의 RTF와 마감 초과를 따로 센 결과와 맞춰 본다. RTF가 0.9995 이상으로 유지된 네 번의 실행에서 제어 콜백은 매번 10 ms 마감을 20번 넘겼다. 나머지 한 번은 CPU 제한 기록이 남은 구간에서 RTF도 0.968로 내려갔다. 그래서 이 글의 주장은 “RTF와 마감은 무관하다”까지 가지 않고, RTF가 1.0이라는 사실로는 마감 준수를 판정할 수 없다는 데서 멈춘다. ROS 2 토픽과 타이머를 써 본 정도를 전제로 하며, 실시간 커널 설정과 실물 로봇은 다루지 않는다.
RTF는 시뮬레이터 시계가 얼마나 빨리 갔는지만 센다
도입에서 옮긴 정의는 「Clock and Time」의 130_ros_time.md L35-L38에 있다. 이 글의 GitHub 링크는 모두 2026-10-04에 원문을 열어 해당 줄을 확인한 커밋에 고정했고, 설계 문서는 구현 사양이 아니라 설계 의도를 적은 글이라는 점도 함께 기억해 둘 만하다.
시뮬레이터가 보여 주는 실시간 계수(real time factor, RTF)는 이 첫째 뜻, 곧 시간이 흐르는 속도 위에 서 있다. 시뮬레이션 시간(simulated time, 시뮬레이터 안에서 흐른 시간)이 벽시계 시간(wall-clock time, 바깥 세계에서 실제로 흐른 시간)에 비해 얼마나 빨리 가는지를 나타내는 비율이다. SDFormat 스펙은 <real_time_factor>를 “시뮬레이션 시간 대 실제 시간의 비로 정의한 목표 가속 배율, 기본값 1.0″이라고 적고(physics.sdf L23-L25), Gazebo Sim 서버도 반복마다 simTimeDiff / realTimeDiff로 이 값을 계산한다(SimulationRunner.cc L437-L467).
단위가 없는 비율이라 계산은 나눗셈 하나다. 시뮬레이션 10초가 벽시계 10초 동안 흘렀다면 10 ÷ 10 = 1.0이고, 같은 10초에 벽시계 20초가 걸렸다면 10 ÷ 20 = 0.5다. Gazebo 메시지 정의 파일의 주석은 0.5를 반대 방향으로 읽힐 수 있게 적어 두었는데(world_stats.proto L57-L60), 이 글은 SDF 정의와 소스 계산식 쪽을 따른다.
화면에 뜨는 숫자는 그 비율을 한 번 더 뭉갠 값이다. 확인한 커밋 기준으로 Gazebo Sim 서버는 통계 메시지를 초당 10건으로 제한해 보내고(SimulationRunner.cc L856-L862), gz-gui의 WorldStats 플러그인은 시뮬레이션·실제 시간에 α=0.9 지수 평활을 걸어 RTF를 퍼센트로 표시한다(WorldStats.cc L229-L258). Isaac Sim은 프레임마다 시뮬레이션 경과 ÷ 실제 경과로 계산해 ROS 2 토픽으로 발행한다(Isaac Sim 5.1.0 RTF 튜토리얼). 세 계산 어디에도 내 제어 노드의 콜백이 언제 실행됐는지는 들어가지 않는다. RTF가 /clock 전달 지연과 곱해져 타임스탬프 오차로 번지는 계산은 ROS 2 시뮬레이션을 10배속으로 돌리면 타임스탬프는 얼마나 어긋날까에서 따로 다뤘으므로 여기서는 되풀이하지 않는다.
마감은 가장 늦게 끝난 한 번으로 정해진다
둘째 뜻은 같은 저장소의 「Introduction to Real-time Systems」에 있다. 마감(deadline)은 “어떤 작업이 반드시 끝나야 하는 유한한 시간 창”이다(120_realtime_background.md L40). 문서는 실시간 시스템을 낮은 지연이 아니라 결정적인 일정으로 정의하고, 그래서 지연을 잴 수 있어야 하며 작업마다 최대 허용 지연을 정해야 한다고 쓴다(L60-L64). 평균이 아무리 좋아도 허용 지연을 넘긴 한 번이 있으면 그 작업은 마감을 놓친 것이다. 놓쳤을 때 무슨 일이 생기느냐에 따라서는 세 갈래로 나눈다(L47-L55).
- 하드 실시간(hard real-time): 마감을 놓치면 시스템 실패로 본다. 문서의 예는 항공기 센서·자동조종, 우주선과 행성 탐사 로버다.
- 소프트 실시간(soft real-time): 마감을 지키려 하지만 놓쳐도 실패는 아니며 서비스 품질이 떨어진다. 예는 오락용 오디오·비디오 전송이다.
- 펌 실시간(firm real-time): 실패로 보지는 않지만 마감 뒤에 나온 결과는 무효로 버린다. 예는 금융 예측 시스템과 로봇 조립 라인이다.
두 뜻을 나란히 놓으면 묻는 질문과 단위부터 다르다.
| 뜻 | 묻는 질문 | 단위 |
|---|---|---|
| 시간 진행 속도(RTF) | 시뮬레이션 시계가 벽시계보다 빨리 가나, 느리게 가나 | 단위 없는 비율 (1.0, 0.5) |
| 실시간 컴퓨팅(마감) | 이 작업이 매번 정해진 시각까지 끝나나 | 시간(ms), 최대 지연, 초과 횟수 |
Robotics Stack Exchange 22252번 질문(2021년 6월)은 범용 운영체제 위에서 도는 ROS 2가 어떻게 실시간이라는 말을 쓰느냐고 물었고, 채택된 답변은 ROS가 말하는 실시간이 대개 소프트 실시간이라고 설명했다. 공식 문서의 표현은 그보다 조심스럽다. 설계 문서는 실시간 성능에 실시간 운영체제와 결정적으로 실행되는 사용자 코드가 모두 필요하며 둘 중 하나만으로는 나오지 않는다고 쓰고(L64), ROS 2 공식 튜토리얼도 ROS 2가 실시간 성능 제약을 염두에 두고 설계되고 있다고 할 뿐 실시간을 자동으로 보장한다는 문장은 없다. 그러니 “ROS 2는 실시간인가”의 답은 프레임워크 이름에서 나오지 않는다. 운영체제, 실행 코드, 하드웨어를 포함한 구성 전체를 마감 기준으로 재 봐야 정해진다.
1000주기 계산 하나에 RTF 1.0과 15 ms 초과가 함께 들어간다
100 Hz 제어 루프의 주기는 1000 ÷ 100 = 10 ms다. 다음 주기가 오기 전에 일을 끝내야 한다고 보고, 여기서는 주기를 그대로 마감으로 둔다. 아래 숫자는 두 양을 같은 크기로 비교하려고 고른 설명용 값이다.
- 1000주기가 벽시계 10000 ms 동안 돌았다면 평균 간격은 10000 ÷ 1000 = 10 ms다.
- 시뮬레이션 시간으로 1000 × 10 ms가 흘렀으니 같은 실행의 RTF는 (1000 × 10) ÷ 10000 = 1.0이다.
- 그런데 가장 긴 간격이 25 ms였다면 마감 초과량은 25 − 10 = 15 ms다.
- 1000주기 중 3번 마감을 넘겼다면 비율은 3 ÷ 1000 × 100 = 0.3 %다.
평균과 RTF는 흠잡을 데가 없는데 마감은 깨졌다. 반대 방향은 직접 판단해 보자. RTF가 0.5로 떨어진 시뮬레이션에서, use_sim_time(노드가 벽시계 대신 /clock 토픽이 알려 주는 시뮬레이션 시각을 자기 시계로 쓰게 하는 파라미터)을 켠 노드가 시뮬레이션 시간 10 ms마다 한 단계를 돈다. 한 단계에 쓸 수 있는 벽시계 예산이 25 ms라면 이 루프는 예산을 지킬까?
지킨다. 시뮬레이션 10 ms 한 단계는 벽시계로 10 ÷ 0.5 = 20 ms를 차지하고, 예산에는 25 − 20 = 5 ms가 남는다. RTF가 정확히 1.0이어도 마감이 깨질 수 있었고, 1.0에서 한참 멀어도 단계별 예산은 지켜질 수 있다. 두 경우를 가른 것은 단계 하나의 길이였다.
본문에 나온 9개 계산(앞 절의 10 ÷ 10과 10 ÷ 20 포함)은 교육용 산술 예제 example.py로 다시 계산했고, 식·기대값·실제값을 검산 기록 verification.json에 남겼다(Python 3.12.3, 2026-10-04). ROS 2나 시뮬레이터를 돌린 결과가 아닌 산술 검산이고, 25 ms와 0.3 %를 권장값으로 쓸 근거도 없다.
계산이 보여 주는 것은 두 값의 재료가 다르다는 점이다. RTF는 흐른 시간의 합계를 나눈 값이고, 마감 판정은 가장 나쁜 한 주기에서 나온다. 다만 이 모델은 25 ms짜리 간격이 생긴 뒤에도 1000주기가 그대로 남는다고 가정했는데, 실제 ROS 2 타이머는 늦은 콜백 뒤에 그렇게 움직이지 않는다.
늦은 콜백 뒤에 rcl 타이머는 주기 하나를 건너뛴다
콜백(callback)은 타이머가 때가 되면 호출하는 함수다. ROS 2의 C 계층 라이브러리 rcl은 rcl_timer_call에서 다음 예정 시각을 “직전 예정 시각 + 주기”로 옮긴다. 옮긴 시각이 이미 지났다면, 즉 한 주기 이상 늦었다면 놓친 주기 수만큼 예정 시각을 더 앞으로 건너뛴다(rcl timer.c L298-L319, Jazzy 브랜치). 예정 시각은 늦은 실행에 끌려가지 않고 처음 정한 격자 위에 머문다.
주기 10 ms에서 t=0 콜백이 22 ms 동안 실행됐다고 해 보자. 10 ms 격자 몫의 콜백은 t≈22에야 12 ms 늦게 시작한다. 이때 다음 예정인 20은 이미 지났으므로 30으로 건너뛰고, 20 격자의 콜백은 아예 실행되지 않는다. 콜백 시작 간격은 22 ms 다음에 8 ms가 된다.
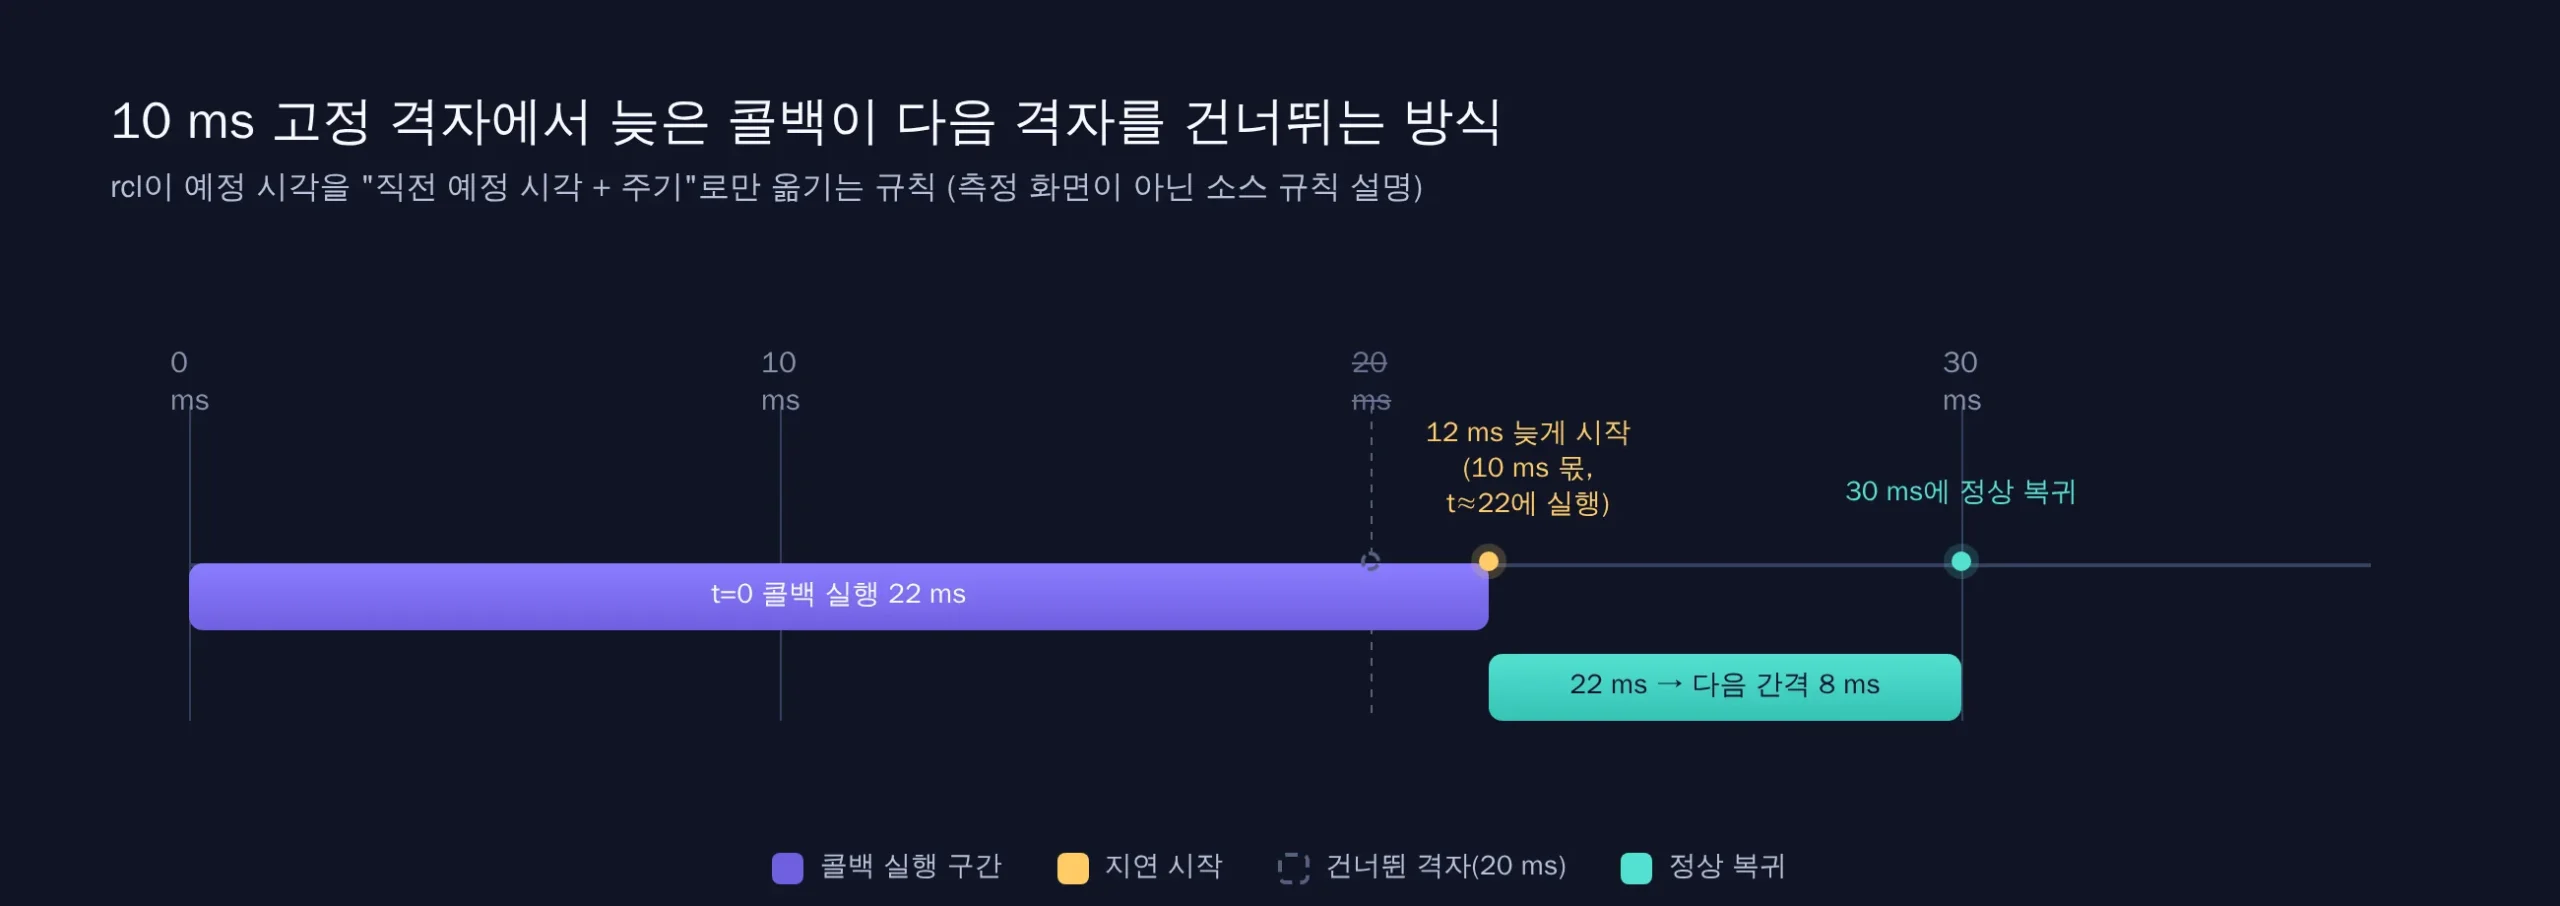
이 규칙에서 두 가지가 따라 나온다. 늦은 콜백 뒤에는 짧은 간격이 오므로 긴 실행의 평균 간격은 주기 근처로 돌아온다. 놓친 주기는 나중에 몰아서 실행되지 않으므로 콜백 수가 예정보다 적어진다. 평균 간격 하나만 보면 큰 지연이 가려지고, 최대 간격·마감 초과 횟수·건너뛴 주기 수를 따로 세야 드러난다는 뜻이다. 여기까지는 소스를 읽고 내린 해석이고, 실제로 그렇게 움직이는지는 다음 절에서 쟀다.
공식 문서도 같은 방식으로 판정한다. ROS 2 「Understanding real-time programming」은 1 kHz(주기 1 ms) 루프에서 최대 허용 지연을 주기의 5 %로 가정하고, 예시 출력의 평균 지연 19871.8 ns(약 19.9 µs)는 “정말 좋았지만” 최대 지연 2752187 ns(약 2.75 ms)가 업데이트 주기를 넘어 받아들일 수 없다고 설명한다(Real-Time-Programming.rst L164-L186). 1 ms의 5 %인 50 µs를 기준으로 보면 평균은 합격이고 최댓값은 불합격이다. 이 수치는 문서에 실린 예시이며 측정 환경이 적혀 있지 않다. 해당 데모는 Connext DDS(ROS 2가 노드 사이 메시지 전달에 쓰는 통신 표준 DDS, Data Distribution Service의 상용 구현 하나) 정적 빌드를 요구하므로 Jazzy 바이너리 설치에서 그대로 재현된다고 보기도 어렵다.
CPU 1개 분량으로 제한한 컨테이너에서 RTF와 마감 초과를 같은 실행으로 세기
측정은 2026-10-04에 ROS 2 Jazzy 공식 이미지 ros:jazzy-ros-base(digest sha256:066420e07f60aa18262f2479981def87ebcfcec42eefb0c0c57c4a46098348ca) 하나에서 했다. 컨테이너에는 --cpus 1, 메모리 1 GiB, 네트워크 없음 조건을 걸었다. --cpus 1은 코어 하나를 따로 떼어 주는 설정이 아니라 CPU 1개 분량의 실행 시간 할당량이어서, 아래 환경 기록처럼 컨테이너 안에서 보이는 CPU는 2개("cpus_visible": 2)였다. 컨테이너 안의 프로세스들이 이 할당량을 함께 나눠 쓰고, 다 쓰면 함께 멈춘다. Python 3.12.3, rclpy 7.1.12-1noble.20260902.053513이고, 메시지 통신 계층(RMW, ROS middleware)은 기본값인 rmw_fastrtps_cpp를 썼다. 호스트 커널은 SMP PREEMPT 표기의 일반 커널이며, 리눅스를 실시간용으로 바꾸는 PREEMPT_RT 커널이 아니다. 같은 스크립트를 하네스가 다섯 번 돌렸다.
스크립트는 100 Hz 타이머를 다섯 구간에서 5초씩 돌린다. 콜백마다 시작·종료 시각을 단조 시계(monotonic clock, 시스템 시각을 고쳐도 뒤로 가지 않는 시계)인 time.monotonic_ns()와 타이머가 쓰는 시계로 함께 기록한다. 콜백은 단일 스레드 실행기(executor, 준비된 콜백을 하나씩 차례로 실행하는 ROS 2 구성 요소)에서 돈다. 시뮬레이션 구간에서는 같은 스크립트를 별도 OS 프로세스로 띄워 시뮬레이터 대신 /clock(현재 시뮬레이션 시각을 실어 보내는 토픽)을 발행하게 했다. 이 프로세스는 시뮬레이션 시간을 1 ms씩 올리며 목표 RTF에 맞춰 속도를 조절하고, 뒤처지면 몰아서 따라잡지 않는다. use_sim_time이 켜진 노드는 마지막으로 받은 /clock 값을 ROS 시간으로 쓰므로(130_ros_time.md L98), 이 노드의 10 ms 타이머는 시뮬레이션 시간으로 10 ms마다 울린다. ROS 시간·시스템 시간·단조 시간의 차이는 ROS 2 시뮬레이션 시간이 뒤로 가면 로봇 타이머 계산은 어떻게 깨질까에서 따로 설명했다.
22 ms 지연은 25·75·125번째처럼 50개마다 하나씩 time.sleep으로 넣은 의도적인 대조군이며, 자연히 생긴 장애가 아니다. 마감 초과는 응답 시간, 즉 예정 격자 대비 시작 지연에 콜백 실행 시간을 더한 값이 10 ms를 넘은 경우로 셌다.
본 실행 전 시험 실행 세 번에서 측정 항목을 두 번 늘렸다. 처음에는 “간격이 10 ms를 넘은 횟수”를 마감 판정에 쓰려 했는데, 지연을 넣지 않아도 간격의 절반가량이 10 ms를 아주 조금씩 넘었다. 그래서 공식 튜토리얼이 가정한 허용 지터(jitter, 주기 간격의 흔들림) 5 %를 더한 기준을 함께 출력하게 했다. 두 번째 시험 실행에서는 지연을 넣지 않은 기준선에서도 수십 ms짜리 간격이 나와, 그 시점과 컨테이너의 CPU 제한 기록(cgroup cpu.stat, 리눅스가 컨테이너에 준 CPU 할당량을 다 써서 멈춘 횟수와 시간)을 같이 남기도록 했다.
plan.md에 적어 둔 예측과 하네스가 5회 실행한 결과를 구간별로 놓으면 다음과 같다. 범위는 5회 중 최솟값~최댓값이다.
| 구간 | 예측 (plan.md) | 실측 5회 (results.json) |
|---|---|---|
wall_baseline 벽시계 타이머, 주입 없음 |
평균 간격 ≈ 10 ms, 최대는 예측하지 않음 | 평균 10.0 ms(5회 모두), 최대 10.079~11.148 ms, 마감 초과 0회(5회 모두) |
wall_injected 벽시계 타이머, 22 ms 주입 10회 |
평균 ≈ 10.2 ms(4980 ÷ 488), 최대 ≈ 22 ms, 다음 간격 ≈ 8 ms, 건너뛴 주기 ≈ 10, 마감 초과 ≈ 20 | 평균 10.205 ms, 최대 22.517~22.581 ms, 최소 7.404~7.467 ms, 건너뛴 주기 10, 마감 초과 20 (5회 모두) |
sim_rtf1 시뮬레이션 시간, 목표 RTF 1.0 |
RTF ≈ 1.0, 벽시계 평균 간격 ≈ 10 ms | RTF 1.0, 평균 10.0 ms, 최대 10.209~11.685 ms, 마감 초과 0회 (5회 모두) |
sim_rtf1_injected 목표 RTF 1.0 + 22 ms 주입 |
RTF ≈ 1.0 유지, 최대 ≈ 22 ms, 건너뛴 주기 ≈ 10, 마감 초과 ≈ 20 | 2~5회차: RTF 0.9995~1.0, 최대 22.903~23.103 ms, 건너뛴 주기 10, 마감 초과 20. 1회차: RTF 0.968, 최대 41.491 ms, 건너뛴 주기 8, 마감 초과 18 |
sim_rtf05 목표 RTF 0.5 |
RTF ≈ 0.5, 벽시계 평균 ≈ 20 ms, 25 ms 예산 초과 없음 | 1·2·4회차: RTF 0.5, 평균 20.0 ms, 최대 20.172~20.263 ms, 예산 초과 0회. 3·5회차: RTF 0.4907·0.494, 최대 38.849·62.528 ms, 예산 초과 8·3회. 시뮬레이션 시간 기준 마감 초과는 5회 모두 0회 |
아래는 results.json의 stdout에서 그대로 옮긴 세 줄이다. 첫 줄은 2회차의 환경 기록, 둘째 줄은 2회차의 sim_rtf1_injected, 셋째 줄은 1회차의 sim_rtf1_injected다.
{"phase": "environment", "kernel": "7.0.0-1009-aws", "kernel_version": "#9~24.04.1-Ubuntu SMP PREEMPT Mon Jul 13 22:43:41 UTC 2026", "python": "3.12.3", "cpus_visible": 2, "rmw": "default", "discovery_range": "SUBNET"}
{"phase": "sim_rtf1_injected", "timer_clock": "ros_time(use_sim_time)", "target_rtf": 1.0, "inject_ms": 22.0, "inject_every": 50, "period_ms": 10.0, "callbacks": 489, "grid_periods_spanned": 498, "skipped_periods": 10, "injected": 10, "interval_wall_ms": {"mean": 10.205, "min": 6.945, "p99": 22.804, "max": 23.087}, "max_wall_interval_at_s": 3.313, "interval_timer_clock_ms": {"mean": 10.205, "max": 22.0}, "start_lateness_ms": {"mean": 0.247, "max": 12.0}, "response_ms_max": 22.108, "deadline_ms": 10.0, "deadline_misses": 20, "wall_intervals_over_period": 230, "wall_intervals_over_period_plus_jitter": 12, "jitter_tolerance_ms": 0.5, "max_wall_interval_minus_deadline_ms": 13.087, "wall_intervals_over_budget": 0, "wall_budget_ms": 25.0, "exec_timer_clock_ms_max_injected": 0.0, "exec_wall_ms_max_injected": 22.108, "cgroup_cpu_delta": {"nr_periods": 50, "nr_throttled": 0, "throttled_usec": 0, "usage_usec": 2416551}, "first_clock_wait_s": 0.318, "rtf_seen_by_control_node": 1.0, "rtf_clock_publisher": 1.0, "rtf_clock_publisher_100ms_min": 0.9992, "rtf_clock_publisher_100ms_max": 1.001, "rtf_windows": 49}
{"phase": "sim_rtf1_injected", "timer_clock": "ros_time(use_sim_time)", "target_rtf": 1.0, "inject_ms": 22.0, "inject_every": 50, "period_ms": 10.0, "callbacks": 474, "grid_periods_spanned": 481, "skipped_periods": 8, "injected": 10, "interval_wall_ms": {"mean": 10.505, "min": 1.034, "p99": 22.883, "max": 41.491}, "max_wall_interval_at_s": 2.804, "interval_timer_clock_ms": {"mean": 10.169, "max": 23.0}, "start_lateness_ms": {"mean": 0.376, "max": 14.0}, "response_ms_max": 23.217, "deadline_ms": 10.0, "deadline_misses": 18, "wall_intervals_over_period": 250, "wall_intervals_over_period_plus_jitter": 69, "jitter_tolerance_ms": 0.5, "max_wall_interval_minus_deadline_ms": 31.491, "wall_intervals_over_budget": 2, "wall_budget_ms": 25.0, "exec_timer_clock_ms_max_injected": 0.0, "exec_wall_ms_max_injected": 22.217, "cgroup_cpu_delta": {"nr_periods": 50, "nr_throttled": 5, "throttled_usec": 49643, "usage_usec": 3117128}, "first_clock_wait_s": 0.317, "rtf_seen_by_control_node": 0.968, "rtf_clock_publisher": 0.9678, "rtf_clock_publisher_100ms_min": 0.737, "rtf_clock_publisher_100ms_max": 1.0175, "rtf_windows": 49}
wall_injected는 다섯 번 모두 소스 해석에서 세운 예측대로 나왔다. 평균 간격은 10.205 ms로 주기와 거의 같았지만 최대 간격은 22.517~22.581 ms였고, 가장 짧은 간격은 7.404~7.467 ms로 늦은 콜백 뒤에 간격이 짧아진다는 예측과 맞았다. 주입 1회마다 주기 하나가 건너뛰어져 10개가 사라졌다. 마감 초과 20회는 예측 근거대로라면 주입된 콜백 10회와, 그 직후 12 ms 남짓 늦게 시작한 콜백 10회를 합한 수다. 평균만 기록했다면 이 20회는 보이지 않았다.
제목의 질문에 직접 답하는 줄은 2회차 sim_rtf1_injected다. /clock 발행 프로세스 기준 RTF가 1.0이고 100 ms 창별 RTF도 0.9992 아래로 내려가지 않았는데, 같은 5초 동안 제어 콜백은 10 ms 마감을 20번 넘겼다. 3·4·5회차도 RTF 0.9995 이상에서 같은 20회가 나왔다. 시뮬레이터 쪽 진행 비율은 깨끗했고, 늦은 것은 별도 프로세스에서 돈 제어 노드의 콜백뿐이었다.
1회차는 예측과 달랐다. 전체 RTF가 0.968로 내려갔고, 100 ms 창 하나에서는 0.737까지 떨어졌다. 같은 구간에서 cgroup 기록에는 CPU 제한으로 멈춘 횟수 5회, 합계 49643 µs가 남았다. 다른 네 번의 같은 구간에서는 이 값이 0이었다. CPU 할당량이 바닥나 /clock 프로세스와 제어 노드가 함께 멈췄다고 보는 것이 가장 자연스러운 해석이지만, 멈춘 시점과 최대 간격 41.491 ms가 나온 시점을 맞춰 보지는 않았다. 이 실행에서 RTF는 1.0에서 3 % 남짓 떨어진 데 그쳤는데, 최대 간격은 마감을 31.491 ms 넘었다. RTF가 흔들린 실행에서도 그 폭은 마감 초과의 크기를 알려 주지 않았다.
sim_rtf05의 3·5회차는 앞에서 직접 판단해 본 RTF 0.5 계산과 어긋났다. 계산대로라면 벽시계 간격은 10 ÷ 0.5 = 20 ms 근처에 머물고 25 ms 예산에 5 ms가 남아야 했다. 그런데 구간 전체 RTF가 0.4907과 0.494로 목표와 거의 같았는데도 최대 간격은 38.849 ms와 62.528 ms까지 늘어 예산을 각각 8번, 3번 넘었다. 100 ms 창별로는 RTF가 0.3441과 0.2735까지 내려간 순간이 있었고, 이 두 구간에는 CPU 제한 기록이 없어서 원인은 이 데이터만으로 가리지 못했다. 계산은 평균적인 한 단계의 이야기였고, 예산을 지켰는지는 벽시계 간격의 최댓값을 봐야 알 수 있었다. 그러는 동안에도 시뮬레이션 시간으로 잰 마감 초과는 0회였다. 어느 시계로 잰 마감이냐에 따라 같은 실행이 합격도, 불합격도 된다.
지연을 넣지 않은 기준선은 다섯 번 모두 마감 초과가 0회였다. 그래도 498개 간격 가운데 242~252개는 10 ms를 아주 조금 넘었고, 10.5 ms를 넘은 간격은 4회차의 5개를 빼면 없었다. “간격이 주기를 넘었다”와 “마감을 놓쳤다”는 다른 판정이므로, 로그를 남기기 전에 마감과 허용 지터를 어떻게 정의할지부터 정해야 한다. 시험 실행 때는 기준선에서도 수십 ms짜리 간격이 나온 적이 있어서, 본 실행 다섯 번이 깨끗했다고 이 환경의 기준선이 늘 깨끗하다고 말할 수는 없다.
재현 스크립트와 실행별 원본 출력은 실험 디렉터리에 공개했다. 이 글이 인용한 값은 고정 커밋의 results.json과 experiment.py, 예측을 적은 plan.md에서 확인할 수 있다. Docker가 설치된 Linux 호스트라면 아래 명령으로 같은 이미지에서 다시 돌릴 수 있다. 이미지를 처음 받을 때만 네트워크가 필요하고, 컨테이너 자체는 네트워크 없이 돈다.
mkdir rtf-vs-deadline && cd rtf-vs-deadline
curl -fsSLO https://raw.githubusercontent.com/sungpyo9053/blog/d3bd73224cf16594e730a7c8de4adbf1e2fc82da/experiments/ros2-real-time-factor-vs-real-time-computing-deadline/experiment.py
sha256sum experiment.py
docker run --rm --network none --cpus 1 --memory 1g -v "$PWD":/work ros@sha256:066420e07f60aa18262f2479981def87ebcfcec42eefb0c0c57c4a46098348ca bash -c "source /opt/ros/jazzy/setup.bash && python3 /work/experiment.py"
sha256sum 결과가 eefd43cdc31aeef1a5ea597987df4ba6448c85a0191719c8ae4d1d3f72480e89이면 이 글이 쓴 스크립트와 같다. 하네스 기준으로 한 번 실행에 28초 안팎이 걸렸고, 정상 실행은 종료 코드 0으로 끝나며 JSON 일곱 줄(환경 한 줄, 구간 다섯 줄, done 한 줄)을 출력한다. no /clock received within 15 s 오류로 끝나면 시뮬레이션 구간이 시작조차 못 한 것이므로 측정값을 비교할 단계가 아니다. 하네스는 여기에 읽기 전용 마운트와 /tmp 분리 같은 격리 옵션을 더해 돌렸지만 CPU·메모리·네트워크 조건은 같다. 호스트가 다르면 숫자는 달라지므로, 비교할 대상은 wall_injected의 건너뛴 주기와 마감 초과 횟수, 그리고 sim_rtf1_injected에서 RTF와 마감 초과가 따로 움직이는지다.
이 결과가 대표하는 범위는 좁다. CPU 1개 분량으로 제한한 컨테이너, PREEMPT_RT가 아닌 커널, Python rclpy, 기본 RMW, 단일 스레드 실행기에서 5회 × 구간당 5초를 잰 값이고, C++ 노드나 실시간 커널, 실물 로봇의 지연 분포를 말해 주지 않는다. 어느 정도의 마감 초과율이 허용되는지도 정해 주지 않으며, 자연히 생긴 지연이 어느 실행, 어느 구간에 나타날지는 다섯 번 사이에서도 달랐다. 실물 하드웨어는 검증하지 않았다. 여기서 말하는 마감 판정은 안전 인증이 아니므로, 실물 제어 루프에 옮기기 전에는 해당 하드웨어의 정지 수단과 안전 조건을 따로 확인해야 한다.
내 노드에는 RTF 옆에 네 칸을 더 적는다
자기 노드의 마감 준수를 보려면 콜백이 시작할 때 단조 시계 값을 남기는 데서 출발하면 된다. 실험 스크립트의 기록 부분은 다음 몇 줄이 전부다(experiment.py의 Recorder.__call__ 발췌).
def __call__(self):
    wall_start = time.monotonic_ns()
    timer_start = self.clock.now().nanoseconds
    injected = self.inject and (len(self.rows) + 1) % INJECT_EVERY == INJECT_EVERY // 2
    if injected:
        time.sleep(INJECT_MS / 1000)
    self.rows.append((wall_start, timer_start, time.monotonic_ns(),
                      self.clock.now().nanoseconds, injected))
노드 시계(self.clock.now())만 남기지 않고 단조 시계를 함께 남긴 이유는 시험 실행에서 먼저 드러났고, 본 실행에서도 같았다. 시뮬레이션 구간에서 22 ms를 주입한 콜백의 실행 시간을 노드의 ROS 시간으로 재면 다섯 번 모두 0.0 ms였다. 같은 콜백을 단조 시계로 재면 실행마다 가장 긴 값이 22.102~22.217 ms였다. 콜백이 단일 스레드 실행기를 붙잡고 있는 동안 /clock 메시지가 처리되지 않아 노드의 ROS 시간이 멈춰 있었기 때문이다. use_sim_time 노드에서 콜백 실행 시간을 get_clock().now() 차이로만 재면 늦은 콜백을 놓친다.
건너뛴 주기는 rcl과 같은 규칙으로 예정 격자를 따라가며 센다(analyse 함수 발췌).
nxt = expected + period_ns
if nxt <= ts:
    ahead = 1 + (ts - nxt) // period_ns
    skipped += ahead
    nxt += ahead * period_ns
expected = nxt
이렇게 남긴 기록에서 최대 간격, 마감 초과 횟수, 건너뛴 주기 수를 계산하고, 네 번째 칸에는 이 값들을 단조 시계와 노드 시계 중 어느 쪽으로 쟀는지 적는다. RTF는 그 옆의 별도 칸이다. 마감 초과를 간격으로 셀지 응답 시간으로 셀지, 허용 지터를 얼마로 둘지도 숫자와 함께 적어 두어야 다른 실행과 비교할 수 있다.
운영 중에 마감 초과를 알아차리고 싶다면 deadline QoS가 있다. QoS(Quality of Service)는 토픽을 어떻게 전달할지 정하는 설정 묶음이고, 공식 문서는 그중 Deadline을 “토픽에 연속 메시지가 발행되는 사이의 기대 최대 시간”으로 정의한다(QoS 문서 L53-L55). 이를 넘기면 구독자 쪽에 Requested deadline missed 이벤트가 생기고(L308-L310), rclpy Jazzy에서는 SubscriptionEventCallbacks(deadline=...)로 이 이벤트에 콜백을 달 수 있다(event_handler.py L152-L201). 이 장치는 초과를 알려 줄 뿐 실행을 앞당겨 주지 않는다. 발행자와 구독자의 deadline 값이 어떤 조건에서 맞물리는지는 ROS 2 센서 토픽에 deadline QoS를 걸 때에 정리해 두었다.
기록을 보고 실시간 커널이나 스케줄러 우선순위를 올리는 단계로 넘어간다면, 공식 튜토리얼은 실시간 우선순위 한도(rtprio)를 99로 두면 워치독 같은 중요한 시스템 프로세스와 간섭할 수 있다고 경고한다(Understanding real-time programming). 같은 측정을 PREEMPT_RT 커널에서 다시 돌렸을 때 기준선과 1회차 같은 자연 지연이 어떻게 달라지는지는 이 글에서 확인하지 못한 조건으로 남아 있다.
RTF 1.0은 시뮬레이션이 제 속도로 진행됐다는 신호로 읽으면 된다. 제어 루프가 마감을 지켰다고 말하려면 그 옆에 최대 간격, 마감 초과 횟수, 건너뛴 주기 수, 그리고 이 값들을 어느 시계로 쟀는지가 있어야 한다. 이 네 칸이 비어 있는 로그라면 RTF가 1.0이더라도 “실시간으로 돌았다”고 적지 않는 편이 맞다.