ROS 2에서 중첩 구조 메시지 Foo[]를 만들 때: 같은 값을 기본형 배열 두 개로 나누면 비기본형 요소 수가 얼마나 달라지는지 세고 publish() 비교 실험 설계하기
ROS 2에서 중첩 구조 메시지 Foo[]를 만들 때 문법에서 막히는 일은 드물다. Foo.msg를 정의하고 다른 메시지에 Foo[] my_large_array 한 줄을 쓰면 빌드된다. 걸리는 것은 공식 문서의 경고다. ROS 2 문서의 DDS 튜닝 페이지(DDS는 ROS 2 아래에서 데이터를 실제로 주고받는 통신 미들웨어 표준, Data Distribution Service)는 크기가 큰 “가변 길이 비기본형 배열”이 직렬화 부담과 CPU 부하를 키워 publish()가 늦어지고 ros2 topic hz가 실제보다 낮게 보고될 수 있다고 적는다. 그리고 같은 내용을 uint64[] foo_1_array와 uint32[] foo_2_array 두 기본형 배열로 나누라고 권한다. 두 구조에 담기는 값의 바이트 합은 똑같은데, 무엇이 달라서 느려진다는 걸까?
세어야 할 것은 바이트가 아니라 비기본형 요소의 개수다. 요소 1만 개를 30 Hz로 보내면 선언한 필드의 바이트 합은 두 구조 모두 120000바이트지만, 문서가 문제 삼는 비기본형 요소는 초당 300000개 대 0개다. 이 셈이 실제 차이로 이어지는지 2026년 10월 8일 ROS 2 Jazzy 고정 이미지(Python 노드 rclpy, 기본 RMW rmw_fastrtps_cpp, 네트워크 없음, CPU 1개) 안에서 같은 값을 두 구조에 담아 다섯 번 쟀다. 결과는 실행 전에 적어 둔 예측과 같은 방향이었다. 직렬화 크기는 정렬 규칙으로 계산한 값과 바이트 단위까지 맞았고, Foo[] 쪽 publish() 한 번은 기본형 배열 쪽보다 수십 배 오래 걸렸다. 토픽 발행·구독을 해 봤고 uint64가 8바이트라는 정도를 알면 따라올 수 있다. 로봇이나 시뮬레이터를 돌린 실험은 아니다.
같은 값을 담는 두 가지 .msg
메시지 정의(.msg, message definition)는 토픽으로 보낼 데이터의 필드 이름과 타입을 적은 파일이다. 빌드하면 Python·C++ 클래스가 생성된다. 필드 타입 자리에 다른 메시지를 쓰면 중첩(nested) 메시지가 된다. 공식 튜토리얼의 Sphere.msg가 geometry_msgs/Point center를 필드로 쓰는 것이 그 예다. Robotics Stack Exchange에 올라온 “딕셔너리 안의 딕셔너리 같은 데이터를 어떤 메시지로 보내느냐”는 질문에도 단계별로 .msg를 만들어 겹쳐 쓰라는 답이 달렸다. 그 중첩된 메시지를 수천 개짜리 배열로 반복하는 순간, 문서가 경고한 상황이 된다.
DDS 튜닝 문서의 예시를 그대로 파일로 옮기면 다음과 같다.
# Foo.msg
uint64 foo_1
uint32 foo_2

# FooArray.msg — 요소마다 Foo 메시지 하나
Foo[] my_large_array

# FooSplit.msg — 같은 값을 열별로 나눈 두 기본형 배열
uint64[] foo_1_array
uint32[] foo_2_array
FooArray의 i번째 Foo가 가진 (foo_1, foo_2)는 FooSplit에서 foo_1_array[i]와 foo_2_array[i]가 된다. 담긴 값은 같고 묶는 방향만 다르다.
기본형(primitive, 공식 개념 문서의 built-in type)은 bool, int8~uint64, float32·float64, string처럼 ROS 2 인터페이스 표에 있는 타입이다. 표에 없는 타입, 곧 다른 메시지를 필드로 쓴 것이 비기본형(non-primitive)이다. 개념 문서는 이를 complex type이라 부르고 DDS 튜닝 문서는 non-primitive라 부르지만 같은 대상을 가리킨다. 헷갈리기 쉬운 것은 builtin_interfaces/Time이다. 이름에 builtin이 들어 있어도 sec과 nanosec 두 필드를 가진 메시지라서, DDS 튜닝 문서도 비기본형이라고 따로 적어 두었다. 요소마다 타임스탬프를 넣으면 요소 하나에 비기본형이 하나 더 붙는다.
[]처럼 길이를 정하지 않은 배열은 가변 길이 배열(unbounded dynamic array)이고, DDS 쪽 타입으로는 시퀀스(sequence)다. 문서의 경고는 이 가변 길이 배열의 요소가 비기본형이면서 개수가 많을 때를 겨냥한다.
바이트로 세면 같고, 비기본형 요소로 세면 1만 대 0이다
손으로 셀 수 있는 값은 두 가지다.
선언 필드 바이트는 필드 타입의 크기를 더한 값이다. Foo 하나는 uint64 8바이트와 uint32 4바이트를 합쳐 12바이트다. N=10000이면 FooArray는 10000 × 12, FooSplit은 10000 × 8 + 10000 × 4라서 둘 다 120000바이트가 된다. 이 값은 실제로 전송되는 직렬화 크기가 아니다. 시퀀스 길이 필드와 정렬용 빈 바이트가 빠져 있고, 그 차이는 뒤에서 잰다.
비기본형 요소 수는 문서가 지목한 처리가 메시지 하나 안에서 몇 번 일어나는지를 센다.
메시지당 비기본형 요소 수 = Σ (비기본형 배열의 길이 × 요소 하나에 든 비기본형 인스턴스 수)
초당 비기본형 요소 수     = 메시지당 비기본형 요소 수 × 발행 주기(Hz)
요소 하나에 든 인스턴스 수에는 요소 자신이 포함된다. Foo는 1이고, Time을 품은 FooStamped는 자신과 Time을 합쳐 2다.
| 구조 (N=10000, 30 Hz) | 메시지당 비기본형 요소 | 초당 비기본형 요소 |
|---|---|---|
Foo[] |
10000 × 1 = 10000 | 300000 |
uint64[] + uint32[] |
0 | 0 |
요소마다 Time을 넣은 FooStamped[] |
10000 × 2 = 20000 | 600000 |
이 값들과 앞의 바이트 합은 HuntLab이 이 글을 위해 만든 산술 예제 example.py를 Python 3.12.3으로 실행해 검산했다. 여덟 개 사례의 식과 기대값·실제값은 검산 기록 verification.json에 남아 있다. 사칙연산 검산이지 DDS나 로봇을 실행한 결과는 아니다.
이 수는 시간을 예측하는 식이 아니다. 문서는 요소 하나가 몇 마이크로초를 쓰는지, N에 비례하는지 말하지 않는다. 쓸모는 다른 데 있다. 내 토픽에 문서가 지목한 구조가 얼마나 들어 있는지 확인하고, 그 수가 크면 같은 조건에서 두 구조를 재 볼 후보로 올리는 것이다. 바꿀지 말지는 측정이 정한다.
rclpy의 publish() 안에서 요소 수가 비용이 되는 자리
publish()를 부른다고 메시지가 곧바로 나가지는 않는다. 먼저 직렬화(serialization), 곧 메모리 안의 메시지 객체를 전송할 바이트열로 바꾸는 단계를 거치고, 받는 쪽은 반대로 역직렬화(deserialization)를 한다. 이 일을 맡는 계층이 RMW(ROS middleware interface)다. ROS 2가 Fast DDS나 Cyclone DDS 같은 통신 구현을 갈아 끼우는 접점이며, Jazzy 이미지의 기본값은 Fast DDS를 쓰는 rmw_fastrtps_cpp다.
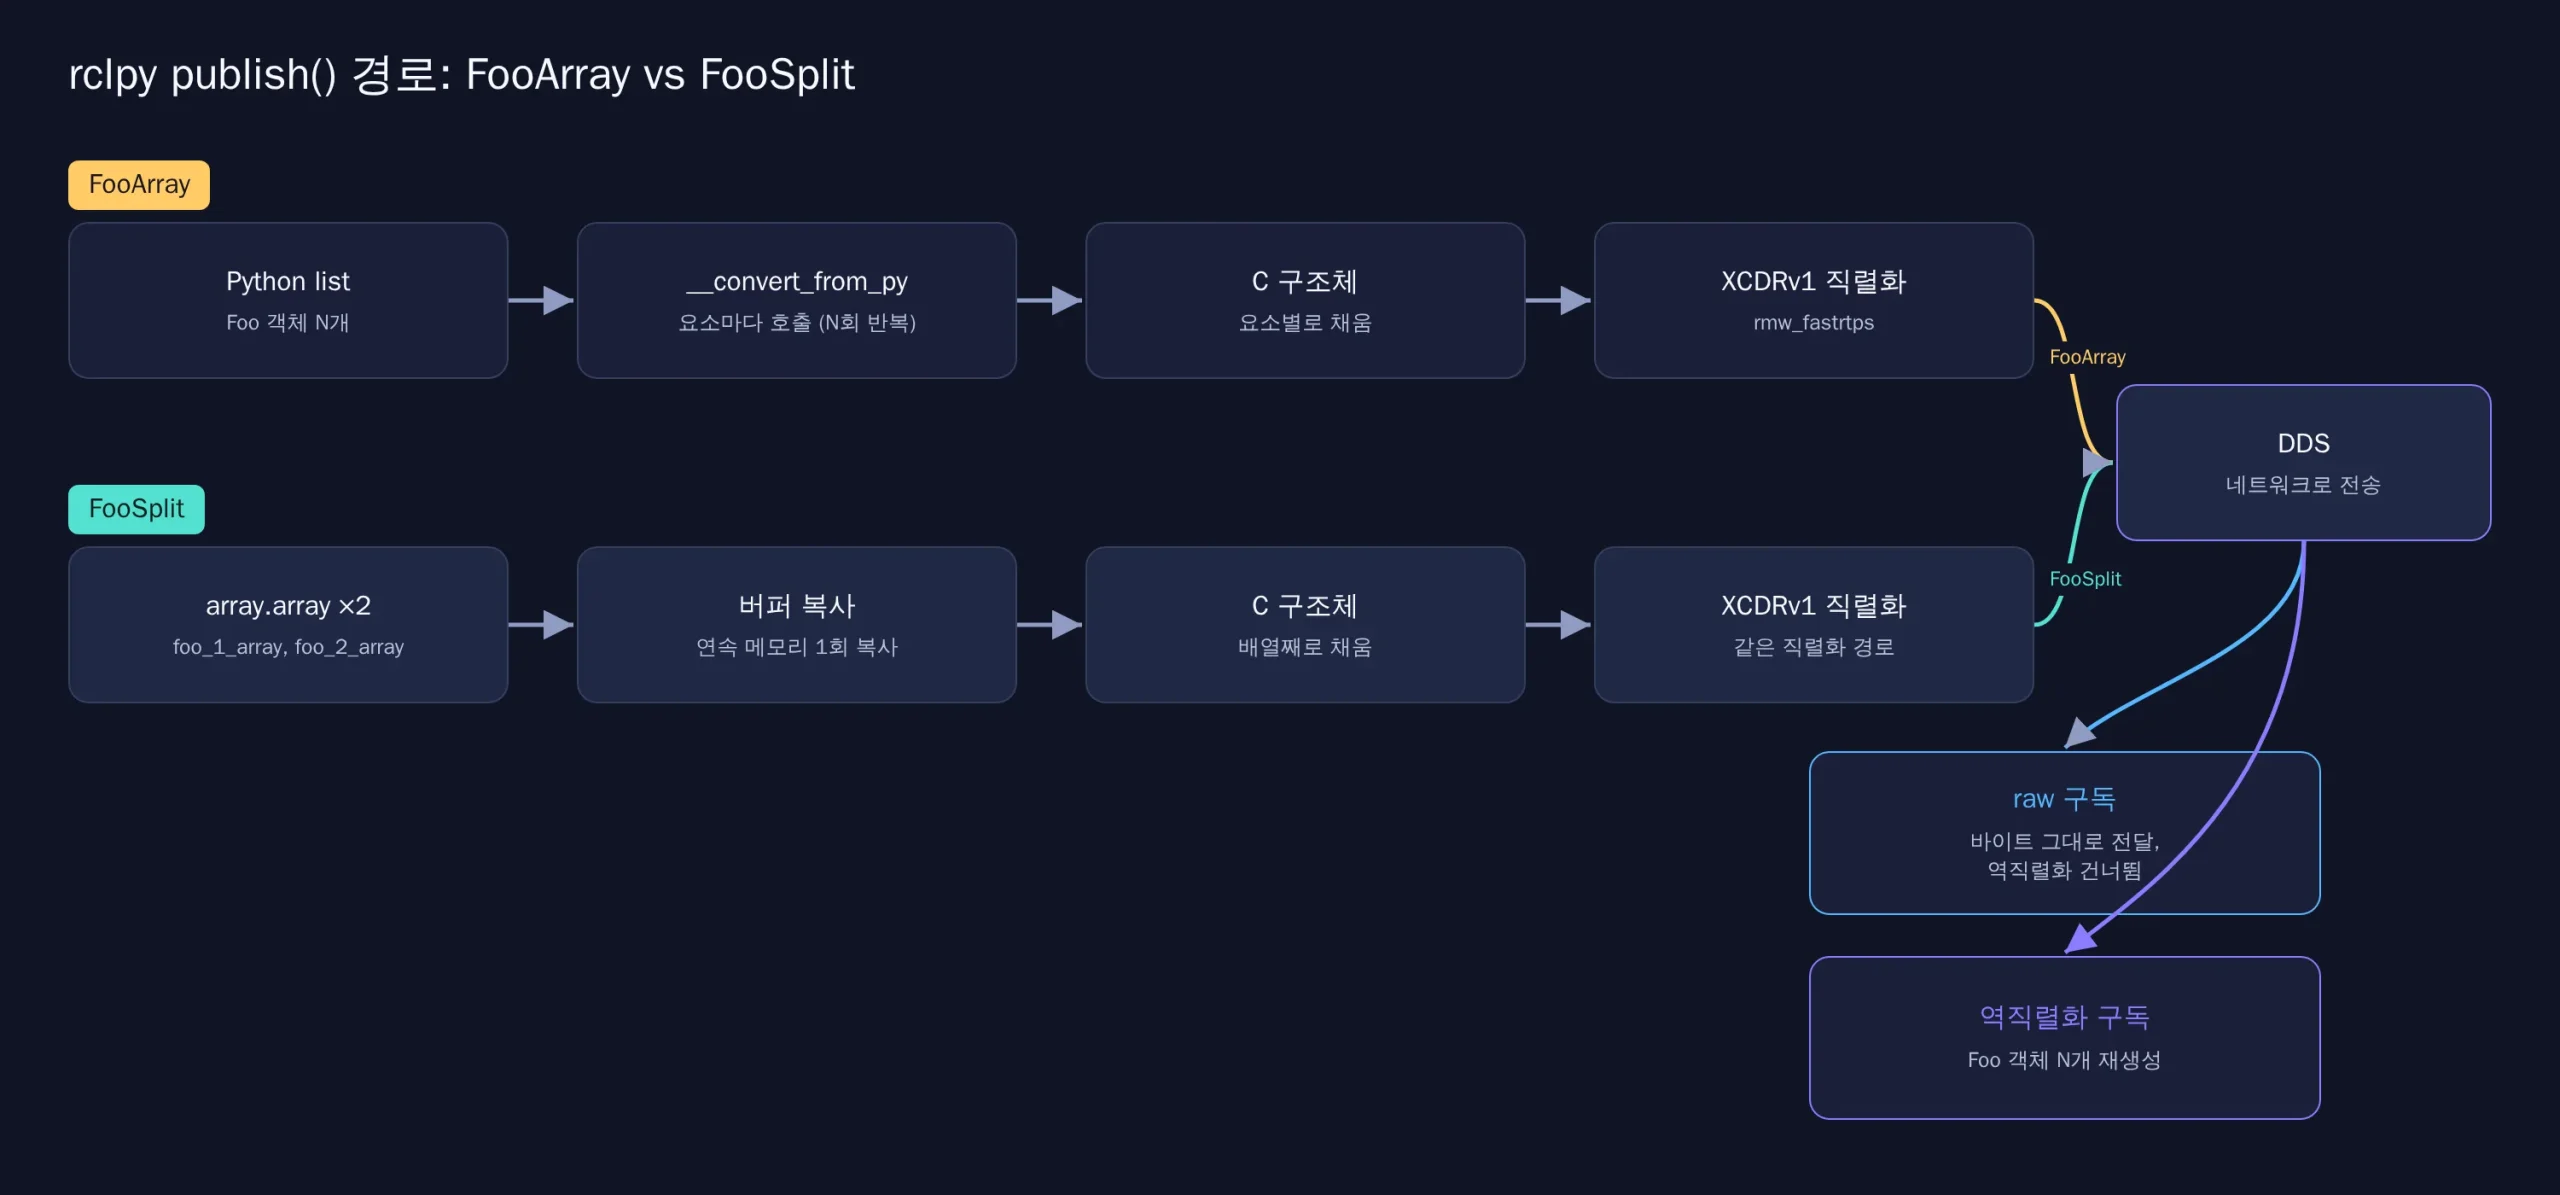
Python 노드에서는 그 앞에 단계가 하나 더 있다. Jazzy에 들어간 고정 버전 소스(rclpy 7.1.12, rosidl_python 0.22.2, rmw_fastrtps 8.4.4, Fast-CDR 2.2.8)를 2026년 10월 8일에 읽어 확인한 흐름은 이렇다.
- Python 쪽
publish()는 타입을 확인한 뒤 C 확장을 부른다. C 확장은convert_from_py로 Python 메시지를 C 구조체로 바꾼 다음rcl_publish()를 호출한다(rclpy publisher.cpp L122-L134). - 이 변환 코드는 메시지 정의에서 자동 생성된다. 비기본형 시퀀스는
for루프를 돌며 요소마다 해당 타입의__convert_from_py를 한 번씩 부른다(_msg_support.c.em L241-L247). 요소 안에Time이 있으면 그 변환 안에서Time변환이 한 번 더 일어난다. - 기본형 시퀀스는 “Optimization for converting arrays of primitives”라는 주석이 붙은 경로로 간다. Python 버퍼 프로토콜로 연속된 메모리를 한 번에 복사한다(_msg_support.c.em L256-L280). 생성된 Python 클래스가 숫자형 가변 배열을 리스트가 아니라
array.array(같은 타입의 숫자를 연속 메모리에 담는 표준 라이브러리 배열)로 보관하기 때문에 가능한 경로다(generate_py_impl.py L42-L53). - C 구조체를 바이트로 바꾸는 직렬화는 두 구조 모두
rmw_fastrtps가 XCDRv1 형식으로 한다(TypeSupport_impl.cpp L76-L83). - 받는 쪽 Python 콜백이 메시지 객체를 받으려면 반대 방향 변환을 거친다. 같은 템플릿의
__convert_to_py가 비기본형 시퀀스를 요소마다 돌며Foo객체 N개를 다시 만든다(_msg_support.c.em L642-L658). raw 구독(raw subscription, 역직렬화 없이 직렬화된 바이트를 그대로 넘겨받는 구독)은 이 단계를 건너뛴다.
비유하자면 Foo[]는 봉투 1만 장을 하나씩 뜯어 내용을 옮겨 적는 일이고, 기본형 배열 두 개는 표 두 장을 복사기에 통째로 넣는 일이다. 이 비유가 맞는 범위는 rclpy의 Python→C 변환까지다. 전송되는 바이트에 봉투 무게가 붙는 것은 아니고, 크기 차이는 아래의 정렬 규칙이라는 전혀 다른 이유로 생긴다. C++ 노드(rclcpp)의 경로는 이번에 소스를 확인하지 않았으므로 같은 비유를 그대로 옮기지 않는다.
크기 쪽 원리는 따로 있다. CDR(Common Data Representation)은 DDS가 쓰는 바이트 배치 규칙이고, Fast DDS가 쓰는 XCDRv1(확장 CDR 버전 1)에서는 8바이트 타입을 8의 배수 위치에 놓는다. 이를 정렬(alignment)이라 하고, 위치를 맞추느라 비는 자리를 채우는 빈 바이트를 패딩(padding)이라 한다. Fast-CDR 2.2.8 소스에서 XCDRv1이면 8바이트 타입의 정렬 단위가 8로 정해진다(Cdr.cpp L145-L159). Foo[]에서는 uint64(8) + uint32(4) 뒤에 다음 요소의 uint64를 맞추느라 4바이트가 비므로, 요소 하나가 사실상 16바이트를 차지한다. FooSplit은 uint64끼리, uint32끼리 붙어 있어 요소 사이 패딩이 없다.
전체 크기는 바이트를 앞에서부터 놓아 보면 손으로 셀 수 있다. 직렬화 결과 맨 앞에는 인캡슐레이션 헤더(encapsulation header, 뒤따르는 바이트가 어떤 CDR 형식으로 적혔는지 알리는 4바이트 표시)가 붙고, 정렬 위치는 이 헤더 다음 바이트를 0으로 놓고 센다. 가변 배열마다 앞에는 요소 개수를 적는 4바이트 길이 필드가 온다.
FooArray        = 헤더 4 + 길이 4 + 첫 uint64 앞 패딩 4 + 16N − 4(마지막 요소 뒤에는 패딩 없음)  = 16N + 8
FooSplit        = 헤더 4 + 길이 4 + 첫 uint64 앞 패딩 4 + 8N + 길이 4 + 4N                       = 12N + 16
FooStampedArray = 헤더 4 + 길이 4 + 패딩 4 + 24N − 4   (요소 = 8 + 4 + Time의 sec 4 + nanosec 4 = 20, 뒤에 패딩 4) = 24N + 8
FooStampedSplit = 헤더 4 + 길이 4 + 패딩 4 + 8N + (길이 4 + 4N) × 3                              = 20N + 24
길이 필드가 위치 0~3을 차지하므로, 8의 배수에서 시작해야 하는 첫 uint64는 위치 8로 밀리고 그 사이 4바이트가 빈다. 두 번째 배열부터는 4바이트 타입이라 길이 필드 뒤에 바로 붙는다. 이 식은 Fast-CDR 소스의 정렬 규칙에서 손으로 끌어낸 예측이고, 실측과 맞는지는 아래 표에서 N=0, 1, 2, 3, 10000으로 확인한다. 실제 전송 때 DDS 프로토콜과 UDP가 덧붙이는 헤더는 이 크기에 들어가지 않는다.
같은 값 1만 개를 Jazzy 컨테이너에서 다섯 번 쟀다
측정 스크립트 experiment.py 한 파일이 위의 세 .msg와 Time 변형 세 파일(FooStamped, FooStampedArray, FooStampedSplit)을 실행 중에 만들어 빌드한 뒤 잰다. 네 구조에는 같은 난수 값을 넣고, 두 구조의 값이 같은지(same_values)와 직렬화했다 되돌린 값이 원래와 같은지(roundtrip_equal)를 매번 확인한다. 시간은 time.perf_counter_ns(단조 시계, monotonic clock — 시스템 시각 조정에 흔들리지 않고 앞으로만 가는 고해상도 시계)로 쟀다. 메시지 구성·serialize_message·deserialize_message는 9회, raw 구독자만 연결한 publish()는 10회를 쟀고, 30 Hz 발행의 publish()는 1.2초 동안 실제로 발행한 14~37회를 모두 쟀다. 각각 중앙값과 p90(작은 쪽부터 90% 위치의 값)으로 남겼다. publish()는 미리 만든 메시지를 재사용해 메시지를 만드는 시간과 분리했다.
수신 쪽은 ros2 topic hz 명령 대신, 같은 방식으로 받는 구독자 두 개를 별도 프로세스로 띄웠다. 하나는 hz 기본 모드처럼 raw로 받고, 다른 하나는 hz의 --filter 모드처럼 Python 메시지로 역직렬화해 받는다. QoS도 hz와 같은 qos_profile_sensor_data다(best effort, 곧 재전송 없이 최신 메시지 위주로 보내는 설정). 처음 시험 실행에서는 두 구독을 한 프로세스에 두었는데, 하나의 executor(콜백을 꺼내 차례로 실행하는 실행기)에서 역직렬화 콜백이 raw 콜백까지 늦추는 바람에 두 모드의 수신 수가 똑같이 낮게 나왔다. 그래서 프로세스를 나눴다. 한 번 실행의 60초 예산에 맞추려고 반복 수를 11에서 9로, 30 Hz 발행 시간을 1.5초에서 1.2초로 줄인 것도 시험 실행 단계에서 한 조정이다.
측정 환경은 이미지 ros@sha256:066420e07f60aa18262f2479981def87ebcfcec42eefb0c0c57c4a46098348ca(ros:jazzy-ros-base), Python 3.12.3, rclpy 7.1.12-1noble.20260902.053513, rmw_fastrtps_cpp(기본값), --network none, CPU 1개, 메모리 1 GiB다. ROS_PYTHON_CHECK_FIELDS는 설정하지 않아 Python 필드 타입 검사가 꺼진 기본 상태였다. 하네스가 같은 조건으로 다섯 번 실행했고 다섯 번 모두 종료 코드 0이었다. 스크립트, 계획서와 실행별 원본 출력은 실험 공개 디렉터리에 있고, 원본 출력 파일은 results.json이다.
직접 돌려 보려면 Docker가 필요하다. 아래 명령은 고정 커밋의 스크립트를 내려받아 해시를 확인한 뒤, 하네스와 같은 고정 이미지와 자원 제한으로 실행한다.
mkdir foo-array-check && cd foo-array-check
curl -fsSLO https://raw.githubusercontent.com/sungpyo9053/blog/20a86cc119b224464b779e247d91cefd55b2cfb3/experiments/ros2-nested-message-array-vs-primitive-arrays-serialization/experiment.py
echo "e59c3d399c755971f789f0dd93376bc9de2984f7c749a9f723b258a6b93c9b10  experiment.py" | sha256sum -c
docker run --rm --network none --cpus 1 --memory 1g -v "$PWD":/work ros@sha256:066420e07f60aa18262f2479981def87ebcfcec42eefb0c0c57c4a46098348ca bash -c "source /opt/ros/jazzy/setup.bash && python3 /work/experiment.py"
하네스에서는 한 번 실행에 50초 남짓 걸렸고, 그중 대부분이 메시지 패키지 빌드였다. 정상이면 종료 코드 0으로 끝나고 마지막 줄의 kind가 done이다. size 줄의 same_values나 roundtrip_equal이 false면 그 실행의 비교는 무효다. 바이트 수는 같은 이미지라면 그대로 나와야 하고, 시간은 머신마다 다르다. 스크립트가 /tmp가 아닌 /var/tmp에서 빌드하는 이유는 하네스의 /tmp가 실행 금지(noexec)로 마운트돼 있어 빌드한 공유 라이브러리를 불러오지 못하기 때문이다.
직렬화 크기: 예측식과 실측 (바이트, 다섯 번 실행 모두 같은 값)
| N | FooArray 예측 / 실측 | FooSplit 예측 / 실측 | FooStampedArray 예측 / 실측 | FooStampedSplit 예측 / 실측 |
|---|---|---|---|---|
| 0 | 8 / 8 | 16 / 16 | 8 / 8 | 24 / 24 |
| 1 | 24 / 24 | 28 / 28 | 32 / 32 | 44 / 44 |
| 2 | 40 / 40 | 40 / 40 | 56 / 56 | 64 / 64 |
| 3 | 56 / 56 | 52 / 52 | 80 / 80 | 84 / 84 |
| 10000 | 160008 / 160008 | 120016 / 120016 | 240008 / 240008 | 200024 / 200024 |
N=10000에서 스크립트가 메시지 객체를 순회해 센 비기본형 요소 수는 FooArray 10000, FooSplit 0, FooStampedArray 20000, FooStampedSplit 0이었다. 선언 필드 바이트는 120000, 120000, 200000, 200000이었다. 모든 N과 모든 실행에서 same_values와 roundtrip_equal은 true였다.
N=10000 처리 시간: 실행별 중앙값의 최소~최대 (µs, 다섯 번 실행)
| 단계 | FooArray | FooSplit | FooStampedArray | FooStampedSplit |
|---|---|---|---|---|
| 메시지 구성 | 9422.2~10696.3 | 458.1~461.6 | 32155.3~32701.6 | 949.8~970.6 |
serialize_message |
9389.7~10245.2 | 24.0~25.7 | 19566.9~20608.1 | 33.6~44.6 |
publish() (raw 구독자만 연결, 10회 발행) |
9888.7~10882.6 | 237.8~254.2 | 19692.8~21239.2 | 302.5~317.7 |
deserialize_message |
17640.9~18520.7 | 20.4~22.5 | 51831.4~78514.7 | 32.8~36.1 |
FooStampedArray 역직렬화의 최댓값 78514.7은 4번째 실행에서만 나왔고, 나머지 네 번은 51831.4~52535.5였다. FooSplit을 array.array 대신 Python 리스트로 채웠을 때의 구성 시간 중앙값은 446.6~566.4였다.
30 Hz 목표로 1.2초 발행 (raw 구독자와 역직렬화 구독자 프로세스가 같은 CPU 1개를 나눠 씀)
| 항목 | FooArray | FooSplit | FooStampedArray | FooStampedSplit |
|---|---|---|---|---|
| 실제 발행 수 / 주기(Hz) | 31~34 / 24.96~27.99 | 37 / 30.82 | 14~17 / 10.74~13.5 | 37 / 30.82 |
publish() 중앙값(µs) |
19175.3~22222.7 | 270.0~1467.9 | 89166.4~91735.1 | 334.0~418.0 |
budget_share_median |
0.575~0.667 | 0.008~0.044 | 2.675~2.752 | 0.01~0.013 |
| raw 구독: 받은 수 / 발행 수 | 1.0 | 1.0 | 1.0 | 1.0 |
| raw 구독 주기(Hz) | 24.41~27.4 | 30.0~30.01 | 10.18~12.94 | 29.99~30.11 |
| 역직렬화 구독: 받은 수 / 발행 수 | 0.676~0.806 | 1.0 | 0.647~0.75 | 0.946~1.0 |
| 역직렬화 구독 주기(Hz) | 15.39~17.93 | 29.99 | 5.88~7.66 | 32.55~33.13 |
budget_share_median은 publish() 중앙값에 30을 곱한 값으로, 1이면 publish() 한 번이 30 Hz의 한 주기를 다 쓴다는 뜻이다. FooSplit의 publish() 중앙값 1467.9는 5번째 실행에서만 나왔고 나머지는 270.0~358.4였다.
raw 구독자만 연결한 10회 발행에서 FooArray는 2·5번째 실행에서 워밍업 포함 11개 중 10개만 도착했다. 2·3·5번째 실행에서는 수신 주기가 91.98~95.46 Hz로 찍혔다. 이 주기는 첫 도착과 마지막 도착 사이 간격으로 계산하므로, 30 Hz 간격으로 보낸 메시지가 몰려 도착했다는 뜻이다. 나머지 세 구조는 모든 실행에서 11개가 다 왔고 주기는 29.95~30.05 Hz였다.
1번째 실행의 원본 출력 일부(JSON 줄 그대로):
{"kind":"env","rmw":"rmw_fastrtps_cpp","ROS_PYTHON_CHECK_FIELDS":null,"RMW_FASTRTPS_PUBLICATION_MODE":null,"python":"3.12.3","cpu_count":2}
{"kind":"size","N":10000,"serialized_bytes":{"FooArray":160008,"FooSplit":120016,"FooStampedArray":240008,"FooStampedSplit":200024},"non_primitive":{"FooArray":10000,"FooSplit":0,"FooStampedArray":20000,"FooStampedSplit":0},"field_bytes":{"FooArray":120000,"FooSplit":120000,"FooStampedArray":200000,"FooStampedSplit":200000},"same_values":true,"roundtrip_equal":true}
{"kind":"publish_solo","type":"FooArray","N":10000,"publish":{"n":10,"median_us":9888.7,"p90_us":10239.0}}
{"kind":"publish_solo","type":"FooSplit","N":10000,"publish":{"n":10,"median_us":243.1,"p90_us":267.1}}
{"kind":"publish_paced","type":"FooArray","N":10000,"target_hz":30,"sent":31,"achieved_hz":25.83,"publish":{"n":31,"median_us":20465.1,"p90_us":71889.8},"budget_share_median":0.614}
{"kind":"publish_paced","type":"FooSplit","N":10000,"target_hz":30,"sent":37,"achieved_hz":30.82,"publish":{"n":37,"median_us":272.4,"p90_us":1513.4},"budget_share_median":0.008}
{"kind":"receive","topic":"rate_fooarray","sent":31,"raw":{"count":31,"arrived_incl_warmup":32,"rate_hz":25.18,"share_of_sent":1.0},"deserialized":{"count":25,"arrived_incl_warmup":26,"rate_hz":17.93,"share_of_sent":0.806}}
{"kind":"receive","topic":"rate_foosplit","sent":37,"raw":{"count":37,"arrived_incl_warmup":38,"rate_hz":30.01,"share_of_sent":1.0},"deserialized":{"count":37,"arrived_incl_warmup":38,"rate_hz":29.99,"share_of_sent":1.0}}
cpu_count가 2로 찍힌 것은 os.cpu_count()가 컨테이너 제한이 아닌 호스트 값을 보일 수 있어서다. CPU 사용량 자체는 --cpus 1로 묶여 있었다.
표를 읽는 법: 크기는 원인이 아니었고, 수신은 모드에 따라 갈렸다
크기부터 보면, 정렬 규칙으로 센 예측식이 N=0부터 10000까지 모두 맞았다. 계산 전에 확신하지 못했던 N=0의 경우, 즉 빈 uint64 시퀀스 앞에도 정렬 패딩이 들어가는지도 예측과 같았다. “필드 바이트가 같으니 크기도 같다”는 판단은 틀렸고, Foo[]는 요소마다 4바이트를 더 쓴다. 그렇다고 이 크기 차이를 시간 차이의 원인으로 읽으면 안 된다. 네 배열로 나눈 FooStampedSplit은 직렬화 결과가 FooArray보다 큰데도 publish()는 수십 배 빨랐다. 시간을 가른 것은 바이트 수보다 비기본형 요소가 있느냐였다.
발행 시간에서는 Foo[]의 publish()가 같은 메시지의 serialize_message와 거의 같은 크기로 나왔다. 두 함수 모두 먼저 convert_from_py를 거치므로(rclpy serialization.cpp L53-L78), 요소별 Python→C 변환이 대부분을 차지한다는 해석과 맞는다. 다만 변환과 DDS 직렬화를 따로 떼어 재지는 않았으니 몫을 단정하지는 않는다. 비기본형 요소가 두 배인 FooStampedArray는 publish()도 두 배 가까이 걸렸다. N=10000 한 점에서 본 관측이라 “요소 수에 비례한다”는 결론까지는 가지 못한다. 기본형 배열 쪽은 publish()가 serialize_message보다 오히려 길었는데, 그 나머지는 DDS로 넘기는 쪽의 비용으로 보이지만 이번 실험에서 나누어 재지 않았다.
수신은 30 Hz 발행에 역직렬화 구독자를 붙이자 양상이 달라졌다. CPU 하나를 발행자와 두 구독자가 나눠 쓰는 조건에서 Foo[] 발행자의 publish() 중앙값은 raw 구독자만 있을 때의 두 배쯤으로 늘었고, 목표 30 Hz를 채우지 못했다. FooStampedArray는 publish() 한 번이 30 Hz의 한 주기보다 길어졌다. 기본형 배열 두 구조는 같은 조건에서도 30 Hz를 지켰다.
이때 raw 구독자는 모든 실행에서 발행된 메시지를 빠짐없이 받았고, 그 주기는 발행자가 실제로 낸 주기와 거의 같았다. raw 쪽 주기가 30 Hz보다 낮았던 이유는 받는 쪽이 아니라 발행자가 정말로 느려졌기 때문이다. Jazzy의 ros2 topic hz는 --filter를 주지 않으면 raw로 구독하므로(hz.py L264-L269), 비슷한 상황에서 hz가 낮다면 발행 측부터 의심할 근거가 된다. 반면 역직렬화 구독자는 Foo[]와 FooStampedArray에서 발행된 메시지의 일부를 받지 못했다. best effort 큐에서 밀려났는지 콜백이 늦어 버려졌는지는 이 실험이 가르지 않는다.
문서의 hz 경고는 2021년 rmw_cyclonedds #346에서 hz가 받은 메시지를 Python 객체로 바꾸는 데 시간 대부분을 쓴다는 분석이 나온 뒤, ros2_documentation PR #2096으로 2021년 11월에 추가됐다. 지금의 hz 기본 모드에 그 설명을 그대로 붙이기는 어렵다. 역직렬화를 거치는 --filter 모드나 직접 만든 Python 구독 콜백이라면 이번 측정처럼 수신 수가 발행 수보다 적어질 수 있다.
도착 간격으로 계산한 주기는 도착이 몰리면 실제 발행 주기보다 높게 나온다. raw 구독자만 연결한 FooArray 측정에서 30 Hz 발행이 90 Hz대로 찍힌 실행이 있었고, FooStampedSplit의 역직렬화 구독 주기도 30 Hz를 넘었다. 주기 숫자 하나보다 몇 개를 보내 몇 개를 받았는지를 함께 보는 편이 안전하다.
이 숫자를 그대로 옮기면 안 되는 곳
- 언어와 RMW: rclpy와
rmw_fastrtps_cpp만 쟀다. C++ 노드의std::vector<Foo>경로나 Cyclone DDS·Zenoh 같은 다른 RMW는 소스도 측정도 확인하지 않았다. “C++에서도 수십 배”라고 옮기면 근거가 없다. - 환경: 컨테이너 하나, 네트워크 없음, CPU 1개다. DDS 튜닝 문서의 원래 맥락인 WiFi·손실 링크·여러 호스트를 대표하지 않는다. 30 Hz 발행의
publish()시간에는 같은 CPU를 쓰는 구독자와의 경합이 섞여 있어, 구독자가 다른 컴퓨터에 있으면 값이 달라진다. 로봇에 흔한 저전력 ARM 보드에서도 절대값은 따로 재야 한다. - 표본: 항목마다 시간 표본이 9~37개이고, 시간 측정의 N은 10000 하나뿐이다. 중앙값과 p90 이상을 읽어 내지 않는다.
- 도구:
ros2 topic hz명령 자체는 실행하지 않고 같은 방식으로 받는 구독자 두 개로 대신했다. - 실물: 로봇·시뮬레이터·액추에이터는 쓰지 않았다. 측정은 메시지 처리 경로에 한정된다.
내 토픽에서 구조를 바꿀지 정하는 순서
- 메시지 정의에서 비기본형 가변 배열을 찾아 위의 식으로 초당 비기본형 요소 수를 센다.
Time처럼 이름은 기본형 같아도 실제로는 메시지인 필드를 빠뜨리지 않는다. - 그 토픽을 Python 노드가 발행하거나 구독하는지 확인한다. 이 글이 소스로 확인한 요소별 변환은 rclpy 경로다.
- 같은 값·같은 N·같은 주기로 두 구조를 만들어
publish()시간을 발행 주기와 비교한다.budget_share_median처럼 “publish()한 번이 한 주기의 몇 배인가”로 적어 두면 판단이 빨라진다. - 수신 쪽은 raw와 역직렬화를 나눠 보낸 수와 받은 수를 센다. hz 숫자 하나로 결론을 내리지 않는다.
나누면 잃는 것도 있다. FooSplit에서는 i번째 foo_1과 i번째 foo_2가 같은 요소라는 사실을 인덱스로만 지킨다. 두 배열의 길이가 달라져도 메시지 정의는 막아 주지 않으니, 발행 직전에 길이를 확인하는 코드가 필요하다. 요소가 적거나 주기가 낮아 publish()가 주기에 비해 충분히 짧다면 읽기 쉬운 Foo[]를 유지하는 쪽이 합리적이다.
실제 로봇의 토픽 정의를 바꿀 때는 그 토픽을 쓰는 모든 발행·구독 노드를 함께 다시 빌드해야 한다. 정의가 다른 노드끼리는 타입이 맞지 않아 통신이 되지 않는다. 제어 명령이 오가는 토픽이라면 로봇을 정지시킨 상태나 시뮬레이션에서 먼저 바꿔 확인한다. 이 순서는 편집 권고이며 실물 로봇에서 검증한 것은 아니다.
확인 문제
설명용 가상 토픽이다. 레이더 탐지 결과를 Detection.msg(float32 x, float32 y, builtin_interfaces/Time stamp)로 정의하고, Detection[] detections에 메시지당 500개씩 담아 20 Hz로 보낸다.
문제 1. 메시지당, 초당 비기본형 요소 수는 얼마인가? float32[] x, float32[] y, int32[] stamp_sec, uint32[] stamp_nanosec 네 배열로 나누면 어떻게 되나?
답: 요소 하나에 Detection과 Time이 하나씩 있으니 500 × 2 = 1000개, 초당 1000 × 20 = 20000개다. 네 기본형 배열로 나누면 0이다. 선언 필드 바이트는 어느 쪽이든 500 × (4 + 4 + 4 + 4) = 8000바이트로 같다. 앞에서 센 Foo[] 예제(초당 300000개)보다 훨씬 작으므로, 이 수만 보고 구조를 바꾸지 말고 publish() 시간을 20 Hz의 한 주기와 비교해 정한다.
문제 2. 이 토픽에서 ros2 topic hz(필터 없음)는 20 Hz 가까이 나오는데, Python으로 만든 구독 노드의 콜백은 그보다 적게 불린다. 먼저 어디를 봐야 하나?
답: 필터 없는 hz는 raw로 받아 역직렬화를 하지 않는다. hz가 20 Hz 가까이 나온다면 발행 측은 주기를 지키고 있고, 줄어든 쪽은 메시지를 Python 객체로 바꾸는 수신 측이다. 구독 콜백의 처리 시간과 QoS 큐 설정을 먼저 보고, 같은 데이터를 기본형 배열로 나눴을 때의 역직렬화 시간을 재 본다. 이번 측정에서도 raw 구독은 모두 받았지만 역직렬화 구독은 Foo[]에서 일부를 놓쳤다. 메시지가 아예 오지 않는다면 QoS 호환성부터 따져야 하는데, 그 계산은 ROS 2 토픽 이름이 같은데 메시지가 안 올 때: QoS 호환성을 먼저 계산하기에서 다뤘다.
다음 단계로는 공개된 experiment.py를 같은 고정 이미지로 한 번 돌려, 자기 머신에서 publish_solo 줄의 두 구조 차이가 어느 정도인지 확인해 보면 된다. 이 글에는 제휴·협찬 관계가 없다.
참고 링크
모두 2026년 10월 8일에 확인했다.
- ROS 2 Jazzy — Addressing common DDS tuning issues, 해당 문단의 고정 커밋 원문 DDS-tuning.rst L66-L90, rolling 브랜치 원문 DDS-tuning.rst
- ROS 2 Jazzy — About-Interfaces.rst L189 (complex type 정의), Creating custom msg and srv files (중첩 메시지 정의)
- rosidl_python 0.22.2 — _msg_support.c.em (요소별 변환과 기본형 버퍼 복사)
- rclpy 7.1.12 — publisher.cpp
- rmw_fastrtps 8.4.4 — TypeSupport_impl.cpp, Fast-CDR v2.2.8 — Cdr.cpp
- ros2cli jazzy — hz.py
- HuntLab 자료: 산술 예제 example.py, 검산 기록 verification.json, 측정 스크립트 experiment.py, 실행별 원본 출력 results.json