피지컬 AI 작동 원리: 관측·행동·피드백을 숫자로 이해하기
목표 위치는 1m인데 실제로는 0.9m에서 멈췄다. 그런데 센서는 “1m에 도착했다”고 읽는다. 이 설명용 상황에서 피지컬 AI 작동 원리를 이해하려면, 화면에 나온 숫자와 실제 위치부터 나눠 봐야 한다. 같은 구분이 로봇의 판단과 행동을 읽는 출발점이다.
관측과 실제 위치를 나누면 행동을 멈춘 이유도 계산할 수 있다. 변수·조건문·사칙연산으로 따라갈 수 있는 작은 이동 규칙부터 살펴본다. 근거는 2026년 9월 16일 확인한 공식 문서와 연구팀 설명이며, 예제는 실제 로봇이나 물리 시뮬레이터가 아닌 계산 모델이다.
피지컬 AI를 이해하는 작은 입구
피지컬 AI(Physical AI)는 물리 세계를 인식하고 판단하며 작용하는 AI 시스템을 가리킬 때 쓰는 말이다. NVIDIA의 용어집은 로봇뿐 아니라 자율주행차, 카메라를 활용한 시스템도 함께 다룬다. 이 업체의 설명을 모든 연구자가 공유하는 단일 표준 정의로 읽을 필요는 없다.
여기서는 그 넓은 범위 중 환경에서 정보를 얻고 행동을 정하고 달라진 환경을 다시 확인하는 과정에 집중한다. 거대한 모델부터 설치할 필요는 없다. 우선 아래 흐름에서 어떤 값이 어디로 전달되는지 구분하면 된다.
환경의 상태 → 센서가 얻은 관측 → 정책이 정한 행동
     ↑                              ↓
     └──────── 행동 뒤의 환경 ────────┘
화살표는 읽는 순서다. 센서가 정보를 읽고 정책이 입력을 선택하고 그 입력이 환경에 작용한다. 바뀐 환경을 다시 읽으면 결과가 다음 판단으로 돌아온다. 이처럼 결과를 되돌려 쓰는 구조를 피드백(feedback)이라고 한다.
환경을 거쳐 결과가 다시 입력으로 돌아오는 이 구조를 폐루프(closed loop)라고도 부른다. 이 흐름 자체가 새로운 AI 기술이거나 학습의 증거는 아니다. 고정된 규칙으로도 피드백을 만들 수 있다. 뒤의 예제가 바로 그런 경우다.
다섯 용어를 같은 장면에 붙여 보자
일직선 위의 점을 0m에서 1m로 옮긴다고 생각하자. 지금은 실제 로봇 대신 위치만 있는 단순한 계산 모델을 쓴다.
| 용어 | 이 예제에서 뜻하는 것 | 혼동하면 안 되는 것 |
|---|---|---|
| 상태(state) | 모델 안에서의 실제 위치 x |
센서가 읽은 숫자와 항상 같지는 않다 |
| 관측(observation) | 시스템이 입력으로 받은 위치 o |
측정 정보가 곧 완전한 상태는 아니다 |
| 목표(reference/target) | 도달하려는 위치 r = 1m |
현재 위치나 이미 달성한 결과가 아니다 |
| 행동(action) | 이번 단계에 요청하는 위치 변화 a |
“목표에 도착했다”라는 성공 결과가 아니다 |
| 정책(policy) | 관측과 목표를 보고 행동을 정하는 규칙 | 반드시 학습된 신경망이어야 하는 것은 아니다 |
Spinning Up의 기초 문서는 상태와 관측을 구분하고, 정책을 행동을 선택하는 규칙으로 설명한다. 여기서는 그 구분을 작은 위치 모델에 적용했다. 실제 시스템의 정책은 현재 관측 외에 과거 관측이나 내부 기억을 함께 사용할 수도 있다.
“상태는 실제 위치”라는 설명은 이 예제에만 해당한다. 관성이 있는 이동체라면 같은 0.9m에 있어도 정지 중인지, 앞으로 빠르게 움직이는지에 따라 다음 움직임이 달라진다. 위치만 같다고 같은 상태는 아닌 셈이다. MIT의 로봇 제어 강의 노트는 역학 상태를 설명할 때 위치와 속도를 함께 다룬다.
실제 장치로 옮기면 센서(sensor)는 위치처럼 필요한 물리량을 읽고, 액추에이터(actuator)는 모터처럼 명령을 물리 작용으로 바꾼다. 제어기(controller)는 목표와 측정 정보 등을 이용해 시스템에 보낼 입력을 정한다. 정책이 목표를 정하고 하위 제어기가 구동을 맡을 수 있지만, 정책과 제어기가 항상 두 별도 부품이어야 하는 것은 아니다. 같은 피드백 규칙을 어느 분야에서는 정책, 다른 맥락에서는 제어 법칙이라고 부르기도 한다. ros2_control의 구조 설명에서도 하드웨어 읽기, 제어기 출력 갱신, 명령 쓰기를 구분한다.
1m로 가는 규칙을 직접 계산한다
정책을 말로 먼저 정해 보자. 남은 거리의 절반만 움직이되, 한 단계의 이동 요청은 양쪽 방향 모두 0.2m를 넘지 않는다. 멀리 있으면 0.2m씩 이동하고, 가까워지면 요청량이 작아지는 규칙이다.
이를 적으면 다음과 같다. t는 단계 번호이며 t+1은 바로 다음 단계다.
행동 a_t = clamp(0.5 × (목표 r - 관측 o_t), -0.2m, +0.2m)
다음 위치 x_(t+1) = 현재 위치 x_t + 행동 a_t
clamp는 값을 정해진 구간 안으로 잘라 넣는 연산이다. 0.5m를 요청하면 0.2m로 줄이고, -0.5m라면 -0.2m로 줄인다. -0.1m처럼 구간 안의 값은 그대로 둔다. 음수는 반대 방향을 뜻한다.
계산을 시작하기 전에 두 가지를 가정한다. 센서는 위치를 정확하게 읽어서 o_t = x_t이고, 명령한 변화량만큼 곧바로 이동한다. a_t의 단위는 m이며 속도나 힘이 아니다. 이 단순화 덕분에 모터와 충돌을 모델링하지 않고 숫자의 흐름만 볼 수 있다.
| 단계 | 관측 위치(m) | 남은 거리(m) | 요청한 변화량(m) | 다음 위치(m) |
|---|---|---|---|---|
| 0 | 0 | 1 | 0.2 | 0.2 |
| 1 | 0.2 | 0.8 | 0.2 | 0.4 |
| 2 | 0.4 | 0.6 | 0.2 | 0.6 |
| 3 | 0.6 | 0.4 | 0.2 | 0.8 |
| 4 | 0.8 | 0.2 | 0.1 | 0.9 |
| 5 | 0.9 | 0.1 | 0.05 | 0.95 |
| 6 | 0.95 | 0.05 | 0.025 | 0.975 |
첫 단계에서는 남은 거리 1m의 절반이 0.5m다. 하지만 상한이 0.2m이므로 다음 위치는 0.2m다. 위치가 0.8m가 되면 계산이 달라진다. 남은 거리 0.2m의 절반인 0.1m는 상한보다 작으므로 그대로 이동해 0.9m가 된다.
여기서 “성공했다”의 뜻도 정해야 한다. 이 예제에서는 실제 위치와 목표의 차이가 0.025m 이하면 성공으로 두었다. 7번 갱신한 뒤 위치는 0.975m이고 차이는 0.025m이므로 이 기준을 충족한다. 1m에 정확히 도착했다는 뜻은 아니다. 기준을 설명하지 않고 “7단계 만에 성공”이라고만 쓰면 서로 다른 결과를 떠올리게 된다.
코드로 표의 산술만 확인하기
예제의 산술은 Python 3.12.9로 검산했다. Python 3.12가 이미 설치된 환경이라면 외부 패키지나 로봇 라이브러리 없이 아래 코드를 실행할 수 있다. python3 --version으로 버전을 확인하고, 코드를 빈 폴더의 feedback_example.py에 저장한 뒤 python3 feedback_example.py로 실행한다. 계산만 수행하며 파일을 만들거나 장치에 명령을 보내지 않는다.
Fraction(1, 5)는 1/5을 뜻한다. 소수의 반올림 대신 분수로 검산하기 위해 Python 표준 라이브러리를 사용했다. assert는 계산이 적힌 조건과 다르면 실행을 멈추는 검사다.
from fractions import Fraction as F

x = F(0)
target, limit, gain = F(1), F(1, 5), F(1, 2)
positions = []
for step in range(7):
    observation = x
    action = max(-limit, min(limit, gain * (target - observation)))
    x = x + action
    positions.append(x)

assert positions == [F(1, 5), F(2, 5), F(3, 5), F(4, 5),
                     F(9, 10), F(19, 20), F(39, 40)]
assert target - x == F(1, 40)
print("position:", x, "gap:", target - x)

x = F(9, 10)
observation = x + F(1, 10)
action = max(-limit, min(limit, gain * (target - observation)))
assert observation == target and action == 0 and x != target
print("observed:", observation, "action:", action, "actual_gap:", target - x)
검산 출력은 다음과 같다. 정상 종료 코드는 0이다. 첫 줄의 39/40은 0.975m, 1/40은 0.025m다. 두 번째 줄은 다음 절에서 다룰 오차 사례다.
position: 39/40 gap: 1/40
observed: 1 action: 0 actual_gap: 1/10
표와 다른 값을 넣으면 AssertionError로 계산 차이를 드러내도록 했다. 이 검사가 통과한다는 것은 정한 수식과 기대한 값이 일치한다는 뜻이지, 실제 로봇에서도 그대로 움직인다는 뜻은 아니다.
센서가 맞다고 말해도 실제로는 틀릴 수 있다
이번에는 규칙을 바꾸지 않고 관측만 바꾼다. 센서가 언제나 실제 위치보다 0.1m 크게 읽는다고 가정하자. 이것은 실제 센서에서 발견한 고장이 아니라, 관측과 상태의 차이를 보기 위해 직접 정한 측정 편향(bias) 사례다.
실제 위치가 0.9m라면 관측은 0.9 + 0.1 = 1m다. 정책이 보는 남은 거리는 1 - 1 = 0m이므로 행동도 0이다. 실제 목표까지는 아직 0.1m 남았는데 움직이지 않는다. 코드의 마지막 네 줄은 바로 이 계산을 확인한다.
| 무엇을 기준으로 보나 | 목표와의 차이 | 해석 |
|---|---|---|
| 센서가 보고한 위치 1m | 0m | 정책은 움직일 필요가 없다고 계산한다 |
| 실제 위치 0.9m | 0.1m | 허용 오차 0.025m를 넘으므로 실제 성공이 아니다 |
피드백은 결과를 다시 이용하게 해 주지만, 돌아오는 정보가 정확하다고 보장하지는 않는다. 따라서 반복해서 읽었다는 사실만으로 센서의 정확도나 작업의 성공을 판정할 수 없다. 이 예제에서 중요한 점검 질문은 “명령을 보냈나?”보다 “무엇을 측정했고, 그 값으로 무엇까지 확인할 수 있나?”다.
계산 모델 밖에서는 관성, 시간 지연, 충돌, 힘과 속도의 한계도 고려해야 한다. 앞의 0.2m는 계산을 위한 제한값이며 안전한 로봇 설정값이 아니다. 실물의 제동이나 센서 교정을 이 규칙으로 처리하려는 용도에는 맞지 않는다.
다시 보고 움직이는 것과 배우는 것은 다르다
표에서는 목표에 가까워질수록 행동이 0.2m에서 0.1m, 0.05m로 줄었다. 하지만 gain = 1/2와 이동 상한은 처음부터 끝까지 같았다. 달라진 입력에 고정된 규칙을 적용했을 뿐, 규칙 자체를 학습한 것은 아니다.
정책을 학습한다는 말은 이 행동 선택 규칙을 만드는 값이나 구조를 데이터와 학습 절차로 조정한다는 뜻으로 구분해서 읽으면 된다. 새 관측으로 다음 행동을 계산하는 과정과 경험으로 정책을 바꾸는 과정은 같은 질문이 아니다. 학습된 정책도 실행할 때 피드백을 사용할 수 있고, 학습하지 않은 규칙도 피드백으로 동작할 수 있다.
더 복잡한 사례로 넘어가면 관측이 위치 하나가 아니라 이미지가 되고, 행동을 정하는 규칙이 학습 모델이 될 수 있다. 2023년 RT-2 연구는 이미지·언어 지시와 로봇 행동을 연결하는 시각·언어·행동 모델, 즉 VLA(Vision-Language-Action)의 사례다. 연구팀 설명에는 모델의 출력을 로봇 행동으로 바꾸고 다시 관측하는 폐루프 제어가 나온다. 이는 외부 연구의 설명이며, 이 글에서 RT-2를 실행하거나 재현한 것은 아니다.
계산을 넘겨받을 수 있는지 확인한다
다음 질문에 답하면 용어를 외운 것과 값의 흐름을 이해한 것을 구분할 수 있다. 답을 보기 전에 표와 수식만으로 먼저 계산해 보자.
- 센서가 정확하고 위치가 0.8m라면 다음 행동과 다음 위치는 얼마인가?
- 실제 위치 0.9m를 센서가 1m로 읽어 행동이 0이 됐다. 이 예제의 성공 기준을 충족했는가?
- 매 단계 행동량이 작아졌다. 이 사실만으로 정책이 학습했다고 말할 수 있는가?
답과 이유
- 행동은 0.1m, 다음 위치는 0.9m다. 남은 거리 0.2m의 절반은 상한보다 작다.
- 아니다. 실제 오차 0.1m가 허용 오차 0.025m보다 크다. 관측값이 목표와 같다는 판단만으로는 부족하다.
- 아니다. 정책의 계수와 상한은 고정이다. 입력이 바뀌어 출력이 달라진 피드백 동작이다.
다음에 로봇 데모나 라이브러리 예제를 볼 때는 모델 이름보다 입력과 출력부터 확인해 보자. 관측에 무엇이 들어 있는지, 행동이 위치·속도·힘 중 무엇을 뜻하는지, 성공을 어떤 값으로 판정하는지 읽으면 설명에서 빠진 조건이 보인다.
위치 값의 의미를 더 살펴보려면 같은 점의 좌표가 기준에 따라 달라지는 이유로 이어진다. 측정값의 흔들림을 줄이는 쪽이 궁금하다면 이동평균의 오차와 반응 지연 실습에서 편향과 잡음의 차이를 확인할 수 있다.
이 흐름을 코드의 입출력으로 이어 보고 싶다면 Gymnasium의 Basic Usage에서 action_space, observation_space, step을 살펴볼 수 있다. 각각 허용하는 행동, 받을 수 있는 관측, 행동 뒤의 새 관측을 다룬다. 이 글의 위치 계산을 이해하는 데 그 라이브러리를 설치할 필요는 없다.
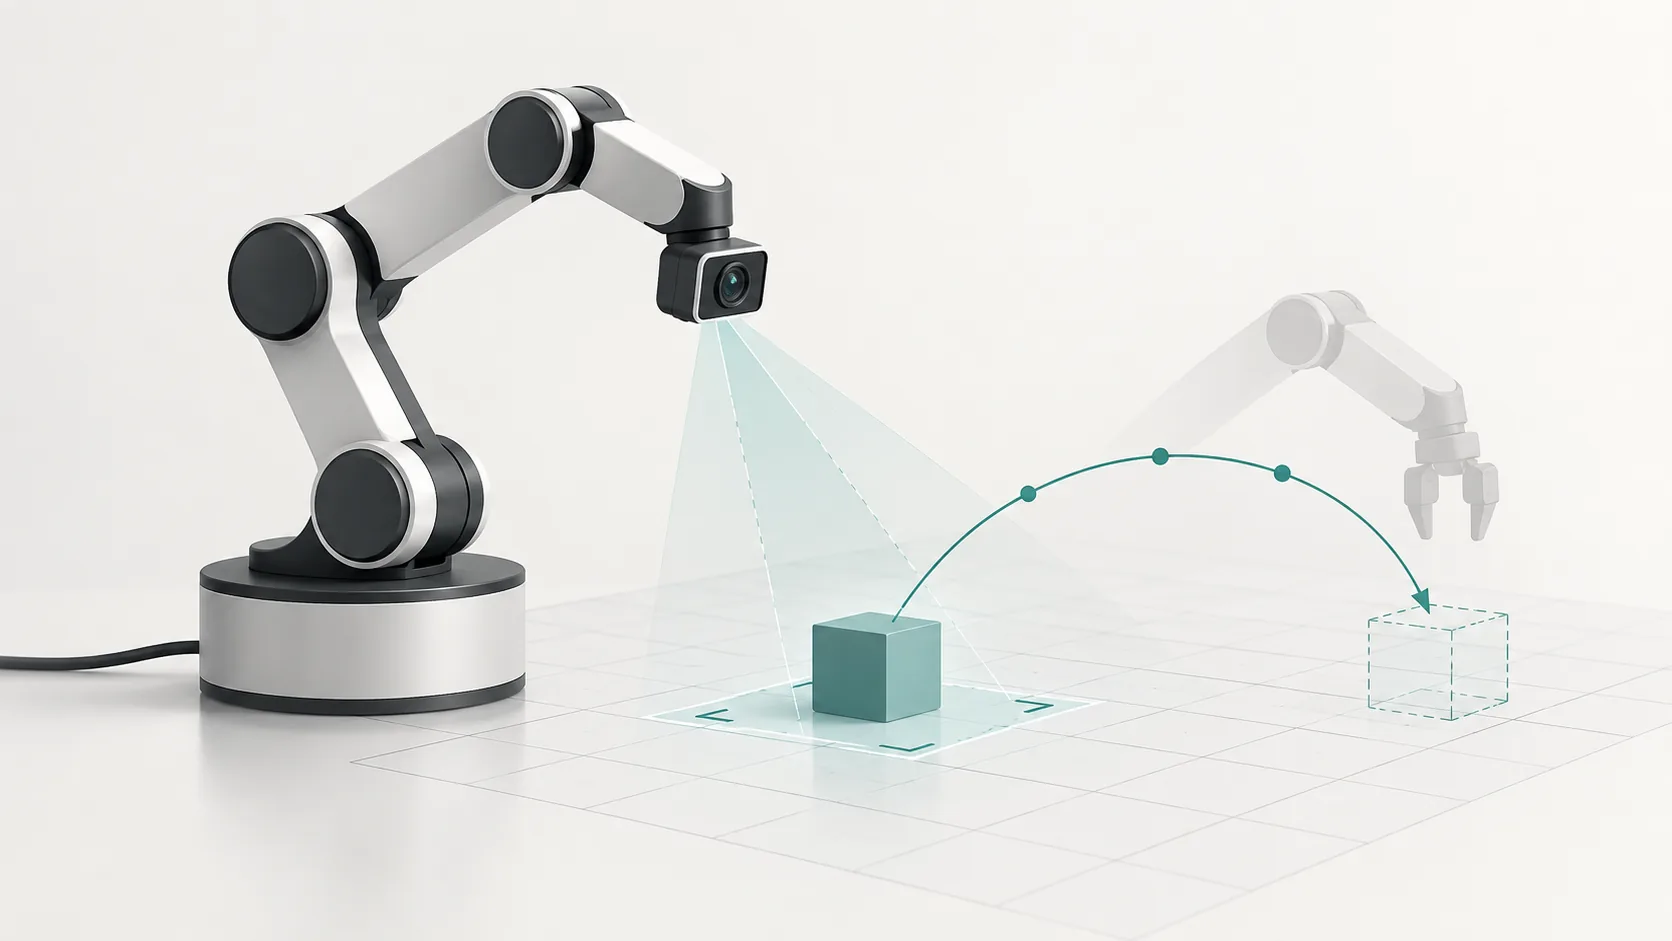
대표 이미지는 AI 생성 개념 일러스트이며 실제 실험 사진이 아니다. 제휴·협찬은 없다.
ROS 2 폐루프로 돌리자 위치는 표와 같았지만, float64 판정은 7번째가 아니라 8번째 갱신에서 성공 기준을 충족했다
글의 규칙 a = clamp(0.5 × (1 − o), −0.2, +0.2), x ← x + a를 ROS 2 노드 세 개로 나눠 실제로 돌렸다. 환경 노드(plant)는 실제 위치 x를 TF로 방송하고, 센서 노드는 tf2_ros.Buffer에서 위치를 조회해 bias를 더한 관측을 토픽으로 보낸다. 정책 노드는 ROS 파라미터 gain·limit을 매번 읽어 행동을 계산한다. 같은 입력을 실행 중에 Fraction으로도 계산해 기준 궤적으로 함께 기록했다. 시나리오는 네 가지다. 글의 표(exact), 0m에서 출발하는 +0.1m 편향(bias), 글의 오차 사례인 0.9m 출발 편향(bias_at_09), 관측이 한 갱신 늦은 경우(delay1)다.
| 질문 | 글의 계산·예측 | 실측(5회 실행 모두 같은 값) |
|---|---|---|
| exact: 7번 갱신까지의 위치와 행동 | 위치 0.2 → 0.4 → 0.6 → 0.8 → 0.9 → 0.95 → 0.975, 행동 0.2, 0.2, 0.2, 0.2, 0.1, 0.05, 0.025 | 같다(출력 궤적은 소수 12자리 반올림). Fraction 기준과 ROS 궤적의 최대 차이 8.881784197001253e-17 |
| exact: 7번 갱신 뒤 실제 차이와 판정 | 0.025m(=1/40), 성공 기준 충족 | true_gap 0.025000000000000022, gap_minus_tol 2.0816681711721685e-17, meets_tol false. 같은 실행의 Fraction 기준은 1/40로 충족 |
| exact: 처음 허용 오차 안에 든 갱신 | 7번째 | float64 ROS 루프 8번째(그때 실제 차이 0.012499999999999956), Fraction 기준 7번째. 판정이 갈린 갱신 [7] |
| bias_at_09: 0.9m에서 +0.1m 편향 | 관측 1m, 행동 0, 실제 차이 0.1m > 0.025m | 관측 1.0이 3번, 행동 0.0이 3번(zero_actions 3). 위치는 0.9에 머물렀고 실제 차이 0.09999999999999998 |
| bias: 0m에서 +0.1m 편향 | 글에 수치 없음. 가설: 관측 차이는 허용 오차 안, 실제 차이는 약 0.1m 이상 | 관측이 처음 허용 오차 안에 든 단계 7(관측 0.98125), 그때 실제 차이 0.11874999999999991. 12번 갱신 뒤 위치 0.8994140625, 실제 차이 0.1005859375. 실제 차이 기준 성공은 기록 안에서 없음(null) |
| 고정 규칙: 정책이 읽은 값 | gain·limit은 각각 한 값, 행동 크기는 여러 값 | 모든 시나리오에서 gain [0.5], limit [0.2]. 서로 다른 행동 크기 exact 10개, bias 10개, delay1 11개, bias_at_09 1개 |
| delay1: 관측 한 갱신 지연, 20번 갱신 | 글에 수치 없음. 가설: 목표를 지나쳤다가 되돌아오고, 처음 들어온 시점과 머무는 시점이 다르다 | 위치 최대 1.1(overshoot 0.10000000000000009), 0이 아닌 행동의 부호 변화 4번, 행동 0이 4번. 처음 허용 오차 안 5번째, 계속 머무는 시작 12번째. Fraction 기준은 각각 5번째, 9번째이며 판정이 갈린 갱신 [10, 11] |
| TF 경로가 값을 바꿨나 | (계획의 확인 항목) | 네 시나리오 모두 tf_readout_max_err 0.0. tick 시점에 TF가 이미 버퍼에 있던 횟수가 모든 시나리오에서 갱신 수와 같았다 |
실행 1의 stdout에서 발췌한 원본 출력이다. …는 생략한 부분이다.
{"scenario":"exact",…,"after_7":{"x":0.975,"true_gap":0.025000000000000022,"gap_minus_tol":2.0816681711721685e-17,"meets_tol":false},"first_success":8,"settled_from":8,…,"exact":{"gap_after_7":"1/40","first_success":7,"settled_from":7,"max_abs_diff_vs_ros":8.881784197001253e-17,"tol_verdict_differs_at":[7]},…}
{"scenario":"bias_at_09",…,"x":[0.9,0.9,0.9,0.9],"obs":[1.0,1.0,1.0],"action":[0.0,0.0,0.0],"final_true_gap":0.09999999999999998,…,"zero_actions":3,…}
{"scenario":"delay1",…,"x":[0.0,0.2,0.4,0.6,0.8,1.0,1.1,1.1,1.05,1.0,0.975,0.975,0.9875,1.0,1.00625,…],…,"first_success":5,"settled_from":12,"overshoot":0.10000000000000009,"action_sign_changes":4,"zero_actions":4,…,"exact":{"gap_after_7":"1/10","first_success":5,"settled_from":9,…,"tol_verdict_differs_at":[10,11]},…}
{"summary":true,"rmw":"rmw_fastrtps_cpp","target":1.0,"gain":0.5,"limit":0.2,"tolerance":0.025,"all_finished":true,"total_s":5.692}
측정 환경. 이미지 ros:jazzy-ros-base(ros@sha256:066420e07f60aa18262f2479981def87ebcfcec42eefb0c0c57c4a46098348ca), ROS 2 Jazzy, Python 3.12.3, rclpy 7.1.12-1noble.20260902.053513, RMW rmw_fastrtps_cpp(기본값). 컨테이너는 네트워크 없음, 1 CPU, 1 GiB로 제한했다. 노드는 MultiThreadedExecutor(4 스레드)에서 돌았다. 하네스가 5회 실행했고 5회 모두 종료 코드 0, stderr 없음이었다. 시간 값을 뺀 출력 필드는 5회 모두 같았다. 실행당 소요 시간은 6.34–8.64초였다. tick부터 행동 수신까지의 루프 왕복 시간 중앙값은 시나리오·실행에 따라 17.88–132.32ms, 최대값은 407.75ms까지 나왔다. tf2 조회 대기 중앙값은 0.12–0.13ms였다.
한계. 실제 로봇이나 물리 시뮬레이터가 아니며, 글과 같은 위치 계산 모델(명령한 변화량만큼 즉시 이동)을 토픽과 TF로 나눠 돌린 것이다. 관성, 충돌, 모터 한계는 없다. 단계는 메시지가 도착할 때마다 진행되는 락스텝이라 고정 주기 타이머의 비동기 지연은 재지 않았다. delay1의 지연은 tf2 이력 조회로 일부러 만든 한 갱신 늦은 관측이며 측정된 통신 지연이 아니다. 루프 왕복 시간은 1 CPU 컨테이너의 Python executor 스케줄링을 포함한 값이라 제어 주기 성능 지표가 아니다. delay1은 20번, 나머지는 12번(bias_at_09는 3번) 갱신만 기록했다. 0.2m 상한과 0.025m 허용 오차는 설명용 값이다.
측정과 해석을 나눠 읽기
위 구간은 출력 그대로의 측정이고, 이 문단부터는 해석이다.
해석 1: 7번째와 8번째의 차이는 ROS가 아니라 경계값 비교에서 생긴 것으로 보인다. TF로 읽은 값과 환경 노드의 기록이 정확히 같았고, ROS 궤적과 분수 궤적의 차이도 float64 반올림 수준이었다. 그런데도 판정이 갈린 이유는 글의 예제가 “차이가 허용 오차와 정확히 같은” 경계에 놓였기 때문으로 해석한다. 분수로는 1/40이 0.025와 같아 ≤를 통과하지만, float64로 행동을 차례로 더한 위치는 출력상 0.975로 보여도 1에서 빼면 0.025보다 아주 조금 크게 계산됐다. 따라서 “7번 갱신한 뒤 기준 충족”은 글의 분수 검산에서는 맞고, 같은 규칙을 float64로 판정하는 이 ROS 루프에서는 한 갱신 늦게 충족됐다. 이 원인 설명은 실측이 아니라 출력값을 근거로 한 추론이며, ROS 없이 순수 Python float로 따로 돌려 비교하지는 않았다.
해석 2: 편향은 출발점과 관계없이 “관측상 성공, 실제 실패”를 만들었다. 글은 0.9m에 이미 서 있는 장면만 계산했다. 0m에서 출발한 bias 시나리오에서도 정책은 관측이 1m에 다가가도록 움직였고, 그 결과 실제 위치는 0.9m 쪽에 붙어 목표에 닿지 않았다. 피드백은 관측과 목표의 차이를 줄일 뿐, 관측이 실제와 얼마나 어긋났는지는 알려 주지 않는다는 글의 설명을 실행 기록이 뒷받침한다.
해석 3: 행동이 줄어든 것은 학습이 아니라 입력이 바뀐 결과다. 정책이 실행 내내 읽은 gain과 limit은 각각 한 값이었고 행동 크기만 여러 값으로 바뀌었다. 글의 “다시 보고 움직이는 것과 배우는 것은 다르다”는 구분과 같은 결과다.
해석 4: 한 갱신 늦은 관측만으로 같은 규칙이 목표를 지나치고 되돌아왔다. delay1에서는 위치가 목표에 한 번 닿은 뒤에도 늦은 관측이 계속 “덜 왔다”고 알려 목표를 넘어섰고, 부호가 바뀌는 행동으로 되돌아왔다. 그래서 “처음 허용 오차 안에 든 시점”과 “계속 머무는 시점”이 달랐다. 이 두 시점을 하나의 “성공”으로 쓰면 다른 결과를 떠올리게 된다. 머무는 시점도 float64와 분수 기준이 달랐는데, 위치가 다시 0.975m 경계에 놓인 갱신에서 해석 1과 같은 비교 문제가 반복된 것으로 본다. 20번 갱신 안의 관찰이므로 지연이 있는 루프의 일반적인 안정성으로 넓혀 읽지는 않는다.
해석 5: 시간 값은 실행마다 크게 흔들렸지만 위치 궤적은 흔들리지 않았다. 단계가 메시지 도착에 맞춰 진행되는 락스텝 구조라 스케줄링 시간이 계산 결과에 끼어들 자리가 없었던 것으로 본다. 고정 주기로 도는 실제 제어 루프라면 이 구조가 성립하지 않으므로, 여기의 왕복 시간을 장치의 반응 속도로 읽지 않는다.
재현 코드와 실행별 원본 출력: GitHub