움직이는 로봇 관절을 P 제어하면 왜 오차가 남을까
움직이는 로봇 관절을 P 제어하면 왜 오차가 남을까. 정지한 목표에는 점점 가까워지던 관절이 일정한 속도로 움직이는 목표 앞에서는 계속 뒤처지는 이유는, 이 제어 법칙이 각도 오차에 비례해 속도 명령을 만들기 때문이다. 오차가 0이면 명령 속도도 0이 된다. 목표가 계속 움직인다면 목표와 같은 속도를 만드는 데 필요한 만큼의 오차가 남아야 한다.
여기서는 라디안과 초, 사칙연산만 알면 따라갈 수 있는 이상적인 단일 관절을 다룬다. 글을 읽고 나면 목표 속도 c와 비례이득 Kp로 정상상태 각도 오차 c/Kp를 계산하고, 속도나 이득을 바꿨을 때 값이 어떻게 달라지는지 판단할 수 있다. 단, 이 계산은 실제 모터의 안전한 이득을 정하는 공식이 아니다.
P 제어는 현재 오차를 속도 명령으로 바꾼다
비례 제어(Proportional control, P control)는 현재 오차에 일정한 비례이득을 곱해 명령을 만드는 피드백(feedback) 방식이다. 피드백은 실제 상태를 다시 받아 목표와 비교하는 과정이다. 이 글에서는 다음처럼 기호와 방향을 정한다.
- 목표 관절각
θd(t)[rad] - 실제 관절각
θ(t)[rad] - 각도 오차
e(t) = θd(t) - θ(t)[rad] - 비례이득
Kp > 0[1/s] - 관절 속도 명령
θ̇(t) = Kp e(t)[rad/s]
비례이득(proportional gain) Kp는 오차를 명령으로 얼마나 크게 바꿀지 정하는 값이다. 여기서 P 제어기의 출력은 힘이나 토크가 아니라 관절 속도다. 요청한 속도가 지연이나 포화 없이 실제 관절 속도로 그대로 실현된다고 가정한다.
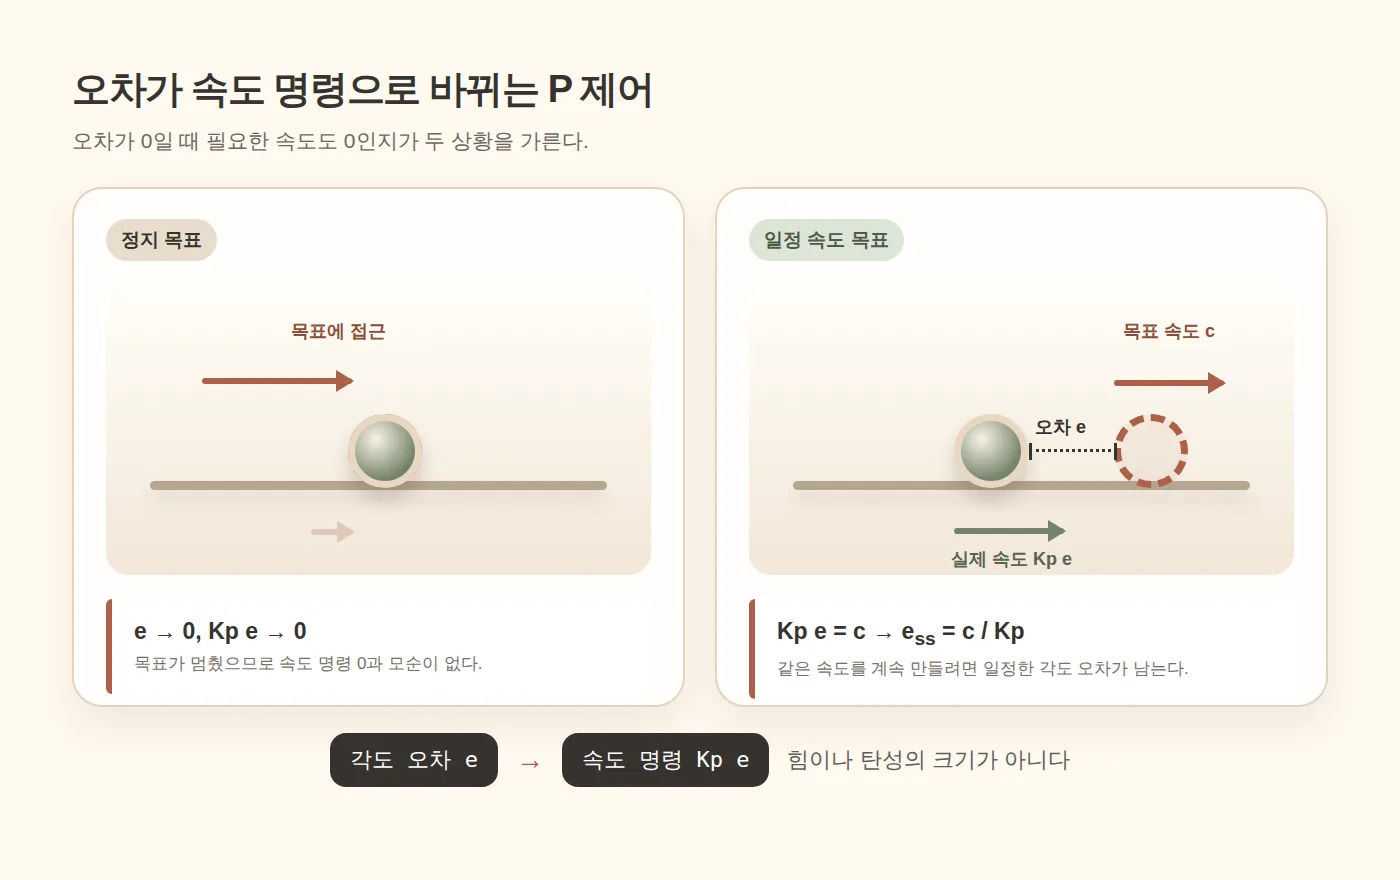
먼저 목표가 멈춰 있다고 보자. 관절이 목표에 가까워질수록 오차가 줄고, 속도 명령 Kp e도 작아진다. 목표에 도달해 오차가 0이면 더 움직일 필요가 없으므로 속도 명령 0과 모순이 없다. 이런 고정 목표를 유지하는 문제를 설정값 제어(setpoint control)라고 한다.
움직이는 목표에서는 사정이 다르다. 목표와 실제 관절의 각도가 완전히 같아지는 순간 P 출력은 0이지만, 목표는 다음 순간에도 앞으로 움직인다. 다시 간격이 벌어져야 속도 명령이 생긴다. 그래서 충분한 시간이 지나면 오차가 사라지는 대신, 목표와 같은 속도를 만드는 값에 머문다.
0.1 rad의 뒤처짐이 0.2 rad/s를 만든다
목표가 c = 0.2 rad/s로 움직이고 Kp = 2 1/s라고 하자. 실제 관절도 목표와 같은 0.2 rad/s로 움직이려면 P 제어 출력이 그 값이어야 한다.
Kp × e = 0.2 rad/s
2 1/s × e = 0.2 rad/s
e = 0.1 rad
이 모델에서 0.1 rad의 뒤처짐은 제어기가 멈춘 흔적이 아니다. 2 × 0.1 = 0.2 rad/s라는 속도 명령을 계속 만들어 목표와 나란히 움직이게 하는 균형값이다. 오차가 더 크면 실제 관절이 목표보다 빠르게 움직여 간격을 줄이고, 더 작으면 실제 관절이 느려져 간격이 다시 벌어진다.
간격이 생겨야 당겨지는 고무줄을 떠올릴 수는 있다. 다만 이 비유의 출력은 힘이 아니라 속도 명령이며, 질량·탄성·마찰을 나타내지 않는다. 고무줄의 흔들림으로 실제 관절의 오버슈트나 진동까지 설명할 수는 없다.
오차 변화가 멈추는 지점은 c/Kp다
이제 같은 내용을 식으로 확인해 보자. 목표가 일정한 각속도 c로 움직인다면 θ̇d = c다. 오차 e = θd - θ의 시간에 따른 변화는 목표 속도에서 실제 속도를 뺀 값이다.
ė = θ̇d - θ̇
  = c - Kp e
정상상태(steady state)는 시간이 충분히 지나 오차가 더 커지거나 작아지지 않는 상태다. 오차 자체가 0이라는 뜻이 아니라 오차의 변화 ė가 0이라는 뜻이다. 따라서 정상상태에서는 다음 균형이 성립한다.
0 = c - Kp e_ss
e_ss = c / Kp
양의 Kp에서는 초기 오차의 영향이 시간이 지나며 사라지고 c/Kp로 수렴한다. 목표가 멈추면 c=0이므로 이 식의 경계 사례는 e_ss=0이다. 정지 목표와 이동 목표의 차이는 P 제어가 갑자기 다른 방식으로 작동해서가 아니라, 계속 만들어야 하는 목표 속도가 0인지 아닌지에서 생긴다. 이 모델과 결론은 Modern Robotics의 속도입력 운동 제어 설명과 일치한다(2026-09-20 확인).
단위도 식을 검산한다. Kp e가 각속도 [rad/s]가 되려면 Kp의 단위는 [1/s]여야 한다. 따라서 (rad/s) ÷ (1/s) = rad이고, c/Kp는 각도 오차가 된다. ROS의 표준 단위는 초와 라디안을 사용하며, BIPM도 각속도를 rad/s로 표기한다. 자세한 단위 규칙은 ROS REP-103과 BIPM SI Brochure에서 확인할 수 있다(2026-09-20 확인).
속도 두 배와 이득 두 배를 같은 표에서 비교한다
아래 여섯 값은 실제 관절의 측정값이 아니라 이상 모델로 만든 설명용 예측이다.
| 사례 | c [rad/s] |
Kp [1/s] |
c/Kp [rad] |
무엇이 달라지는가 |
|---|---|---|---|---|
| 정지 목표 | 0 | 2 | 0 | 속도를 계속 만들 필요가 없다 |
| 기준 추종 | 0.2 | 2 | 0.1 | 0.1 rad가 0.2 rad/s 명령을 만든다 |
| 목표 속도 두 배 | 0.4 | 2 | 0.2 | 같은 이득이면 오차도 두 배다 |
| 이득 두 배 | 0.2 | 4 | 0.05 | 같은 속도이면 오차는 절반이다 |
| 낮은 이득 | 0.2 | 1 | 0.2 | 같은 속도에 더 큰 오차가 필요하다 |
| 같은 비율 | 0.4 | 4 | 0.1 | 정상상태 오차만 기준 추종과 같다 |
c를 두 배로 하면 같은 Kp에서 잔류 오차가 두 배가 되고, Kp를 두 배로 하면 같은 c에서 절반이 된다. 그러나 c/Kp가 같다고 전체 움직임도 같다는 뜻은 아니다. 이 값은 정상상태 오차만 말하며, 초기 상태에서 접근하는 과정이나 속도 포화 여부는 보여주지 않는다.
이 산술은 2026년 9월 20일 Linux와 Python 3.12.3에서 외부 패키지 없이 검산했다. 기대한 값은 차례로 0, 0.1, 0.2, 0.05, 0.2, 0.1 rad였고, 실제 출력도 일치했으며 종료 코드는 0이었다. assertion 불일치, Python 비정상 종료, 공개 원문의 해시 불일치 중 하나라도 생기면 검산 실패로 판정했다. 실행한 것은 산술 검사이며 물리 시뮬레이션이나 로봇 실험이 아니다.
독자는 커밋에 고정된 공개 계산 예제 example.py와 환경·출력·한계를 기록한 verification.json을 확인할 수 있다. 두 원문과 해시는 2026년 9월 20일에 대조했다.
확인 문제: 0.3 rad/s를 따라가려면 얼마가 남을까
이상적인 같은 모델에서 c = 0.3 rad/s, Kp = 3 1/s라고 하자. 정상상태 오차는 얼마일까?
e_ss = c / Kp
     = 0.3 rad/s ÷ 3 1/s
     = 0.1 rad
답이 0.1 rad인 이유는 나눗셈 자체보다 균형에 있다. 오차가 0.1 rad이면 제어기가 3 × 0.1 = 0.3 rad/s를 명령한다. 목표와 실제 관절의 속도가 같아지므로 오차가 더 변하지 않는다.
자신의 설명용 값으로도 같은 검산을 할 수 있다. c를 rad/s로, Kp를 1/s로 적고 c/Kp를 계산한다. 이어서 Kp × 계산한 오차가 원래의 c로 돌아오는지 확인하면 된다. 이는 개념 확인용 계산이지 장비에 입력할 튜닝 절차가 아니다.
Kp를 계속 키우는 것은 실제 로봇의 해법이 아니다
식만 보면 Kp가 클수록 c/Kp가 작아진다. 하지만 큰 이득은 작은 각도 오차에도 큰 속도를 명령한다. 액추에이터의 최대 속도에 걸리면 θ̇=Kp e라는 선형 관계가 더는 그대로 성립하지 않고, 지연과 모델에 포함하지 않은 동역학은 진동을 일으킬 수 있다. Modern Robotics도 큰 이득과 속도 제한을 함께 경고한다.
이 글의 계산에서 제외한 항목은 센서 오차, 제어 주기, 네트워크 지연, 마찰, 중력, 하중, 관절 결합, 속도 포화와 안정 여유다. 토크를 입력으로 받는 관절에도 c/Kp를 그대로 옮길 수 없다. 따라서 실제 장비에서는 제조사가 정한 속도·가속도·토크·관절 범위와 제어 주기를 먼저 확인해야 한다.
이 글의 계산값만 보고 Kp를 설정하거나 로봇을 구동해서는 안 된다. Modern Robotics도 액추에이터의 최대 속도와 높은 이득에서 생기는 진동 때문에 단순 모델에 한계가 있다고 설명한다. (Modern Robotics Part 1, 2026-09-20 확인) 여기서 검산한 c/Kp는 장비별 안전한 이득이나 실행 절차를 정해 주지 않는다. 소프트웨어 정지 명령 하나를 유일한 안전수단으로 삼지 않는다. 이 글은 제조사 안전 절차와 장비별 위험성 평가를 대신하지 않으며, 정지·보호 조건을 확인하지 못한 실물 시험은 보류한다.
오차를 줄이는 다음 개념으로는 적분항을 더한 PI 제어와 알려진 목표 속도를 명령에 미리 더하는 앞먹임(feedforward)이 있다. 앞먹임은 오차가 0이어도 목표 속도에 해당하는 명령을 만들 수 있다. 다만 모든 궤적과 실제 장비에서 오차 0을 보장하는 만능 해법은 아니다. 이 범위는 Modern Robotics Part 2에서 이어서 확인할 수 있다(2026-09-20 확인).
이상적인 속도입력 단일 관절에서 남는 오차는 제어 실패의 찌꺼기가 아니라 움직이는 목표와 같은 속도를 만드는 입력이다. 자신의 설명용 c와 Kp를 같은 단위로 적어 c/Kp를 계산하고 허용 오차와 비교해 보자. 그 값이 크다면 모델 안에서는 속도나 이득의 관계를 다시 볼 수 있지만, 실제 로봇의 이득 변경은 제조사 제한과 별도의 안전 검증이 갖춰질 때까지 보류해야 한다.
이 글에는 제휴·협찬이 없다.