이동평균 필터 실습: 센서 노이즈를 줄이면 왜 반응이 늦어질까
1m를 나타내야 할 입력이 1.2m와 0.8m 사이를 오간다. 이동평균 필터로 최근 값을 모으면 흔들림은 작아진다. 하지만 입력이 정말 바뀌었을 때도 옛값을 함께 평균한다. 이 글의 고정 예제에서 창을 3개에서 5개로 늘리면 정지 구간의 오차는 줄지만, 별도 계단 입력이 새 값의 90%에 도달하는 시간은 20ms에서 40ms로 늘어난다.
Python의 리스트·반복문과 평균 계산으로 이 차이를 확인할 수 있다. 글을 위해 만든 수치 배열을 비교한 실습이며, 센서·로봇·물리 엔진을 실행한 결과는 아니다.
지금 값에 과거 두 개를 섞으면 생기는 일
표본(sample)은 한 시각에 얻은 값이다. 여기서는 10ms마다 한 표본이 들어온다고 가정한다. 창(window)은 평균에 넣는 최근 표본의 묶음이다. 창 크기가 3이면 현재 값과 바로 전 두 값을 더해 3으로 나눈다. 한 시각이 지나면 가장 오래된 값은 빠지고 새 값이 들어온다.
y[k] = (x[k] + x[k-1] + ... + x[k-M+1]) / M
x는 입력, y는 평균한 출력이며 단위는 m다. k는 0부터 시작하는 표본 번호이고, M은 창에 넣는 개수다. 현재와 과거만 쓰므로 앞으로 들어올 값을 미리 알 필요가 없다. 처음 M-1개 시점은 아직 창이 덜 찼으므로 이번 구현은 출력 없음인 None으로 둔다.
여러 값을 평균해 변동을 줄이는 원리는 Steven W. Smith의 DSP 교재 15장에 설명돼 있다. 단측 평균과 중심 평균은 입력·출력의 시간 정렬이 다르다. 여기서는 실시간 입력의 뜻을 유지하려고 미래 표본을 쓰는 중심 평균은 제외한다.
다음 함수가 실험의 전부가 아니라, 평균을 만드는 핵심 부분이다. values[index-window+1:index+1]에서 끝 번호는 포함되지 않으므로 현재 표본까지 정확히 window개가 들어간다.
def moving_average(values, window):
    if type(window) is not int or window < 1:
        raise ValueError("window must be a positive integer")
    if any(not math.isfinite(value) for value in values):
        raise ValueError("samples must be finite")
    return [None if index < window - 1 else
            sum(values[index - window + 1:index + 1]) / window
            for index in range(len(values))]
전체 파일에는 import math와 실행용 입력이 포함돼 있다. None을 0으로 바꾸면 아직 평균을 계산하지 못한 시점을 0m 출력인 것처럼 표시하게 된다. 평균 입력에 0이 추가되는 것은 아니지만, 후속 코드가 그 출력을 실제 값으로 사용하면 판단을 잘못할 수 있다. 반대로 모인 개수만큼만 평균하는 방식도 가능하지만, 그때는 시작 구간의 창 크기가 달라진다는 사실을 따로 다뤄야 한다.
노이즈와 반응 시간을 따로 측정한다
한 번의 실험에 두 배열을 쓴다. 첫 배열은 참값 1m에 +0.2, -0.2m가 번갈아 붙는 40개 입력이다. 이것은 결과를 손으로 확인하기 쉬운 고정 교대 잡음이지, 실제 센서 로그나 무작위 백색잡음이 아니다.
정지 상태의 오차 크기는 제곱평균제곱근(RMS, root mean square)으로 계산한다. 출력에서 참값 1m를 뺀 오차를 제곱하고, 평균을 낸 다음 제곱근을 취한다. 오차를 그냥 평균하면 양수와 음수가 취소되므로 이 실험에서는 흔들림이 작아 보이는 문제가 생긴다. 모든 창을 같은 인덱스 4~39의 36개 출력으로 평가해 시작 구간 차이도 제외했다.
두 번째 배열은 잡음 없이 0m를 유지하다가 인덱스 20부터 1m로 바뀐다. 갑자기 높이가 달라지는 입력을 계단 입력(step input)이라고 한다. 여기서는 바뀐 첫 표본 시각부터 출력이 0.9m 이상이 되는 첫 표본까지를 90% 도달 지연으로 정한다. 이 값은 프로그램 실행 시간이나 모든 종류의 필터 지연을 뜻하지 않는다.
잡음이 섞인 입력의 문턱 통과 시점을 재면 잡음 자체가 결과를 흔들 수 있다. 그래서 평활화 효과는 첫 배열에서, 변화 추종은 별도 무잡음 배열에서 본다. 두 성질을 따로 보는 실험이지 하나의 실제 센서 성능 점수가 아니다.
파일을 내려받아 같은 결과를 확인한다
고정 버전 예제 폴더에는 실행 코드, 테스트와 README가 있다. 실제 명령·출력 기록도 같은 버전에 묶었다. 기록에서 Python 실행 파일의 개인 절대경로만 python3로 표시했으며 출력은 바꾸지 않았다.
아래 실행은 2026년 9월 17일 macOS 14.0, Python 3.12.9에서 확인했다. 준비물은 Python 3.12 이상이다. 외부 패키지는 필요 없다. sensor_filter.py와 test_sensor_filter.py를 같은 새 폴더에 저장하고 그 폴더의 터미널에서 실행한다. 첫 명령에 나온 버전이 낮다면 해당 환경에 Python 3.12 이상을 먼저 준비한다. 패키지 설치나 가상환경 생성은 필요 없다.
python3 --version
python3 sensor_filter.py
python3 -m unittest -v
실험 명령의 실제 출력은 다음과 같다. 마지막 테스트 명령은 8개 테스트를 통과했고, 두 명령 모두 종료 코드는 0이었다.
controlled example: alternating noise; separate noiseless step
sample_interval_ms=10; rms_positions=4..39; step_index=20
window  stationary_rms_m  step90_delay_ms
     1          0.200000                0
     3          0.066667               20
     5          0.040000               40
창 1은 아무것도 평활화하지 않는 기준선이다. 창 3에서는 세 잡음 중 두 개가 상쇄되고 하나만 남아 평균 오차 크기가 약 0.066667m가 된다. 창 5도 같은 이유로 0.04m다. 이 수치는 교대 배열과 홀수 창이 맞물린 결과이므로 일반 잡음에 똑같은 감소율을 기대해서는 안 된다. 창 2로 바꾸면 이 배열에서는 흔들림이 상쇄되지만, 그것 역시 실제 센서에 창 2가 최적이라는 증거가 아니다.
40ms는 계산이 느려서 생긴 시간이 아니다
창 3의 무잡음 계단 출력을 손으로 따라가면 지연이 어디에서 생기는지 보인다.
| 표본 번호 | 평균하는 최근 입력 | 출력 | 변화 후 경과 |
|---|---|---|---|
| 20 | 0, 0, 1 | 1/3m | 0ms |
| 21 | 0, 1, 1 | 2/3m | 10ms |
| 22 | 1, 1, 1 | 1m | 20ms |
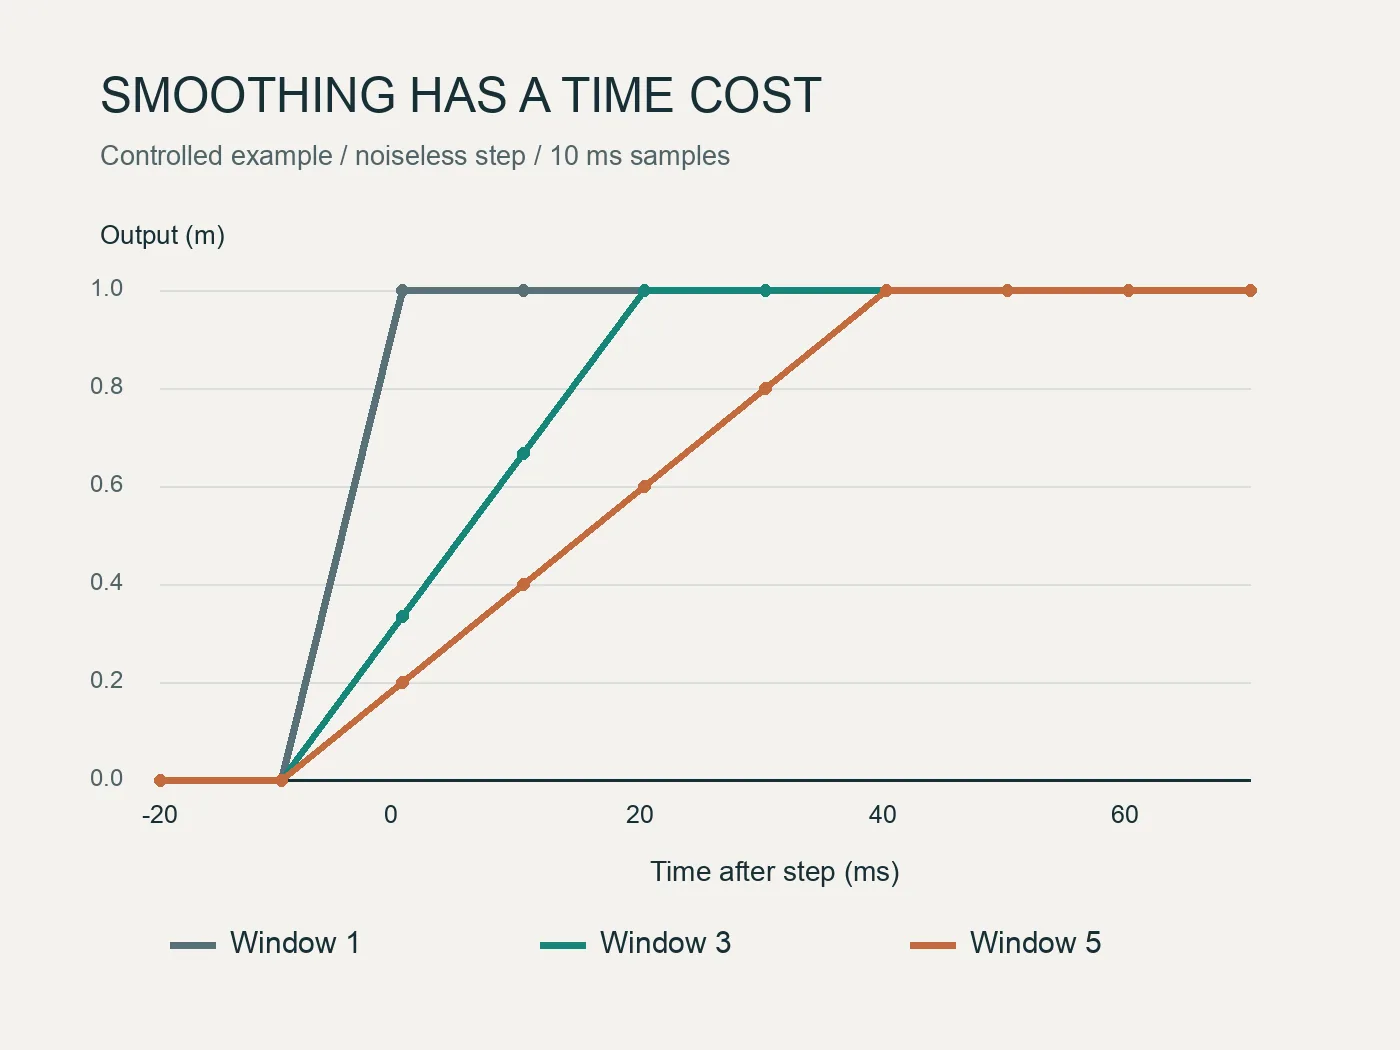
첫 변화가 들어온 번호 20에서 번호 22까지는 두 간격이다. 표본을 세 개 썼다고 30ms로 세지 않는다. 창 5에서는 새 값이 0.2 → 0.4 → 0.6 → 0.8 → 1.0m로 올라가므로, 첫 0.9m 이상 출력은 번호 24이고 네 간격인 40ms가 된다.
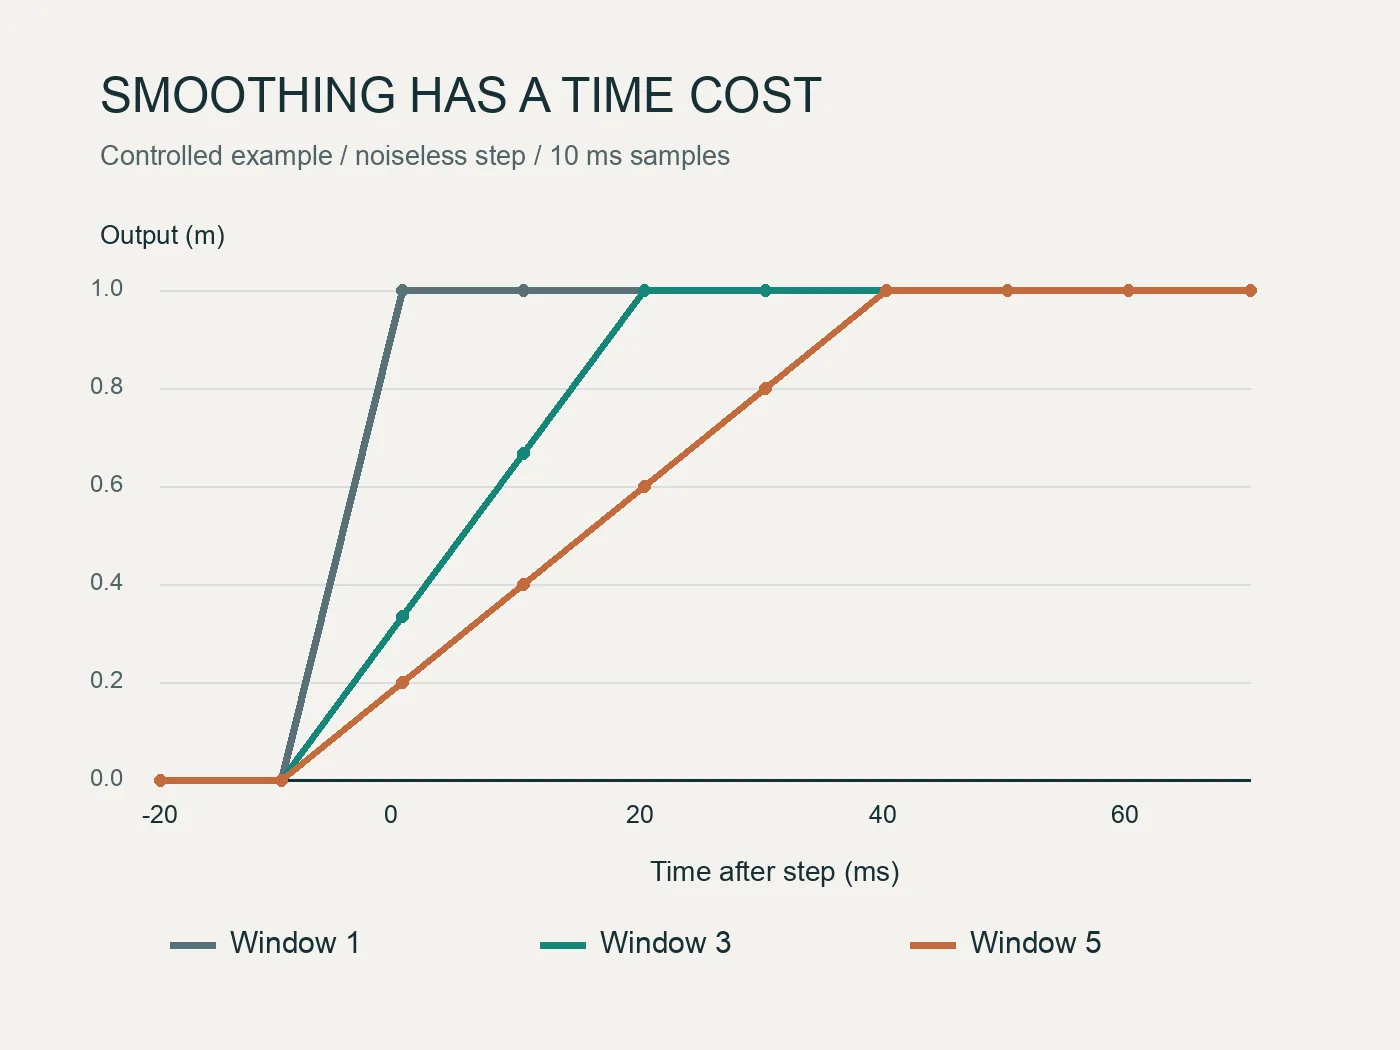
그림은 별도 무잡음 계단의 계산 결과다. 각 점은 10ms 간격의 표본이며 점 사이 선은 읽기 위한 연결선이다. 실물 측정이나 연속 시간의 실제 궤적을 나타내지 않는다.
평균 함수가 순식간에 실행돼도 과거의 0이 창에 남아 있으면 출력은 작다. 따라서 코드를 빠르게 만드는 것만으로 이 지연이 사라지지는 않는다. 미래 값까지 평균해 선을 가운데로 옮기면 그래프는 정렬할 수 있어도, 실제로 아직 들어오지 않은 표본을 현재 판단에 쓸 수는 없다.
잘못된 창과 고정된 오차도 확인한다
입력 검사가 실제로 동작하는지 다음 명령을 실행했다. 정상 결과를 기대하는 명령이 아니라, 창 0을 거절하는 의도적인 실패 대조군이다.
python3 sensor_filter.py --invalid-window 0
ERROR: window must be a positive integer
종료 코드는 2다. 이 오류가 나오면 창 크기를 1 이상의 정수로 고친다. 테스트 파일은 이 조건 외에도 미래 표본을 사용하지 않는지, 처음 출력이 None인지, 손계산이 맞는지, 유한하지 않은 입력을 거절하는지 확인한다.
또 하나는 평균으로 해결되지 않는 오차다. 참값이 1m인데 입력이 계속 1.2m라면 다섯 개를 평균해도 1.2m다. 한쪽으로 계속 치우치는 오차인 편향(bias)은 이 평균만으로 없어지지 않는다. 이 조건도 테스트에 들어 있다. 덜 흔들리는 출력과 참값에 가까운 출력은 서로 다른 요구다.
창을 고르기 전에 허용 지연부터 적는다
교육용 요구사항을 “90% 도달 지연 30ms 이하에서 정지 오차를 줄인다”로 정해 보자. 표에 나온 세 후보 중 창 1과 3은 시간을 만족하지만, 창 5는 40ms라 탈락한다. 창 3을 고르는 이유는 가장 매끈해서가 아니라, 이번 입력과 제한 안에서 창 1보다 오차가 작기 때문이다.
표본 간격만 20ms로 바꾸면 창 3의 도달 지연은 얼마인가? 출력 배열은 같아도 두 간격이므로 40ms다. 표본 개수가 같아도 실제 기다리는 시간은 달라진다.
입력이 계속 1.2m라면 창을 크게 해서 참값 1m를 되찾을 수 있는가? 같은 값의 평균은 그대로이므로 할 수 없다. 평균을 더 많이 내기 전에 오차가 흔들림인지 편향인지 구별해야 한다.
이 편향이 행동에 미치는 영향은 관측상 성공과 실제 성공을 구분하는 예제와 연결된다. 필터 출력을 판단에 쓰기 전에 무엇이 정확해졌고 무엇은 그대로인지 따져야 하는 이유다.
실제 센서에 적용할 때는 이 예제의 숫자를 가져가는 대신, 기록한 입력으로 허용 오차와 시간 제한을 다시 정해야 한다. 표본 간격의 흔들림·누락, 이상치, 편향과 실제 제어 루프의 영향은 여기서 검증하지 않았다. 특히 움직임의 안전을 결정하는 입력에는 이 교육용 함수만 연결하지 않는다. 먼저 공개 예제에서 창 크기와 표본 간격을 바꿔, 그래프가 매끈해지는 만큼 판단 시점이 얼마나 달라지는지 함께 확인한다.