로봇 강화학습 에피소드가 끝났을 때: 추락과 시간 제한의 목표값은 왜 다를까
로봇 강화학습 에피소드가 끝났을 때, 로봇이 넘어져 멈춘 경우와 외부 타이머가 울려 멈춘 경우를 모두 done=True로 저장하면 눈앞의 제어 흐름은 정상처럼 보인다. 두 경우 모두 루프를 끝내고 환경을 다시 시작하면 되기 때문이다. 그러나 같은 done을 학습 목표값의 마스크로도 쓰면, 시간 제한 직전까지 남아 있던 다음 상태의 가치가 사라진다.
이 차이를 이해하는 데 필요한 수학은 사칙연산과 불리언 값을 0 또는 1로 바꾸는 계산뿐이다. 여기서는 같은 보상, 할인율, 다음 상태 가치를 두고 종료 원인만 바꿔 본다. 공식 문서와 원논문은 2026년 9월 20일에 확인했으며, 예제는 Ubuntu 환경의 Python 3.12.3 표준 라이브러리로 산술만 검산했다. Gymnasium 환경, 물리 시뮬레이터, 신경망 학습과 실물 로봇은 실행하지 않았다.
에피소드의 끝에는 서로 다른 두 질문이 숨어 있다
에피소드(episode)는 환경을 초기화한 뒤 다시 초기화해야 할 때까지 모은 상호작용 구간이다. 에피소드가 끝났다는 말은 데이터 수집 구간이 멈췄다는 뜻이지, 언제나 과제 속 미래까지 없어졌다는 뜻은 아니다.
여기서 두 종료 원인을 구분해야 한다.
- 종결(termination)은 과제 안에서 정한 끝에 도달한 것이다. 로봇이 넘어지면 실패로 끝난다고 정의한 보행 과제의 추락이 한 예다.
- 절단(truncation)은 과제 밖의 조건이 상호작용 구간을 잘라낸 것이다. 계속 걸을 수 있는 과정을 메모리나 데이터 수집 일정 때문에 일정 시간 뒤 멈추는 경우가 이에 해당한다.
Gymnasium의 현재 step API는 이 구분을 terminated와 truncated라는 두 불리언으로 돌려준다. Env API와 시간 제한 처리 튜토리얼은 에피소드 제어와 가치 업데이트에서 이 둘의 역할이 다르다고 설명한다. 튜토리얼은 Gymnasium 1.3.0 호환으로 표시되어 있다.
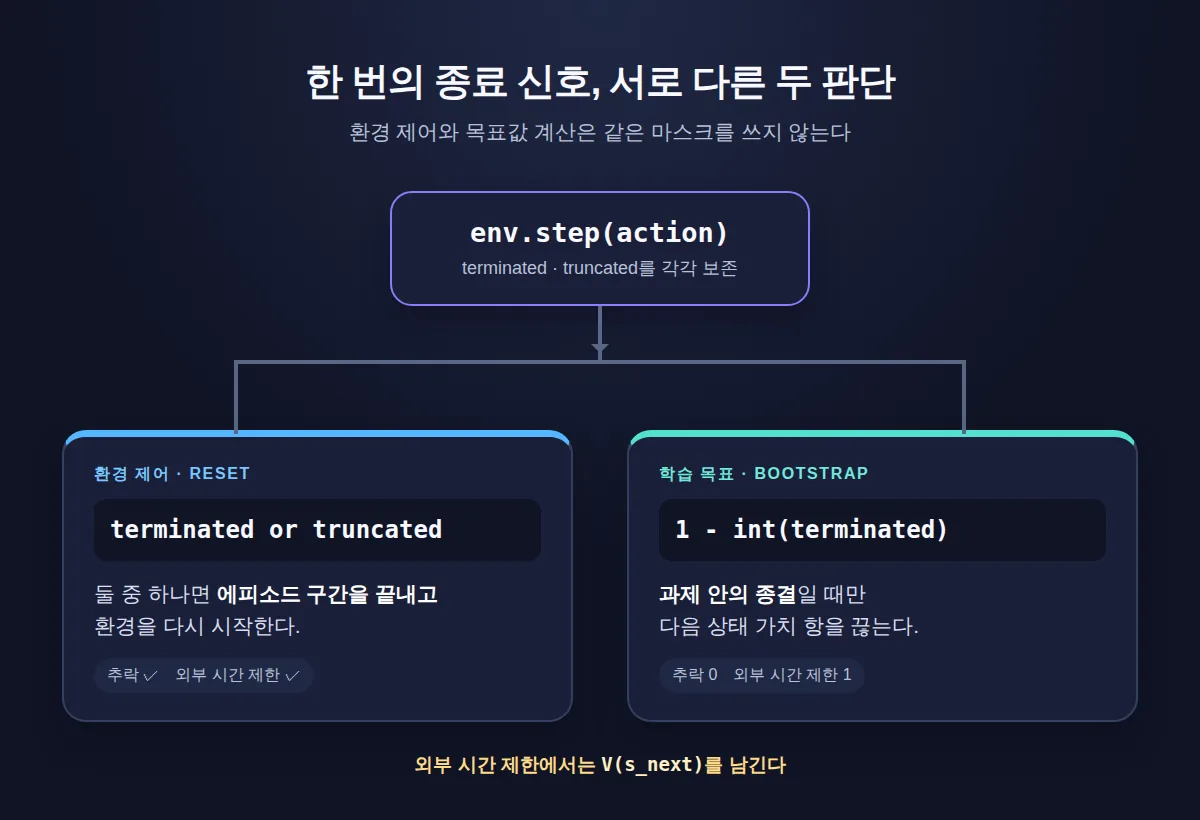
루프가 멈췄는지를 묻는다면 둘 중 하나만 참이어도 충분하다.
episode_done = terminated or truncated
하지만 학습할 때 물어야 할 질문은 다르다. “다음 상태의 가치가 과제 정의상 사라졌는가?”다. 이 질문에는 terminated가 답한다.
목표값에는 즉시 보상과 아직 남은 미래가 함께 들어간다
목표값(target)은 가치 함수가 한 번의 업데이트에서 가까워지도록 삼는 값이다. 이번 단계에서 바로 받은 즉시 보상 r과는 다르다. 상태 가치의 한 단계 목표를 다음처럼 놓을 수 있다.
target = r + gamma × (1 - terminated) × V(s_next)
gamma는 미래 보상을 현재 계산에서 얼마나 줄여 볼지 정하는 할인율이고, V(s_next)는 다음 상태부터 기대하는 할인 누적 보상의 현재 추정이다. 값의 단위를 reward unit이라고 하면 r과 V(s_next), 최종 목표값도 reward unit이며 gamma는 단위가 없다.
부트스트랩(bootstrap)은 다음 상태에 대한 현재 추정값을 지금의 목표 계산에 다시 쓰는 일이다. 위 식에서는 gamma × V(s_next)가 그 항이다. terminated=True이면 1 - terminated가 0이므로 이 항을 더하지 않는다. 추락 뒤 같은 에피소드에서 이어질 미래가 없다는 과제 정의를 반영한 것이다.
truncated=True, terminated=False라면 데이터 수집은 끝났어도 원래 과정의 다음 상태 가치는 남아 있다. 그래서 마스크가 1이고 부트스트랩 항을 유지한다. Pardo et al.의 ICML 2018 원논문도 무기한 과정을 학습 편의상 나눈 부분 에피소드의 끝에서는 부트스트랩해야 한다고 구분한다.
이 처리는 추락에 음의 보상을 줄지와도 별개다. 추락 직후 r=-1로 설계했다면 종결 목표는 -1이 되지만, 이유는 벌점이 음수라서가 아니라 종결 뒤의 다음 상태 가치 항이 0이기 때문이다.
같은 숫자인데 종료 원인만 바꾸면 1과 10이 된다
설명용 로봇이 계속 걷는 과제를 수행한다고 가정한다. 한 전이에서 다음 값을 고정한다.
- 즉시 보상
r=1reward unit - 할인율
gamma=0.9 - 다음 상태 가치 추정
V(s_next)=10reward unit
첫째 상황은 로봇이 넘어지면 실패로 끝나는 과제에서 실제로 추락한 경우다. terminated=True이므로 계산은 다음과 같다.
target = 1 + 0.9 × (1 - 1) × 10
       = 1
둘째 상황은 로봇이 계속 걸을 수 있지만 외부 수집 타이머 때문에 구간을 자른 경우다. truncated=True여도 terminated=False이므로 다음 상태의 추정값을 남긴다.
target = 1 + 0.9 × (1 - 0) × 10
       = 10
두 상황 모두 terminated or truncated는 참이다. 이를 목표값 마스크에 그대로 넣으면 둘째 계산도 1이 된다. 외부 절단 전이에서 빠진 9는 정확히 gamma × V(s_next), 즉 0.9 × 10이다. 이는 이 한 전이의 설명용 목표값 차이일 뿐, 학습된 정책의 성능이 9만큼 떨어진다는 측정 결과가 아니다.
Python 검산은 두 신호가 맡는 역할만 확인한다
아래 코드는 Python 3.12.3과 표준 라이브러리 decimal만 사용한다. 준비할 외부 패키지는 없다. 공개된 전체 예제 코드도 같은 입력으로 두 목표식을 비교한다.
from decimal import Decimal

r = Decimal("1")
gamma = Decimal("0.9")
next_value = Decimal("10")

def target(terminated: bool) -> Decimal:
    mask = Decimal(0) if terminated else Decimal(1)
    return r + gamma * mask * next_value

assert target(True) == Decimal("1.0")
assert target(False) == Decimal("10.0")

print("fall:", target(True))
print("external time limit:", target(False))
기대 결과는 추락 1.0, 외부 시간 제한 10.0이다. 2026년 9월 20일 Ubuntu runner의 Python 3.12.3에서 관측한 실제 결과도 같았고 프로세스는 종료 상태 0으로 끝났다. assertion이 실패하거나 두 번째 값이 10.0이 아니면 실패로 판정한다. 입력, 결과와 검산 환경은 공개 검증 기록에서 확인할 수 있다.
이 검산은 목표식의 불리언 분기와 산술만 확인한다. Gymnasium 1.3.0을 설치해 환경을 step한 결과도 아니고, 정책 학습의 수렴이나 로봇 보행 성능을 측정한 실험도 아니다. 공식 구현과의 대조로는 PyTorch DQN 튜토리얼이 terminated or truncated로 루프를 끝내면서 terminated일 때만 다음 상태를 None으로 처리하는 것을 확인했다. 해당 튜토리얼은 이 환경에서 실행하지 않았다.
확인 문제: 타이머가 울리면 언제나 절단일까
로봇에게 “정확히 30초 동안 최대한 멀리 가라”는 과제를 줬다고 하자. 30초가 지나면 언제나 truncated=True로 처리해야 할까?
답은 아니다. 30초가 목적 함수 자체에 포함된 유한 지평선(finite horizon) 과제라면 그 뒤의 미래는 애초에 학습하려는 반환에 없다. 이때 시간 끝은 과제 안의 종결로 모델링해야 한다. 남은 시간에 따라 최적 행동이 달라질 수 있으므로 남은 시간도 관측에 포함해야 한다.
이유는 마르코프 결정 과정(Markov Decision Process, MDP)의 상태가 현재 행동을 정하는 데 필요한 정보를 담아야 하기 때문이다. 남은 시간이 1초인 때와 20초인 때에 같은 센서값이 보이더라도 적절한 행동은 다를 수 있다. 시간을 감추면 하나의 관측이 서로 다른 상황을 가리키게 된다.
반대로 목적은 계속 걷기인데 학습 배치 크기나 데이터 수집 일정 때문에 30초마다 끊었다면 외부 절단이다. 이름이 “시간 제한”인지보다 타이머 뒤의 미래가 과제의 반환 정의에도 없는지를 먼저 확인해야 한다.
코드에서는 reset 신호와 학습 마스크를 따로 점검한다
Gymnasium v0.26+의 두 신호를 사용하는 기본 형태는 다음과 같다. 마이그레이션 가이드도 옛 done 하나에서 두 반환값으로 바뀐 지점을 설명한다.
observation, reward, terminated, truncated, info = env.step(action)

episode_done = terminated or truncated
target = reward + gamma * (1 - int(terminated)) * next_value

if episode_done:
    observation, info = env.reset()
done이라는 이름 자체가 잘못은 아니다. episode_done처럼 루프 종료와 reset을 결정하는 합성 신호로는 맞다. 문제는 그 값을 그대로 TD, Q 또는 critic 목표의 부트스트랩 마스크로 재사용하는 데 있다.
자신의 구현에서는 다음 순서로 확인하면 된다.
- 환경이 반환한
terminated와truncated를 각각 보존한다. - 루프 종료 조건은 두 값의 OR인지 확인한다.
- 목표값의 부트스트랩 마스크는
terminated만 보는지 확인한다. - 리플레이 버퍼에
done하나만 있어 두 종료 원인을 복원할 수 없다면 저장 스키마를 재검토한다. - 같은
r,gamma,next_value를 두고 종료 플래그만 바꾸는 단위 테스트를 추가한다.
벡터 환경이나 자동 reset 래퍼에서는 한 가지 문제가 더 남는다. 절단 직전의 실제 마지막 관측 대신 reset 뒤 새 에피소드의 첫 관측을 s_next로 쓰면, 부트스트랩 여부를 바로 고쳐도 목표값은 잘못된다. 이 글에서는 특정 프레임워크의 final_observation API를 검증하지 않았으므로 사용 중인 버전의 공식 문서를 별도로 확인해야 한다. n-step return, GAE와 순환 상태 처리도 같은 의미 구분은 필요하지만 구현 세부는 이 예제의 범위를 벗어난다.
실물 로봇에서는 추락을 재현해 단위 테스트하지 않는다
이 글의 계산을 확인하려고 로봇을 실제로 넘어뜨릴 이유는 없다. 저장된 전이 데이터나 합성 플래그로 목표값 테스트를 먼저 하고, 필요하다면 시뮬레이션 검증을 별도 단계로 둔다. 추락을 복구 가능한 상태로 정의한 과제라면 애초에 추락을 termination으로 끊는 환경 설계부터 다시 검토해야 한다.
승인된 실물 시험이 별도로 필요할 때는 제조사 제한을 따르고 추락 방지 지그나 테더, 격리된 작업 영역, 비상 정지 장치(E-stop), 저속·저토크 제한과 감독자를 갖춰야 한다. 이상이 보이면 전원이나 구동을 즉시 중지한다. 이번 산술 검산과 문서 대조는 특정 하드웨어의 안전이나 실제 성능을 보장하지 않는다.
학습 루프를 고칠 때 기억할 기준은 짧다. 에피소드를 다시 시작할지는 terminated or truncated로 정하고, 다음 상태 가치를 없앨지는 terminated로 정한다. 먼저 리플레이 버퍼가 done 하나만 저장하는지 확인하고, 추락과 외부 시간 제한 전이로 목표값 단위 테스트를 추가하는 것이 가장 작은 다음 행동이다.
참고 링크
- Gymnasium — Handling Time Limits — 종결·절단과 부트스트랩 식, 유한 지평선 예외. 2026-09-20 확인.
- Gymnasium — Env API —
step반환 계약. 2026-09-20 확인. - Pardo et al. — Time Limits in Reinforcement Learning — 유한 지평선의 시간 인식과 부분 에피소드 부트스트랩. 2026-09-20 확인.
- PyTorch — Reinforcement Learning (DQN) Tutorial — 루프 종료와 terminal next state 처리의 공식 구현 사례. 페이지 표기 2.14.0+cu130, 2026-09-20 확인.
이 글에는 제휴·협찬이 없다.