Gymnasium 커스텀 로봇 환경에서 step()이 같은 관측 배열을 고쳐 돌려주면, 복사 없이 쌓는 리플레이 버퍼에는 무엇이 남을까: 관절각 4스텝으로 평균과 차분 속도 계산하기
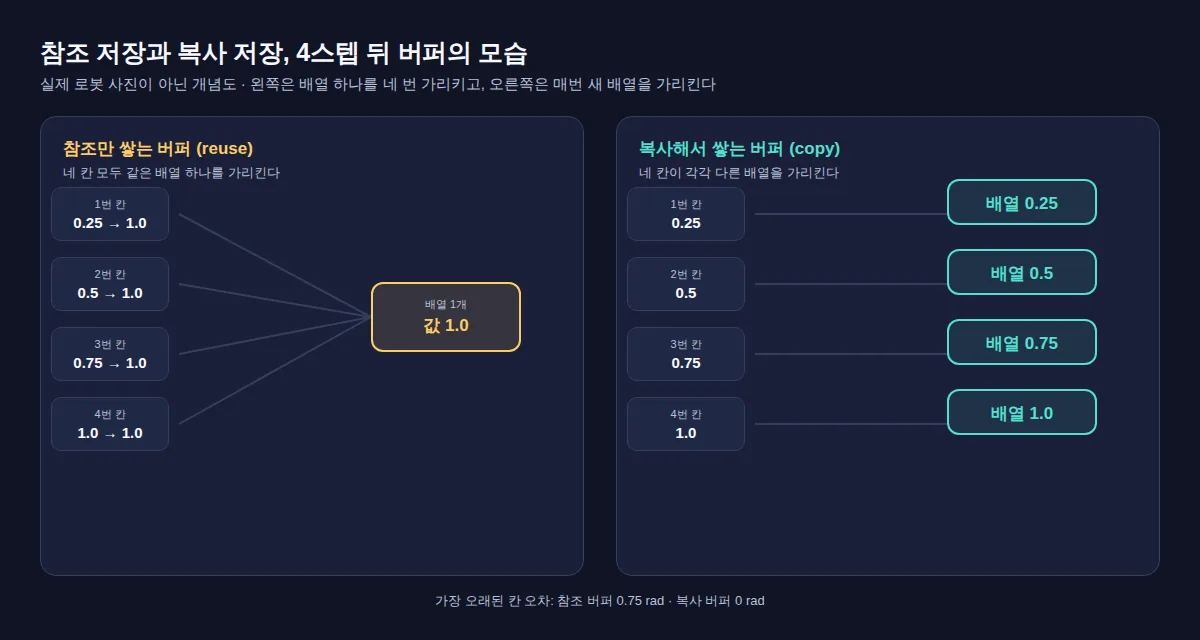
로봇 팔 관절각을 관측으로 내보내는 커스텀 환경에서 step()이 self._q += 0.25 다음 줄에 return self._q를 하고, 학습 루프는 받은 관측을 buffer.append(obs)로 쌓는다고 하자. 이처럼 Gymnasium 커스텀 로봇 환경에서 step()이 같은 관측 배열을 고쳐 돌려주면, 복사 없이 쌓는 리플레이 버퍼에는 무엇이 남을까. 4스텝 뒤 버퍼를 열어 보면 네 칸 모두 마지막 값 1.0 rad다. 실제로 지나간 값 0.25, 0.5, 0.75, 1.0 rad의 평균은 0.625 rad인데 버퍼 평균은 1.0 rad이고, 연속한 두 관측으로 구한 속도는 2 rad/s에서 0으로 바뀐다. 그런데 마지막 칸만 확인하는 테스트는 그대로 통과한다.
오차는 가장 오래된 칸에서 0.75 rad로 가장 크고 최신 칸에서는 0이다. 테스트가 가장 오래된 칸을 봐야 하는 이유가 여기 있다. Gymnasium 문서가 이 문제를 검사한다고 소개하는 check_env()도 2026년 10월 5일 배포된 1.4.0부터 실제로 검사하며, 1.3.0에서는 같은 환경이 통과했다. Python 리스트와 numpy 배열을 다뤄 봤다면 아래 계산을 따라올 수 있다. 숫자의 근거는 세 층이다. 손으로 따라 할 수 있는 산술 검산, Gymnasium 1.4.0과 1.3.0에서 돌린 검사기 판정, 그리고 Gymnasium의 반환 형태만 흉내 낸 설명용 환경을 ROS 2 Jazzy 컨테이너에서 5회 실행한 실측이다. 물리 시뮬레이터나 실제 로봇은 돌리지 않았다.
리스트 칸은 관측 배열을 가리킬 뿐이다
관측(observation)은 에이전트가 한 step마다 환경에서 받는 값이다. 여기서는 관절이 돌아간 각도인 관절각(joint angle, 단위 rad) 하나를 담은 numpy 배열이다. OpenAI Spinning Up은 로봇의 상태(state)를 관절각과 속도로 나타낼 수 있다고 설명하고, 관측은 그 상태의 일부일 수 있다고 구분한다(Spinning Up rl_intro.rst). step은 행동 하나를 넣고 다음 관측·보상·종료 여부를 돌려받는 한 번의 진행이다. 상태와 관측, 행동이 아직 한 덩어리로 보인다면 작은 위치 예제로 셋을 나눠 계산한 피지컬 AI 작동 원리: 관측·행동·피드백을 숫자로 이해하기를 먼저 읽어도 좋다.
리플레이 버퍼(replay buffer)와 롤아웃 버퍼(rollout buffer)는 지나간 step의 관측·행동·보상을 모아 두었다가 나중에 학습에 꺼내 쓰는 저장소다. 문제는 Python에서 리스트 칸이 값을 담는 상자가 아니라 객체를 가리키는 이름이라는 점이다. y = x도, list.append(obs)도 객체를 복사하지 않는다(Python FAQ). 여기에 제자리 수정(in-place modification), 즉 새 배열을 만들지 않고 기존 배열의 값만 바꾸는 self._q += 0.25가 겹치면, 버퍼의 모든 칸이 같은 배열 하나를 가리키게 된다. 마지막 step 뒤 그 배열에 1.0이 들어 있으니 어느 칸을 읽어도 1.0이다.
Gymnasium도 이 상황을 직접 언급한다. Env API의 step() 설명은 “Users commonly keep the data from every timestep, most obviously in a replay or rollout buffer, so each call must return new observation and info objects rather than modifying and returning the same buffer.”라고 적는다(Gymnasium Env API, v1.4.0 core.py L117–L120). reset()에도 같은 요구가 있다(core.py L165–L167). 사용자가 받은 데이터를 보관한다는 전제가 있으니, 환경이 같은 배열을 계속 고쳐 쓰면 보관된 과거가 함께 바뀐다는 뜻이다.
화이트보드 한 장을 매 step 지우고 새 각도를 쓰면서, 기록장에는 사진 대신 “회의실 화이트보드”라는 위치만 네 번 적어 둔 상황과 비슷하다. 나중에 기록장을 펼치면 네 줄 모두 지금 화이트보드에 쓰인 값을 가리킨다. 이 비유는 참조의 의미까지만 설명한다. 배열의 일부만 공유하는 view나 메모리 배치는 이 그림으로 설명되지 않으며, 그 부분은 아래 NumPy 절에서 따로 다룬다.
0.25 rad씩 네 번 움직인 관절로 계산하기
설명용 가정은 다음과 같다. 관절은 1개, 매 step 0.25 rad씩 움직이고, step 간격 Δt는 0.125 s다. 특정 로봇의 사양이 아니라 이진 부동소수점으로 정확히 표현되는 값을 골라 반올림 오차를 없앤 숫자다.
| step | 그 순간 실제 관절각 | 4스텝 뒤 참조 버퍼의 해당 칸 | 4스텝 뒤 복사 버퍼의 해당 칸 |
|---|---|---|---|
| 1 | 0.25 rad | 1.0 rad | 0.25 rad |
| 2 | 0.5 rad | 1.0 rad | 0.5 rad |
| 3 | 0.75 rad | 1.0 rad | 0.75 rad |
| 4 | 1.0 rad | 1.0 rad | 1.0 rad |
평균부터 보자. 복사 버퍼는 (0.25 + 0.5 + 0.75 + 1.0) / 4 = 0.625 rad, 참조 버퍼는 (1.0 × 4) / 4 = 1.0 rad다. 평균이 1.0 − 0.625 = 0.375 rad 치우친다. 칸별로 보면 가장 오래된 칸은 1.0 − 0.25 = 0.75 rad 어긋나고, 최신 칸은 1.0 − 1.0 = 0이다.
속도는 유한 차분(finite difference)으로 구한다. 연속한 두 관측의 차를 시간 간격으로 나누는 방법이다. 복사 버퍼에서 첫 두 칸의 차분 속도는 (0.5 − 0.25) / 0.125 = 2 rad/s다. 참조 버퍼에서는 (1.0 − 1.0) / 0.125 = 0 rad/s가 된다. 계산 결과만 보면 평균이 조금 치우친 정도로 보이지만, 해석하면 의미가 더 크다. 실제로 움직인 관절이 버퍼 안에서는 처음부터 1.0 rad에 멈춰 있던 것처럼 남는다. 관측에 속도가 없고 이전 관측과의 차로 속도를 추정하는 구성이라면, 그 정보가 통째로 사라진다.
한 가지는 구분해야 한다. 이 산술에서 “네 칸 모두 1.0″은 계산 결과가 아니라 “버퍼가 참조만 쌓는다”는 가정에서 넣은 입력이다. 그 가정이 실제로 성립하는지는 아래 컨테이너 실측에서 확인한다. 산술 자체는 Python 3.12.3에서 math.isclose 단언으로 검산했고, 식과 결과는 검산 예제 example.py와 검산 기록 verification.json에 공개돼 있다.
직접 계산해 볼 두 문제
- Δt가 0.25 s라면 첫 두 칸의 차분 속도는 각각 얼마일까?
- 같은 참조 버퍼에 8스텝을 쌓으면 가장 오래된 칸의 오차는 얼마일까?
1번의 답은 복사 버퍼 (0.5 − 0.25) / 0.25 = 1 rad/s, 참조 버퍼는 여전히 0 rad/s다. 분자가 0이라 Δt를 어떻게 바꿔도 0에서 벗어나지 않는다. 2번은 가장 오래된 칸이 실제로는 0.25 rad, 버퍼에서는 마지막 값 0.25 × 8 = 2.0 rad로 보이므로 오차가 1.75 rad다. 일반화하면 N스텝일 때 0.25 × (N − 1) rad이고, 버퍼가 길어질수록 커진다. 최신 칸 오차는 N과 상관없이 0이다.
obs[:]와 np.asarray(obs)는 복사하지 않는다
반환 직전에 뭔가 새 배열처럼 보이는 표현을 쓰면 해결된다고 생각하기 쉽다. NumPy에서 self._q[:] 같은 basic indexing은 뷰(view)를 만든다. 뷰는 데이터 버퍼를 원본과 공유하면서 모양만 다르게 보여 주는 배열이라, 원본이 바뀌면 뷰의 값도 바뀐다(NumPy Copies and views). np.asarray(a)는 “No copy is performed if the input is already an ndarray with matching dtype and order”라고 문서에 적혀 있다(numpy.asarray). 이미 float64 ndarray인 관측을 넣으면 같은 객체가 그대로 돌아온다.
데이터 버퍼까지 새로 만드는 복사(copy)는 ndarray.copy()나 np.array(a)다. 그래서 가장 단순한 수정은 반환 직전에 self._q.copy()를 돌려주는 것이다. 두 배열이 메모리를 공유하는지는 np.shares_memory(a, b)로 확인할 수 있고(numpy.shares_memory), 뒤에서 볼 Gymnasium 1.4.0 검사기도 이 함수로 판정한다.
뷰에는 함정이 하나 더 있다. 뷰는 매번 새 Python 객체라서 id()가 서로 다르다. 버퍼 안 객체가 몇 개인지 세어 “네 개니까 괜찮다”고 판단하면 놓친다. 이 차이는 아래 실측의 distinct_ids와 oldest_shares_mem_newest 값에서 그대로 드러난다.
컨테이너에서 다섯 번 실행한 결과는 예측과 같았다
산술의 가정을 확인하려고, Gymnasium의 reset() -> (obs, info)와 step() -> (obs, reward, terminated, truncated, info) 반환 형태만 흉내 낸 설명용 환경을 만들었다. 반환 방식 4종(reuse=self._q, view=self._q[:], asarray=np.asarray(self._q), copy=self._q.copy())을 버퍼 3종에 넣었다. 버퍼는 4스텝을 그대로 쌓는 list, 6스텝을 넣어 최근 4칸만 남기는 deque(maxlen=4), 저장할 때 np.array(obs)로 복사하는 copy_on_store다. 참값은 각 step 직후 환경 내부 값을 float()로 떼어 따로 기록했다.
실행 환경은 ros:jazzy-ros-base 이미지(다이제스트 고정), 네트워크 없음, CPU 1개, 메모리 1 GiB이고 같은 스크립트를 5회 돌렸다. 이 이미지에는 gymnasium 패키지가 없어서 check_env()는 이 실측에 들어가지 않는다. 처음 시험 실행에서는 deque에도 4스텝만 넣어 list와 결과가 완전히 같았고, 최근 4칸 창이 밀려나는 경우를 보려고 deque에 6스텝을 넣도록 바꿨다. 재현 스크립트와 실행별 원본 출력은 실험 디렉터리에 있고, 이 글이 인용한 바이트는 고정 커밋의 experiment.py와 results.json이다.
같은 조건으로 재현하려면 Docker가 있는 Linux 셸에서 다음을 실행한다. 이미지 다이제스트는 results.json에 기록된 값이고, 스크립트 SHA-256은 results.json의 script_sha256과 같아야 한다.
curl -fsSLO https://raw.githubusercontent.com/sungpyo9053/blog/486ac73c4af035cb084672fec88e5e90958c7ba5/experiments/gymnasium-step-observation-buffer-reuse-replay-aliasing/experiment.py
sha256sum experiment.py   # c9b2e2879c63a3d9ba1db30064eb2b3c866884cefbf631a807cb58db9a935e86
docker run --rm --network none --cpus 1 --memory 1g -v "$PWD":/work ros@sha256:066420e07f60aa18262f2479981def87ebcfcec42eefb0c0c57c4a46098348ca bash -c "source /opt/ros/jazzy/setup.bash && python3 /work/experiment.py"
정상이면 종료 코드 0과 함께 JSON 한 줄씩 출력된다. 첫 줄의 numpy가 컨테이너 안 버전이다.
측정 환경: Python 3.12.3, numpy 1.26.4, x86_64, rclpy 7.1.12, 기본 RMW rmw_fastrtps_cpp. 5회 실행 모두 종료 코드 0이었고, 버퍼·테스트·ROS 2 측정값은 5회 모두 같았다.
| 항목 | 실행 전 예측 (plan.md) | 실측 (5회 동일) |
|---|---|---|
reuse × list 저장값 |
네 칸 모두 1.0 rad | [1.0, 1.0, 1.0, 1.0] |
| 저장값 평균 / 참값 평균 | 1.0 / 0.625 rad | 1.0 / 0.625 |
| 평균 오차 | 0.375 rad | 0.375 |
| 가장 오래된 칸 오차 | 0.75 rad | 0.75 |
| 최신 칸 오차 | 0 | 0.0 |
| 첫 쌍 차분 속도 (저장 / 참값) | 0 / 2 rad/s | 0.0 / 2.0 |
view, asarray × list |
reuse와 같은 결과 |
저장값·오차 모두 reuse와 같음 |
| 버퍼 안 서로 다른 객체 수 | (예측 없음) | reuse 1, view 4, asarray 1, copy 4 |
| 첫 칸과 마지막 칸 메모리 공유 | (예측 없음) | reuse·view·asarray true, copy false |
reuse × deque4 (6스텝) |
네 칸 모두 1.5, 평균 오차 0.375, 가장 오래된 칸 오차 0.75 | [1.5, 1.5, 1.5, 1.5], 0.375, 0.75 |
copy × deque4 (6스텝) |
0.75, 1.0, 1.25, 1.5, 평균 1.125 | [0.75, 1.0, 1.25, 1.5], 1.125 |
copy_on_store (반환 방식 4종 모두) |
정상 값 | 오차 0.0, 차분 속도 2.0 |
| 마지막 칸 테스트 / 가장 오래된 칸 테스트 | 네 방식 모두 통과 / copy만 통과 |
네 방식 모두 통과 / copy만 통과 |
1회차 원본 출력에서 판단을 바꾸는 줄만 그대로 옮긴다.
{"m": "env", "python": "3.12.3", "numpy": "1.26.4", "machine": "x86_64", "step_rad": 0.25, "dt_s": 0.125, "n_steps": 4}
{"m": "buffer", "env": "reuse", "buffer": "list", "steps": 4, "stored_rad": [1.0, 1.0, 1.0, 1.0], "expected_rad": [0.25, 0.5, 0.75, 1.0], "mean_stored": 1.0, "mean_expected": 0.625, "mean_err": 0.375, "oldest_err": 0.75, "newest_err": 0.0, "fd_vel_stored": 0.0, "fd_vel_expected": 2.0, "distinct_ids": 1, "oldest_shares_mem_newest": true}
{"m": "buffer", "env": "view", "buffer": "list", "steps": 4, "stored_rad": [1.0, 1.0, 1.0, 1.0], "expected_rad": [0.25, 0.5, 0.75, 1.0], "mean_stored": 1.0, "mean_expected": 0.625, "mean_err": 0.375, "oldest_err": 0.75, "newest_err": 0.0, "fd_vel_stored": 0.0, "fd_vel_expected": 2.0, "distinct_ids": 4, "oldest_shares_mem_newest": true}
{"m": "buffer", "env": "copy", "buffer": "list", "steps": 4, "stored_rad": [0.25, 0.5, 0.75, 1.0], "expected_rad": [0.25, 0.5, 0.75, 1.0], "mean_stored": 0.625, "mean_expected": 0.625, "mean_err": 0.0, "oldest_err": 0.0, "newest_err": 0.0, "fd_vel_stored": 2.0, "fd_vel_expected": 2.0, "distinct_ids": 4, "oldest_shares_mem_newest": false}
{"m": "unit_test", "env": "reuse", "last_only_pass": true, "oldest_pass": false, "all_pass": false}
{"m": "unit_test", "env": "copy", "last_only_pass": true, "oldest_pass": true, "all_pass": true}
reuse × list에서 버퍼 길이 N을 바꿔 잰 오차는 다음과 같다.
| N | 가장 오래된 칸 오차 (rad) | 평균 오차 (rad) | 최신 칸 오차 (rad) |
|---|---|---|---|
| 2 | 0.25 | 0.125 | 0.0 |
| 4 | 0.75 | 0.375 | 0.0 |
| 8 | 1.75 | 0.875 | 0.0 |
| 16 | 3.75 | 1.875 | 0.0 |
| 64 | 15.75 | 7.875 | 0.0 |
예측과 실측은 모든 행에서 같았다. 산술에서 가정으로 넣었던 “네 칸 모두 마지막 값”은 참조를 쌓는 list와 deque에서 실제로 성립했다. 눈여겨볼 행은 view다. 객체가 4개로 세어져 정상처럼 보이지만 첫 칸과 마지막 칸이 메모리를 공유했고, 저장값은 reuse와 똑같이 틀렸다. 객체 수를 세는 검사로는 이 버그를 판정할 수 없다. N을 늘린 표는 확인 문제 2번의 답 1.75 rad와 식 0.25 × (N − 1)을 그대로 따른다. 길이가 고정된 deque(maxlen=4)는 몇 스텝을 넣든 창 안의 오차가 0.375와 0.75로 일정했다. 프레임을 최근 몇 개만 겹쳐 쓰는 구조에서는 오차가 쌓이지 않는 대신 창 전체가 항상 한 시점으로 뭉개진다.
어떤 테스트를 둘지는 첫 표의 마지막 행이 정해 준다. 반환 방식이 무엇이든 마지막 칸 테스트는 통과했고, 가장 오래된 칸 테스트만 copy가 아닌 세 방식을 실패로 판정했다.
가장 오래된 칸을 보는 테스트를 환경 옆에 둔다
아래 파일은 같은 설명용 관절 환경을 실제 gymnasium.Env로 만들고, 4스텝을 복사 없이 쌓은 뒤 가장 오래된 원소가 0.25 rad인지 확인한다. 이어서 check_env()를 실행한다. Ubuntu Linux의 Python 3.12.3에서 새 가상환경을 만들고 아래 준비 단계만 수행한 뒤 확인했으며, 설치된 버전은 gymnasium 1.4.0, numpy 2.5.3이었다. Gymnasium 1.4.0은 PyPI 기준 Python 3.10 이상이 필요하다. 위 컨테이너 실측과는 다른 환경에서의 확인이다.
python3 --version
python3 -m venv .venv
.venv/bin/python -m pip install "gymnasium==1.4.0"
joint_buffer_check.py:
import sys

import numpy as np
import gymnasium as gym
from gymnasium import spaces
from gymnasium.utils.env_checker import check_env


class OneJointEnv(gym.Env):
    """관절 하나가 매 step 0.25 rad씩 움직이는 설명용 환경."""

    def __init__(self, copy_obs=True):
        self.copy_obs = copy_obs
        self.observation_space = spaces.Box(-10.0, 10.0, shape=(1,), dtype=np.float64)
        self.action_space = spaces.Box(-1.0, 1.0, shape=(1,), dtype=np.float32)
        self._q = np.zeros(1, dtype=np.float64)

    def _get_obs(self):
        return self._q.copy() if self.copy_obs else self._q

    def reset(self, *, seed=None, options=None):
        super().reset(seed=seed)
        self._q[:] = 0.0
        return self._get_obs(), {}

    def step(self, action):
        self._q += 0.25  # 설명용: 행동과 무관하게 매 step 0.25 rad
        return self._get_obs(), 0.0, False, False, {}


def oldest_survives(env):
    env.reset(seed=0)
    buffer = []
    for _ in range(4):
        obs, *_ = env.step(env.action_space.sample())
        buffer.append(obs)  # 복사 없이 참조만 쌓는 단순 버퍼
    return float(buffer[0][0]) == 0.25


copy_obs = sys.argv[1:] != ["reuse"]
ok = oldest_survives(OneJointEnv(copy_obs))
print("oldest element test:", "PASS" if ok else "FAIL")
try:
    check_env(OneJointEnv(copy_obs), skip_render_check=True)
    print("check_env: PASS")
except AssertionError as e:
    ok = False
    print("check_env: FAIL -", str(e).split(",")[0])
sys.exit(0 if ok else 1)
.venv/bin/python joint_buffer_check.py로 정상 모드를, .venv/bin/python joint_buffer_check.py reuse로 버그 모드를 실행한다. 정상 모드는 두 줄 모두 PASS를 출력하고 종료 코드 0이다. 버그 모드의 출력은 다음과 같았고 종료 코드는 1이었다.
oldest element test: FAIL
check_env: FAIL - The observations returned by `env.reset() (call 1)` and `env.step() (call 2)` share an object
같은 파일을 Gymnasium 1.3.0 가상환경에서 reuse로 돌리면 가장 오래된 원소 테스트만 FAIL이고 check_env는 PASS였다. 버전과 무관하게 버그를 잡은 쪽은 가장 오래된 원소 테스트다. 자기 환경에 옮길 때는 0.25 대신 첫 step 직후의 실제 관측값을 따로 숫자로 떼어 두고 비교하면 된다.
check_env는 1.4.0부터, 값이 아니라 같은 객체인지를 본다
Env API 문서는 새 객체 요구 바로 뒤에 “gymnasium.utils.env_checker.check_env() checks this.”라고 적는다. 그런데 이 검사 함수 check_returned_data_not_reused는 1.4.0 소스에만 있고 1.2.2·1.3.0 소스에는 없다. 도입은 PR #1683(2026-09-06 병합)이고, v1.4.0 릴리스 노트는 이 검사로 Gymnasium 자체의 Humanoid·HumanoidStandup에서 info 재사용 두 곳을 찾아 고쳤다고 밝힌다. 1.4.0 미만을 쓰고 있다면 문서만 믿고 check_env()를 통과시킨 것은 이 문제에 대해 아무것도 확인하지 않은 셈이다.
검사 방식도 알아 둘 만하다. check_env()는 시드를 고정해 reset 1회, step 최대 2회, reset 1회를 호출하고, 돌려받은 모든 관측·info 쌍에 공유 여부를 묻는다. 일반 ndarray는 np.shares_memory로, dict는 같은 키끼리, tuple은 원소별로 비교한다(env_checker.py L273–L307, passive_env_checker.py L179–L218). docstring은 “As this compares identity rather than value, an array or dictionary that an environment intends to be constant must also be copied”라고 적는다.
값이 아니라 동일성을 보니 결과를 읽는 방법이 달라진다. 1.4.0에서 self._q[:]와 np.asarray(self._q)로 고친 환경은 self._q를 그대로 돌려준 환경과 같은 AssertionError로 실패했고 .copy()만 통과했다. 반대로 값이 전혀 바뀌지 않는 목표 위치 배열을 그대로 돌려줘도 실패한다. Gymnasium 공식 튜토리얼 Create a Custom Environment의 GridWorldEnv는 _get_obs()가 내부의 target 배열을 그대로 넣는데, 페이지 코드를 그대로 이어 붙여 1.4.0 check_env()에 넣으면 같은 “share an object” AssertionError로 실패했고 1.3.0에서는 “Environment passes all checks!”를 출력했다. 그러니 1.4.0의 이 실패는 “과거 기록이 이미 틀렸다”가 아니라 “같은 객체를 두 번 돌려줬다”는 뜻이다. Dict 관측이면 고정된 값까지 포함해 각 배열을 copy해서 넣어야 통과한다.
gym.make()가 기본으로 씌우는 수동 검사기(passive environment checker)는 성격이 다르다. 1.4.0에서는 첫 reset→첫 step, 첫 step→둘째 step 두 쌍만 한 번씩 비교해 경고를 남기고 실행은 계속한다(wrappers/common.py L284–L311). 실제로 reuse 환경을 gym.make()로 만들었을 때 경고가 두 번 찍혔지만 버퍼는 그대로 오염됐다. 1.3.0의 gym.make()는 경고도 없었다. 소스만 보면 처음 두 쌍 이후부터 재사용이 시작되는 환경은 경고 없이 지나갈 수 있는데, 이 경우는 실행으로 확인하지 않았다.
버퍼가 복사하는지는 라이브러리마다 따로 확인한다
모든 버퍼가 참조만 쌓는 것은 아니다. Stable-Baselines3 2.9.0의 ReplayBuffer.add()는 “# Copy to avoid modification by reference” 주석과 함께 np.array(obs)로 값을 복사해 넣는다(buffers.py L265–L271). 위 실측의 copy_on_store가 이 방식이고, 반환 방식 4종 모두에서 오차가 0이었다. 다만 SB3는 설치하거나 실행하지 않았고 이 줄과 RolloutBuffer.add()의 같은 처리만 소스로 확인했으므로, SB3를 쓰는 학습 경로 전체가 안전하다고까지는 말할 수 없다.
Gymnasium 1.4.0의 FrameStackObservation 래퍼는 받은 관측을 deque에 참조로 쌓는다(stateful_observation.py L415–L436). 프레임 스택(frame stack)은 최근 몇 개의 관측을 겹쳐 정책 입력으로 주는 방식인데, 같은 배열을 재사용하는 환경을 이 래퍼로 감싸 4스텝을 돌리자 1.3.0·1.4.0 모두 스택된 네 프레임이 마지막 값이었다. 정책이 보는 입력에서 움직임 정보가 빠진다는 뜻이다. 래퍼 결함이라기보다 환경이 새 객체를 준다는 API 전제를 어긴 결과로 보는 편이 맞다.
PyTorch로 옮길 때도 갈린다. torch.tensor는 “by copying data”로 생성하고(_torch_docs.py L9587), torch.from_numpy는 “The returned tensor and ndarray share the same memory”다(_torch_docs.py L4606–L4607). 매 step torch.tensor(observation)으로 넣는 파이토치 한국어 DQN 튜토리얼의 ReplayMemory는 이 복사 덕분에 문제가 드러나지 않는 구조다. 속도를 이유로 from_numpy로 바꾸면 그 보호가 사라진다. PyTorch는 docstring만 확인했고 실행하지 않았다.
Gymnasium 밖의 로봇 코드에서도 같은 모양이 나올 수 있다. ROS 2로 관절 상태를 내보내는 코드가 메시지 객체 하나를 고쳐 가며 발행하고, 디버깅하려고 그 메시지를 list에도 모아 두는 경우다. 이 경우를 같은 컨테이너에서 따로 쟀다. Gymnasium 환경과는 별개의 측정이다.
ROS 2 프로그램은 노드(node)라는 실행 단위로 나뉜다. 센서를 읽는 일, 제어 명령을 계산하는 일처럼 한 가지 역할을 맡은 프로그램 조각이다. 노드끼리는 토픽(topic)이라는 이름 붙은 통로로 메시지를 주고받는다. 보내는 쪽을 발행자(publisher), 받는 쪽을 구독(subscription)이라고 부른다.
실험에서는 노드 하나 안에 joint_obs 토픽의 발행자와 구독을 함께 두었다. 관절 상태용 표준 메시지인 sensor_msgs/JointState 객체를 하나만 만들고, 그 position[0]을 매번 0.25 rad씩 고쳐 4번 발행했다. 발행할 때마다 그 객체를 발행 노드의 list에 넣었고, 구독 콜백은 받은 메시지를 그대로 다른 list에 넣었다.
실제 전송을 맡는 미들웨어 계층인 RMW(ROS middleware)는 기본값 rmw_fastrtps_cpp를 그대로 썼다. 메시지를 어떻게 전달하고 몇 개까지 쌓아 둘지 정하는 QoS(Quality of Service) 설정은 신뢰성 RELIABLE, 최근 16개 보관이다.
| 기록 위치 | 저장값 (rad) | 서로 다른 객체 수 | 가장 오래된 칸 오차 |
|---|---|---|---|
| 발행 노드 안의 list | [1.0, 1.0, 1.0, 1.0] | 1 | 0.75 |
| 구독 콜백이 받은 메시지 | [0.25, 0.5, 0.75, 1.0] | 4 | 0.0 |
{"m": "ros2_jointstate", "position_type": "array", "matched": 1, "expected_rad": [0.25, 0.5, 0.75, 1.0], "pub_local_rad": [1.0, 1.0, 1.0, 1.0], "pub_local_ids": 1, "pub_local_oldest_err": 0.75, "sub_count": 4, "sub_rad": [0.25, 0.5, 0.75, 1.0], "sub_ids": 4, "sub_oldest_err": 0.0, "sub_matches": true}
7관절 float64 배열에 대해 연산 한 번의 비용을 20000회 반복 × 7번 재어 중앙값을 냈다. 5회 실행에 걸친 1회당 중앙값 범위는 ndarray.copy 378.8~386.1 ns, np.array 417.2~428.0 ns, 참조를 그대로 돌려주는 기준선 55.8~57.2 ns였다.
토픽을 건너 받은 쪽은 네 값이 순서대로 남았고, 발행한 쪽이 직접 쌓은 기록만 Gymnasium 예제와 같은 모양으로 틀렸다. 발행 시점의 값이 메시지로 넘어간다는 실행 전 예측과 맞는 결과다. 다만 직렬화(serialization, 메시지를 전송용 바이트로 바꾸는 일) 시점을 따로 잰 것은 아니고, rclpy 단일 프로세스와 기본 RMW 한 조건뿐이다. C++ 프로세스 내 통신(intra-process)이나 다른 RMW는 재지 않았으므로 “ROS 2 메시지는 항상 안전하다”로 넓히지 않는다. 앞에서 든 디버깅용 list처럼 발행 노드가 자기 메시지 객체를 직접 쌓는 코드라면, Gymnasium 환경과 똑같이 쌓기 전에 복사해야 한다.
복사 비용은 공유 CPU 1개짜리 컨테이너의 마이크로벤치마크다. 7관절 관측 한 번의 copy는 참조 반환보다 수백 ns 더 들었고 1마이크로초에는 못 미쳤다. 실제 제어 주기와 비교한 측정은 아니므로, 자기 환경의 step 시간과 나란히 놓고 판단해야 한다.
환경 코드에서 먼저 고칠 것과 이 검사가 대신하지 못하는 것
순서는 이렇게 둔다. 먼저 reset()과 step()이 반환 직전에 새 배열을 만들게 한다. 단일 배열이면 self._q.copy(), Dict 관측이면 바뀌지 않는 값까지 키마다 copy한다. [:]나 np.asarray()는 이 목적에 쓰지 않는다. 다음으로 2스텝 이상 쌓은 뒤 가장 오래된 원소를 첫 step의 실제 값과 비교하는 테스트를 둔다. 이 테스트는 Gymnasium 버전과 상관없이 동작하고, 마지막 칸만 보는 기존 테스트가 놓치는 경우를 잡는다. 세 번째로 Gymnasium 1.4.0 이상에서 check_env()를 CI에 넣는다. 이때 실패 메시지는 객체 공유를 알리는 것이지 이미 오염된 값을 증명하는 것은 아니다.
버퍼에 남은 값을 환경에서 실제로 일어난 일과 나란히 놓고 비교하는 점검은 관측 말고 행동과 종료 신호에도 필요하다. Box 행동 공간에서 SB3의 PPO·A2C가 범위를 넘은 행동을 잘라 환경에 넘겨도 롤아웃 버퍼에는 자르기 전 값이 남는 경로는 로봇 관절 속도를 가우시안 정책으로 뽑으면 왜 행동 범위를 넘을까에서, 추락과 시간 제한을 done 하나로 저장하면 목표값 계산이 어긋나는 문제는 로봇 강화학습 에피소드가 끝났을 때: 추락과 시간 제한의 목표값은 왜 다를까에서 숫자로 따라갈 수 있다.
이 근거로 말할 수 없는 것도 분명히 해 둔다. 관절 1개, float64 Box 관측의 설명용 환경만 확인했고, 학습 성능이나 보상 곡선에 미치는 영향은 재지 않았다. RLlib, TorchRL, CleanRL 같은 다른 라이브러리의 버퍼가 복사하는지, Dict 관측에서 일부 키만 재사용하는 경우, info 재사용이 실제로 남기는 피해도 확인하지 않았다. Gymnasium 1.4.0은 확인일 기준 사흘 전 배포라 이후 패치에서 검사 범위나 문구가 바뀔 수 있다.
실제 로봇으로 넘어갈 때는 하나를 더 기억한다. 버퍼와 로그의 관절각이 오염되면 그 기록으로 학습하거나 분석한 결론, 예컨대 “이 구간에서 관절은 정지해 있었다”가 사실과 다를 수 있다. 이 글의 테스트는 소프트웨어 데이터 무결성 확인일 뿐 속도 제한, 작업 공간 제한, 비상 정지(E-stop)를 대신하지 않는다. 정책을 실물에서 처음 돌릴 때는 시뮬레이션에서 먼저 확인하고, 제조사의 안전 절차와 하드웨어 비상 정지를 그대로 유지한다.
참고 링크
확인일은 모두 2026-10-08(KST)이다. Gymnasium·SB3·PyTorch 소스는 각 릴리스 태그의 고정 커밋이다.
- Gymnasium Env API — step·reset의 새 객체 요구
- Gymnasium v1.4.0 env_checker.py L273–L307 — 동일성 검사 함수, check_env 안의 호출 L482
- Gymnasium v1.4.0 passive_env_checker.py L221–L247 — 수동 검사기의 경고
- Gymnasium v1.4.0 릴리스 노트, PyPI gymnasium 1.4.0 — 2026-10-05 배포
- Stable-Baselines3 v2.9.0 buffers.py L265–L271 — 저장할 때 복사
- NumPy Copies and views, numpy.asarray, numpy.shares_memory
- Python FAQ: Why did changing list ‘y’ also change list ‘x’?
- OpenAI Spinning Up rl_intro.rst — 상태와 관측의 정의
- HuntLab 실험 results.json — 5회 실행 원본 출력과 환경 기록