시뮬레이션이 내 알고리즘 결과를 기다려 주게 하려면 얼마나 느리게 돌려야 할까: 처리 시간으로 real time factor 상한과 놓치는 카메라 프레임 비율 계산하기
Gazebo 속 로봇이 보내는 카메라 프레임을 인식 노드가 한 장에 0.25초씩 붙잡고 있으면, 결과가 나올 즈음 시뮬레이션은 이미 몇 프레임 앞에 가 있다. 그래서 시뮬레이션이 내 알고리즘 결과를 기다려 주게 하려면 real time factor(RTF, 실시간 배율)를 얼마까지 낮춰야 하는지, 그동안 버려지는 프레임은 몇 개인지가 궁금해진다. 필요한 값은 두 개뿐이다. 센서의 시뮬레이션 주기를 프레임 하나의 처리 시간으로 나눈 값이 RTF 상한이고, 16 Hz 카메라와 0.25초 노드라면 그 값은 0.25다.
그런데 제목의 ‘기다려 준다’는 표현은 반만 맞다. Gazebo Harmonic의 RTF는 목표 속도일 뿐이어서, 시뮬레이터는 노드가 계산을 끝냈는지 확인하지 않고 정한 속도로 계속 간다. RTF를 낮추면 프레임 사이의 실제 간격이 늘어나 처리할 틈이 생길 뿐이고, 처리 시간이 한 번이라도 그 틈을 넘으면 프레임은 그대로 버려진다. 평소 처리 시간으로 구한 상한 0.25에 맞춰 돌리고 네 번째 프레임마다 처리를 0.375초로 늘린 조건에서는, 32프레임 가운데 3개가 다섯 번 실행 모두에서 빠졌다. 이 숫자는 ROS 2 Jazzy 컨테이너에 Gazebo처럼 노드를 기다리지 않고 시간을 진행하는 가짜 시뮬레이터를 띄워 얻었고, 7개 조건 모두 처리한 프레임 수가 미리 계산한 값과 같았다. Gazebo 자체와 실물 로봇은 돌리지 않았으므로 이 일치는 ROS 2의 시간 전달과 구독 큐까지의 이야기다.
출발점은 Robotics Stack Exchange 질문 22917(2021년 11월 24일 작성)이다. 원 질문은 ROS 1과 Gazebo classic에서 ‘직전 계산 시점부터 현재 ROS 시각까지’를 반복해서 계산하는 노드였고 카메라 이야기는 없었다. 여기서는 같은 고민을 ROS 2 Jazzy와 Gazebo Harmonic 조합에서 흔한 형태, 즉 고정 주기 센서 프레임을 구독하는 노드로 옮겨 계산한다. 토픽 발행·구독, QoS의 keep last depth, Hz를 초 단위 주기로 바꾸는 계산(16 Hz → 1 ÷ 16 = 0.0625초)을 알면 따라올 수 있다.
시뮬레이터는 노드를 기다리지 않고 프레임 간격만 늘린다
먼저 시계 두 개를 구분해야 한다. 벽시계 시간(wall time)은 실제로 흐르는 시간이고, 노드의 계산은 이 시간을 쓴다. 시뮬레이션 시간(sim time)은 시뮬레이터가 물리 계산 스텝을 진행한 만큼만 흐르는 가상의 시간이다. ROS 2에서는 시뮬레이터가 /clock 토픽으로 현재 sim 시각을 알리고, 노드에 use_sim_time 파라미터를 켜면 그 노드의 ROS 시계가 마지막으로 받은 /clock 값을 돌려준다(ROS 2 Design — Clock and Time).
RTF는 sim 시간 경과를 벽시계 경과로 나눈 값이다. 1이면 실제와 같은 속도, 0.25이면 실제 1초 동안 sim 시간이 0.25초 흐른다. 같은 ROS 2 Design 문서는 정확도가 속도보다 중요한 복잡한 시스템에서 실시간보다 느린 시뮬레이션이 필요하다는 사용례도 적어 둔다. RTF 1.0이 ‘실시간 컴퓨팅’과 어떻게 다른지는 ROS 2 real time factor 1.0과 마감을 지키는 실시간 컴퓨팅을 구분한 글에서 따로 다뤘다.
카메라 센서가 sim 시간 기준으로 16 Hz, 즉 sim 0.0625초마다 프레임을 낸다고 하자. RTF가 1이면 프레임은 벽시계로도 0.0625초마다 도착한다. RTF를 0.25로 낮추면 sim 0.0625초가 흐르는 데 벽시계 0.25초가 걸리므로 프레임 도착 간격도 0.25초로 벌어진다. 처리할 시간이 생기는 원리는 이것이 전부다.
시뮬레이터가 이 간격을 어떻게 지키는지는 Harmonic의 시뮬레이션 엔진인 gz-sim8 코드에서 볼 수 있다. SimulationRunner.cc는 world의 physics 설정에서 스텝 크기와 RTF를 읽어 루프 한 번의 벽시계 주기를 스텝 크기 ÷ RTF로 정한다(SimulationRunner.cc L172-L213). 한 바퀴를 돌 때마다 다음 갱신 시각에 주기를 더하고, 이미 그 시각이 지났다면 ‘지금 + 주기’로 다시 잡는다(L993-L1000). 물리 계산이 늦으면 목표보다 느려질 수는 있어도, 외부 노드의 처리 완료를 기다리는 코드는 이 루프에 없다. 2026년 10월 14일 커밋을 읽은 결과이며 Gazebo를 실행해 확인하지는 않았다.
컨베이어 벨트에 비유하면 RTF를 낮추는 일은 벨트 속도를 늦추는 것과 같다. 상자 사이 간격이 넓어지니 작업자(노드)에게 여유가 생기지만, 작업자가 한 상자에 오래 붙잡혀 있어도 벨트는 멈추지 않는다. 비유가 맞지 않는 곳도 있다. 실제 시뮬레이터는 물리 계산이 무거우면 목표 RTF보다 더 느려지고, 넘친 상자는 구독자의 메시지 큐에서 버려지고, 그 큐의 규칙이 다음 계산을 정한다.
16 Hz 카메라와 0.25초 노드로 네 값을 계산한다
변수는 네 개다.
T[sim 초]: 센서의 sim 시간 기준 발행 주기. 16 Hz면 0.0625초.p[벽시계 초]: 노드가 프레임 하나를 처리하는 시간.r[단위 없음]: RTF.L[sim 초]: 돌리고 싶은 시뮬레이션 길이.
가정은 세 가지다. 센서는 sim 시간 기준으로 발행하고, 시뮬레이터는 목표 RTF를 실제로 달성하며, p는 RTF와 상관없이 일정하다.
- 프레임 도착 간격(벽시계)은
T ÷ r이다. - 프레임을 놓치지 않으려면
p ≤ T ÷ r이어야 하므로 RTF 상한은r ≤ T ÷ p다. - 처리 한 번 동안 도착하는 프레임 수는
p ÷ (T ÷ r) = p × r ÷ T다. - 그중 몇 개가 처리되는지는 구독 큐의 규칙에 달려 있다.
- 시뮬레이션
L초를 마치는 데 드는 벽시계 시간은L ÷ r이다.
4번의 큐 규칙이 QoS history다. keep last(최근 N개만 보관)는 구독 큐에 최신 N개만 남기고 오래된 것부터 버리며, N을 depth라고 부른다. depth가 1이면 처리를 마친 노드는 그사이 도착한 프레임 가운데 마지막 하나만 받는다. 그래서 처리되는 비율은 대략 min(1, T ÷ (p × r))이 된다(ROS 2 QoS 문서). 주의할 점이 있다. QoS를 지정하지 않은 구독의 기본값은 keep last depth 10, reliable이고, sensor data 프로필은 depth 5, best effort다(Jazzy rmw qos_profiles.h L25-L36, L51-L62). 아래 비율 식을 그대로 쓰려면 구독 QoS에 depth 1을 직접 적어야 한다.
이제 숫자를 넣는다. 처리 시간은 대부분의 프레임에서 0.25초이고, 가끔 0.375초까지 튄다고 가정한 설명용 예제다.
| 계산 | 식 | 값 |
|---|---|---|
| sim 주기 | 1 ÷ 16 | 0.0625초 |
| 평소 처리 시간 기준 RTF 상한 | 0.0625 ÷ 0.25 | 0.25 |
| RTF 1에서 처리 한 번 동안 도착 | 0.25 × 1 ÷ 0.0625 | 4개 (4개 중 1개 처리) |
| RTF 0.5에서 처리 한 번 동안 도착 | 0.25 × 0.5 ÷ 0.0625 | 2개 (2개 중 1개 처리) |
| RTF 0.25에서 처리 한 번 동안 도착 | 0.25 × 0.25 ÷ 0.0625 | 1개 (전부 처리) |
| 가장 긴 처리 시간 기준 RTF 상한 | 0.0625 ÷ 0.375 | 약 0.167 |
| RTF 0.25에서 0.375초 프레임 동안 도착 | 0.375 × 0.25 ÷ 0.0625 | 1.5개 |
| 상한 0.25에 20% 여유 | 0.25 × 0.8 | 0.2 |
| 60초 시뮬레이션을 RTF 0.25로 | 60 ÷ 0.25 | 벽시계 240초 |
0.25초를 ‘평균’이라고 부르지 않은 이유가 있다. 네 번에 한 번 0.375초가 섞이면 실제 평균은 0.28125초로 0.25초보다 길다. 평균으로 상한을 잡든 평소값으로 잡든, 가장 긴 프레임이 오는 순간에는 처리 한 번 동안 1.5개가 도착해 다시 뒤처진다.
표의 숫자는 Python 3.12.3에서 assert 10개로 검산한 산술이며, 로봇이나 시뮬레이터를 실행한 결과가 아니다. 계산 파일은 example.py, 실행 기록은 verification.json에 있다.
ROS 2 Jazzy에서 32프레임씩 세어 보니 예측과 같았다
식에는 ‘처리가 끝나면 큐의 최신 프레임 하나를 바로 꺼낸다’는 가정이 숨어 있다. 실제 rclpy 노드가 그렇게 동작하는지 보려고, 하네스가 ros:jazzy-ros-base 이미지에서 experiment.py를 5회 실행했다. 구성은 프로세스 두 개다.
- 가짜 시뮬레이터: sim 스텝(
T ÷ 16)마다/clock을 발행하고, 16스텝마다 프레임 하나(std_msgs/Header)를 발행한다. 벽시계 주기는스텝 ÷ 목표 RTF이고, 늦으면 다음 갱신 시각을 ‘지금 + 주기’로 다시 잡는다. 앞에서 읽은 gz-sim8 루프와 같은 방식이며 노드를 기다리지 않는다. 조건이 바뀔 때는 발행을 잠시 멈춰 남은 큐를 비운다. - 처리 노드: rclpy의 SingleThreadedExecutor로 돈다. executor(실행기)는 도착한 메시지와 타이머 이벤트를 골라 사용자 함수, 즉 콜백을 호출하는 반복 루프다. 구독은 RELIABLE, KEEP_LAST에 depth 1 또는 10이고, 콜백 안에서
time.sleep(p)로 벽시계p초를 쓴다. 한 조건(G)만 CPU를 계속 점유하며 시간만 확인하는 busy-wait로 바꿨다.
두 역할을 한 프로세스에 넣지 않은 데는 이유가 있다. 같은 executor에 두면 느린 콜백이 도는 동안 /clock 발행도 멈춰 sim 시간이 함께 서 버리고, 그러면 시뮬레이터와 노드가 서로 맞물려 도는 lockstep(한 쪽이 끝나야 다른 쪽이 진행하는 방식)을 재게 된다. 통신 계층은 ROS 2 기본 RMW(미들웨어 연결층)인 rmw_fastrtps_cpp로, 프로세스 사이 메시지를 DDS(발행·구독 데이터를 전달하는 표준 통신 미들웨어) 구현인 Fast DDS로 전달한다. 프레임 나이는 발행 시점의 CLOCK_MONOTONIC(시스템 시각 조정에 영향받지 않고 앞으로만 가는 시계) 값을 메시지에 실어 두고 콜백 시작 시각에서 뺐다.
예측값은 실행 전에 실험 계획(plan.md)에 적었다. 식과, 식을 프레임 단위로 따라가는 이산 사건 모델로 32프레임에서 몇 개가 처리될지를 계산한 값이다. 계획 단계에서 정한 것도 그대로 적어 둔다. 조건마다 sim 3초(48프레임)로 잡으면 실행 시간 한도 안에 busy-wait 조건과 처리 시간이 튀는 조건을 넣을 수 없어서 sim 2초(32프레임)로 줄였다. 가장 긴 처리 시간 기준 상한(약 0.167)은 조건 하나에 벽시계 12초가 들어 빼고, 20% 여유를 둔 RTF 0.2로 대신 확인했다. 첫 시험 실행은 종료 코드 0으로 끝났고, sim 경과 필드 이름이 설정 길이(2초)로 오해될 수 있어 실제 경과와 설정값을 나눈 뒤 다시 시험했다.
측정 환경: ros@sha256:066420e07f60aa18262f2479981def87ebcfcec42eefb0c0c57c4a46098348ca(ros:jazzy-ros-base), ROS 2 jazzy, Python 3.12.3, rclpy 7.1.12-1noble.20260902.053513, rmw_fastrtps_cpp(기본값), 네트워크 없음, 1 CPU·1 GiB. 5회 실행 모두 종료 코드 0. 실행한 스크립트의 SHA-256은 a055b86e9553933d888cac69bb8626228a3ba80afc178a480940c285586d3e9c다. 조건마다 32프레임을 발행했고, 시뮬레이터가 실제로 진행한 sim 시간은 1.941406초다.
| 조건 | 목표 RTF | depth | 콜백 처리 | 예측 처리 수 (plan.md) | 실측 처리 수 (5회) | 놓친 수 | 달성 RTF (1회차) | sim 구간 벽시계 (1회차) | 프레임 나이 최대 (1회차) |
|---|---|---|---|---|---|---|---|---|---|
| A | 1 | 1 | sleep 0.25초 | 9 | 5회 모두 9 | 23 | 1.0019 | 1.9378초 | 0.0685초 |
| B | 0.5 | 1 | sleep 0.25초 | 17 | 5회 모두 17 | 15 | 0.501 | 3.8754초 | 0.1366초 |
| C | 0.25 | 1 | sleep 0.25초 | 32 | 5회 모두 32 | 0 | 0.2505 | 7.7504초 | 0.0224초 |
| D | 1 | 10 | sleep 0.25초 | 18 | 5회 모두 18 | 14 | 1.0019 | 1.9378초 | 2.3249초 |
| E | 0.25 | 1 | 0.25초, 네 번째 프레임마다 0.375초 | 29 | 5회 모두 29 | 3 | 0.2505 | 7.7503초 | 0.1452초 |
| F | 0.2 | 1 | E와 같음 | 32 | 5회 모두 32 | 0 | 0.2004 | 9.6878초 | 0.0638초 |
| G | 0.5 | 1 | busy-wait 0.25초 | 17 | 5회 모두 17 | 15 | 0.501 | 3.8753초 | 0.1342초 |
식 하나로 낸 비율과 실측 비율도 나란히 둔다. A는 식 0.25에 실측 0.2812, B는 식 0.5에 실측 0.5312, C는 식 1.0에 실측 1.0이다. D는 depth 10이라 식의 전제(depth 1)를 벗어나며, 식 0.25에 실측 0.5625였다.
1회차 원본 출력 가운데 A, D, E와 마지막 요약 줄을 그대로 옮긴다.
{"condition": "A", "target_rtf": 1.0, "depth": 1, "processing": "sleep", "spike_every": 0, "sim_length_nominal": 2.0, "sim_elapsed_seconds": 1.941406, "published": 32, "processed": 9, "dropped": 23, "processed_ratio": 0.2812, "formula_ratio": 0.25, "rtf_bound_normal": 0.25, "rtf_bound_worst": 0.1667, "model_processed": 9, "model_dropped": 23, "achieved_rtf": 1.0019, "sim_wall_seconds": 1.9378, "sim_late_steps": 0, "sim_steps": 497, "callback_p_mean": 0.2501, "callback_p_max": 0.2501, "frame_age_wall_mean": 0.0103, "frame_age_wall_max": 0.0685, "result_latency_wall_max": 0.3186, "result_latency_sim_max": 0.3193, "processed_ids": [0, 4, 8, 12, 16, 20, 24, 28, 31], "missed_ids": [1, 2, 3, 5, 6, 7, 9, 10, 11, 13, 14, 15, 17, 18, 19, 21, 22, 23, 25, 26, 27, 29, 30], "model_ids": [0, 4, 8, 12, 16, 20, 24, 28, 31]}
{"condition": "D", "target_rtf": 1.0, "depth": 10, "processing": "sleep", "spike_every": 0, "sim_length_nominal": 2.0, "sim_elapsed_seconds": 1.941406, "published": 32, "processed": 18, "dropped": 14, "processed_ratio": 0.5625, "formula_ratio": 0.25, "rtf_bound_normal": 0.25, "rtf_bound_worst": 0.1667, "model_processed": 18, "model_dropped": 14, "achieved_rtf": 1.0019, "sim_wall_seconds": 1.9378, "sim_late_steps": 0, "sim_steps": 497, "callback_p_mean": 0.2501, "callback_p_max": 0.2501, "frame_age_wall_mean": 1.0098, "frame_age_wall_max": 2.3249, "result_latency_wall_max": 2.5751, "result_latency_sim_max": 2.58, "processed_ids": [0, 1, 2, 3, 7, 11, 15, 19, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31], "missed_ids": [4, 5, 6, 8, 9, 10, 12, 13, 14, 16, 17, 18, 20, 21], "model_ids": [0, 1, 2, 3, 7, 11, 15, 19, 22, 23, 24, 25, 26, 27, 28, 29, 30, 31]}
{"condition": "E", "target_rtf": 0.25, "depth": 1, "processing": "sleep", "spike_every": 4, "sim_length_nominal": 2.0, "sim_elapsed_seconds": 1.941406, "published": 32, "processed": 29, "dropped": 3, "processed_ratio": 0.9062, "formula_ratio": null, "rtf_bound_normal": 0.25, "rtf_bound_worst": 0.1667, "model_processed": 29, "model_dropped": 3, "achieved_rtf": 0.2505, "sim_wall_seconds": 7.7503, "sim_late_steps": 0, "sim_steps": 497, "callback_p_mean": 0.2846, "callback_p_max": 0.3752, "frame_age_wall_mean": 0.0793, "frame_age_wall_max": 0.1452, "result_latency_wall_max": 0.5203, "result_latency_sim_max": 0.1303, "processed_ids": [0, 1, 2, 3, 4, 5, 6, 7, 9, 10, 11, 12, 13, 14, 15, 17, 18, 19, 20, 21, 22, 23, 25, 26, 27, 28, 29, 30, 31], "missed_ids": [8, 16, 24], "model_ids": [0, 1, 2, 3, 4, 5, 6, 7, 9, 10, 11, 12, 13, 14, 15, 17, 18, 19, 20, 21, 22, 23, 25, 26, 27, 28, 29, 30, 31]}
{"summary": true, "total_wall_seconds": 46.82, "python": "3.12.3"}
처리한 개수는 회차마다 같았고, 몇몇 회차에서 처리한 프레임 번호만 달라졌다. 2회차 B는 시뮬레이터가 주기를 한 번 놓쳐(sim_late_steps 1) 달성 RTF가 0.4969로 내려갔고, 20번 이후로는 짝수 대신 홀수 번호 프레임을 처리했지만 개수는 17이었다. 3회차 D도 주기를 두 번 놓쳐 달성 RTF가 0.9927이었고, 15·19번 대신 14·18번을 처리했지만 개수는 18이었다. 4회차 E는 콜백 한 번이 0.4094초까지 늘었는데도 놓친 프레임은 다른 회차와 같은 8·16·24번이었다.
7개 조건의 처리 수가 다섯 번 모두 예측과 같았다. 예상 밖의 결과는 없었고, 그럴 만한 구성이기도 했다. 가짜 시뮬레이터는 식의 가정대로 목표 RTF를 거의 정확히 지켰고 처리 시간은 sleep으로 고정했다. 이 결과가 말해 주는 범위는 rclpy와 Fast DDS를 거치는 keep last 구독이 ‘처리가 끝나면 큐에 남은 것을 꺼낸다’는 모델대로 움직인다는 데까지다. 코드로도 일치한다. rclpy Jazzy의 executor는 콜백을 실행하기 직전에 메시지를 꺼내므로, 콜백이 도는 동안 도착한 프레임은 미들웨어 큐에 남아 keep last 규칙을 적용받는다(executors.py L467-L470, L575-L588).
A의 실측 비율이 식보다 조금 높은 것은 끝 효과다. 처리한 프레임 번호는 0, 4, 8, …, 28로 정확히 네 개에 하나씩이었고, 마지막 31번은 발행이 끝난 뒤 큐에 남아 있다가 처리됐다. 32프레임처럼 짧은 구간에서는 이 한 개가 비율을 눈에 띄게 움직인다. busy-wait 조건 G가 B와 같게 나온 것도 해석에 범위가 있다. 여기서는 가벼운 Python 시뮬레이터와 처리 노드가 CPU 하나를 나눠 써도 달성 RTF가 내려가지 않았다는 뜻이고, 물리 계산과 렌더링을 하는 Gazebo가 같은 CPU를 쓸 때도 그렇다는 근거는 아니다.
C의 sim 구간 벽시계는 A의 네 배였다. 기다림의 값은 결국 벽시계 시간으로 치르고, 60초 시뮬레이션이라면 RTF 0.25에서 240초, 0.2에서 300초가 된다.
같은 측정을 직접 돌리려면 Docker만 있으면 된다. 아래 명령은 하네스와 같은 고정 이미지 다이제스트와 조건을 쓴다. 이미지를 처음 받을 때는 인터넷 연결이 필요하고, 컨테이너 안에서는 네트워크를 쓰지 않는다.
mkdir rtf-budget && cd rtf-budget
curl -fsSLO https://raw.githubusercontent.com/sungpyo9053/blog/54f040859b911c3d8750424c846cd83d81091556/experiments/ros2-slow-simulation-real-time-factor-processing-budget/experiment.py
sha256sum experiment.py
docker run --rm --network none --cpus 1 --memory 1g -v "$PWD":/work ros@sha256:066420e07f60aa18262f2479981def87ebcfcec42eefb0c0c57c4a46098348ca bash -c "source /opt/ros/jazzy/setup.bash && python3 /work/experiment.py"
sha256sum은 a055b86e9553933d888cac69bb8626228a3ba80afc178a480940c285586d3e9c를 출력해야 한다. 정상이라면 조건 A부터 G까지 JSON 일곱 줄과 "summary": true 한 줄이 나오고 종료 코드는 0이다. 각 줄의 processed가 model_processed와 같거나 1~2개 안에서 다르면 식과 모델이 자기 환경에서도 맞는다고 본다. 시뮬레이터 프로세스가 구독자를 15초 안에 찾지 못하면 {"error": "subscriber discovery timeout"} 한 줄만 출력되고 종료 코드는 3이 된다. 하네스가 실행한 5회의 원본 출력은 results.json에, 계획과 재현 안내는 실험 디렉터리에 공개돼 있다.
depth를 10으로 늘리면 손실이 지연으로 바뀐다
프레임을 덜 버리고 싶어 depth부터 늘리는 경우가 많다. D 조건의 처리 번호를 보면 그 효과가 어디서 오는지 보인다. 처음 0~3번은 큐가 넘치기 전이라 차례로 처리됐다. 큐 열 칸이 찬 뒤로는 오래된 프레임부터 밀려나, 7, 11, 15, 19번처럼 A와 똑같이 네 개에 하나꼴로 처리됐다. 처리 속도는 여전히 ‘0.25초에 하나’로 묶여 있었다. 22번부터 31번까지 열 개는 발행이 멈춘 뒤 큐에 쌓여 있던 것을 차례로 꺼낸 것이다.
32프레임 측정에서 D의 처리 수가 A의 두 배가 된 것은 이 마지막 큐 비우기 때문이다. 시뮬레이션이 길어지면 이 몫은 depth 크기 정도로 고정되므로 비율 차이는 줄어든다. Research 단계에서 같은 모델로 960프레임을 계산했을 때 depth 1은 241개, depth 10은 250개였다.
대신 치르는 값은 신선도다. 측정 표에서 D가 처리한 프레임의 나이는 최대 2초를 넘었고, A는 도착 간격 하나 남짓이었다. RTF 1에서라면 노드가 2초 넘게 지난 장면을 보고 판단한 셈이다. 큐가 가득 찬 뒤로는 결과 지연이 대략 depth × p만큼 커진다. keep all(미들웨어 자원 한도까지 전부 보관)로 바꾸면 큐가 계속 자라 지연이 누적된다. 그래서 depth는 손실을 지연과 바꾸는 손잡이다. 결과를 놓치지 않으려면 depth가 아니라 RTF를 조정해야 한다.
가끔 튀는 처리 시간은 상한 그대로의 RTF를 무너뜨린다
E와 F는 평소에는 0.25초, 네 번째 프레임마다(3, 7, 11, … 번) 0.375초가 걸리는 노드다. RTF 0.25는 평소 처리 시간으로 계산한 상한 그대로이고, 0.2는 거기에 20% 여유를 둔 값이다.
E에서 놓친 프레임은 5회 모두 8, 16, 24번이었다. 빠진 쪽이 튀는 프레임(7, 15, 23번)의 바로 다음 번호인 이유는 시간표를 따라가면 보인다. RTF 0.25에서 프레임은 벽시계 0.25초마다 도착한다.
- 3번 프레임이 0.375초 걸리면서 처리가 도착 간격보다 0.125초 밀린다. 4번은 큐 한 칸에서 기다렸다가 처리된다.
- 4~6번은 정확히 0.25초씩 걸린다. 도착 간격과 같으니 밀린 0.125초는 줄지 않는다.
- 7번이 다시 0.375초 걸리면 밀림은 0.25초, 즉 도착 간격 하나만큼이 된다. 7번 처리가 끝나는 순간 9번이 도착해 큐에서 기다리던 8번을 밀어낸다.
- 9번부터는 밀림 없이 다시 시작하고, 같은 일이 16번과 24번에서 되풀이된다.
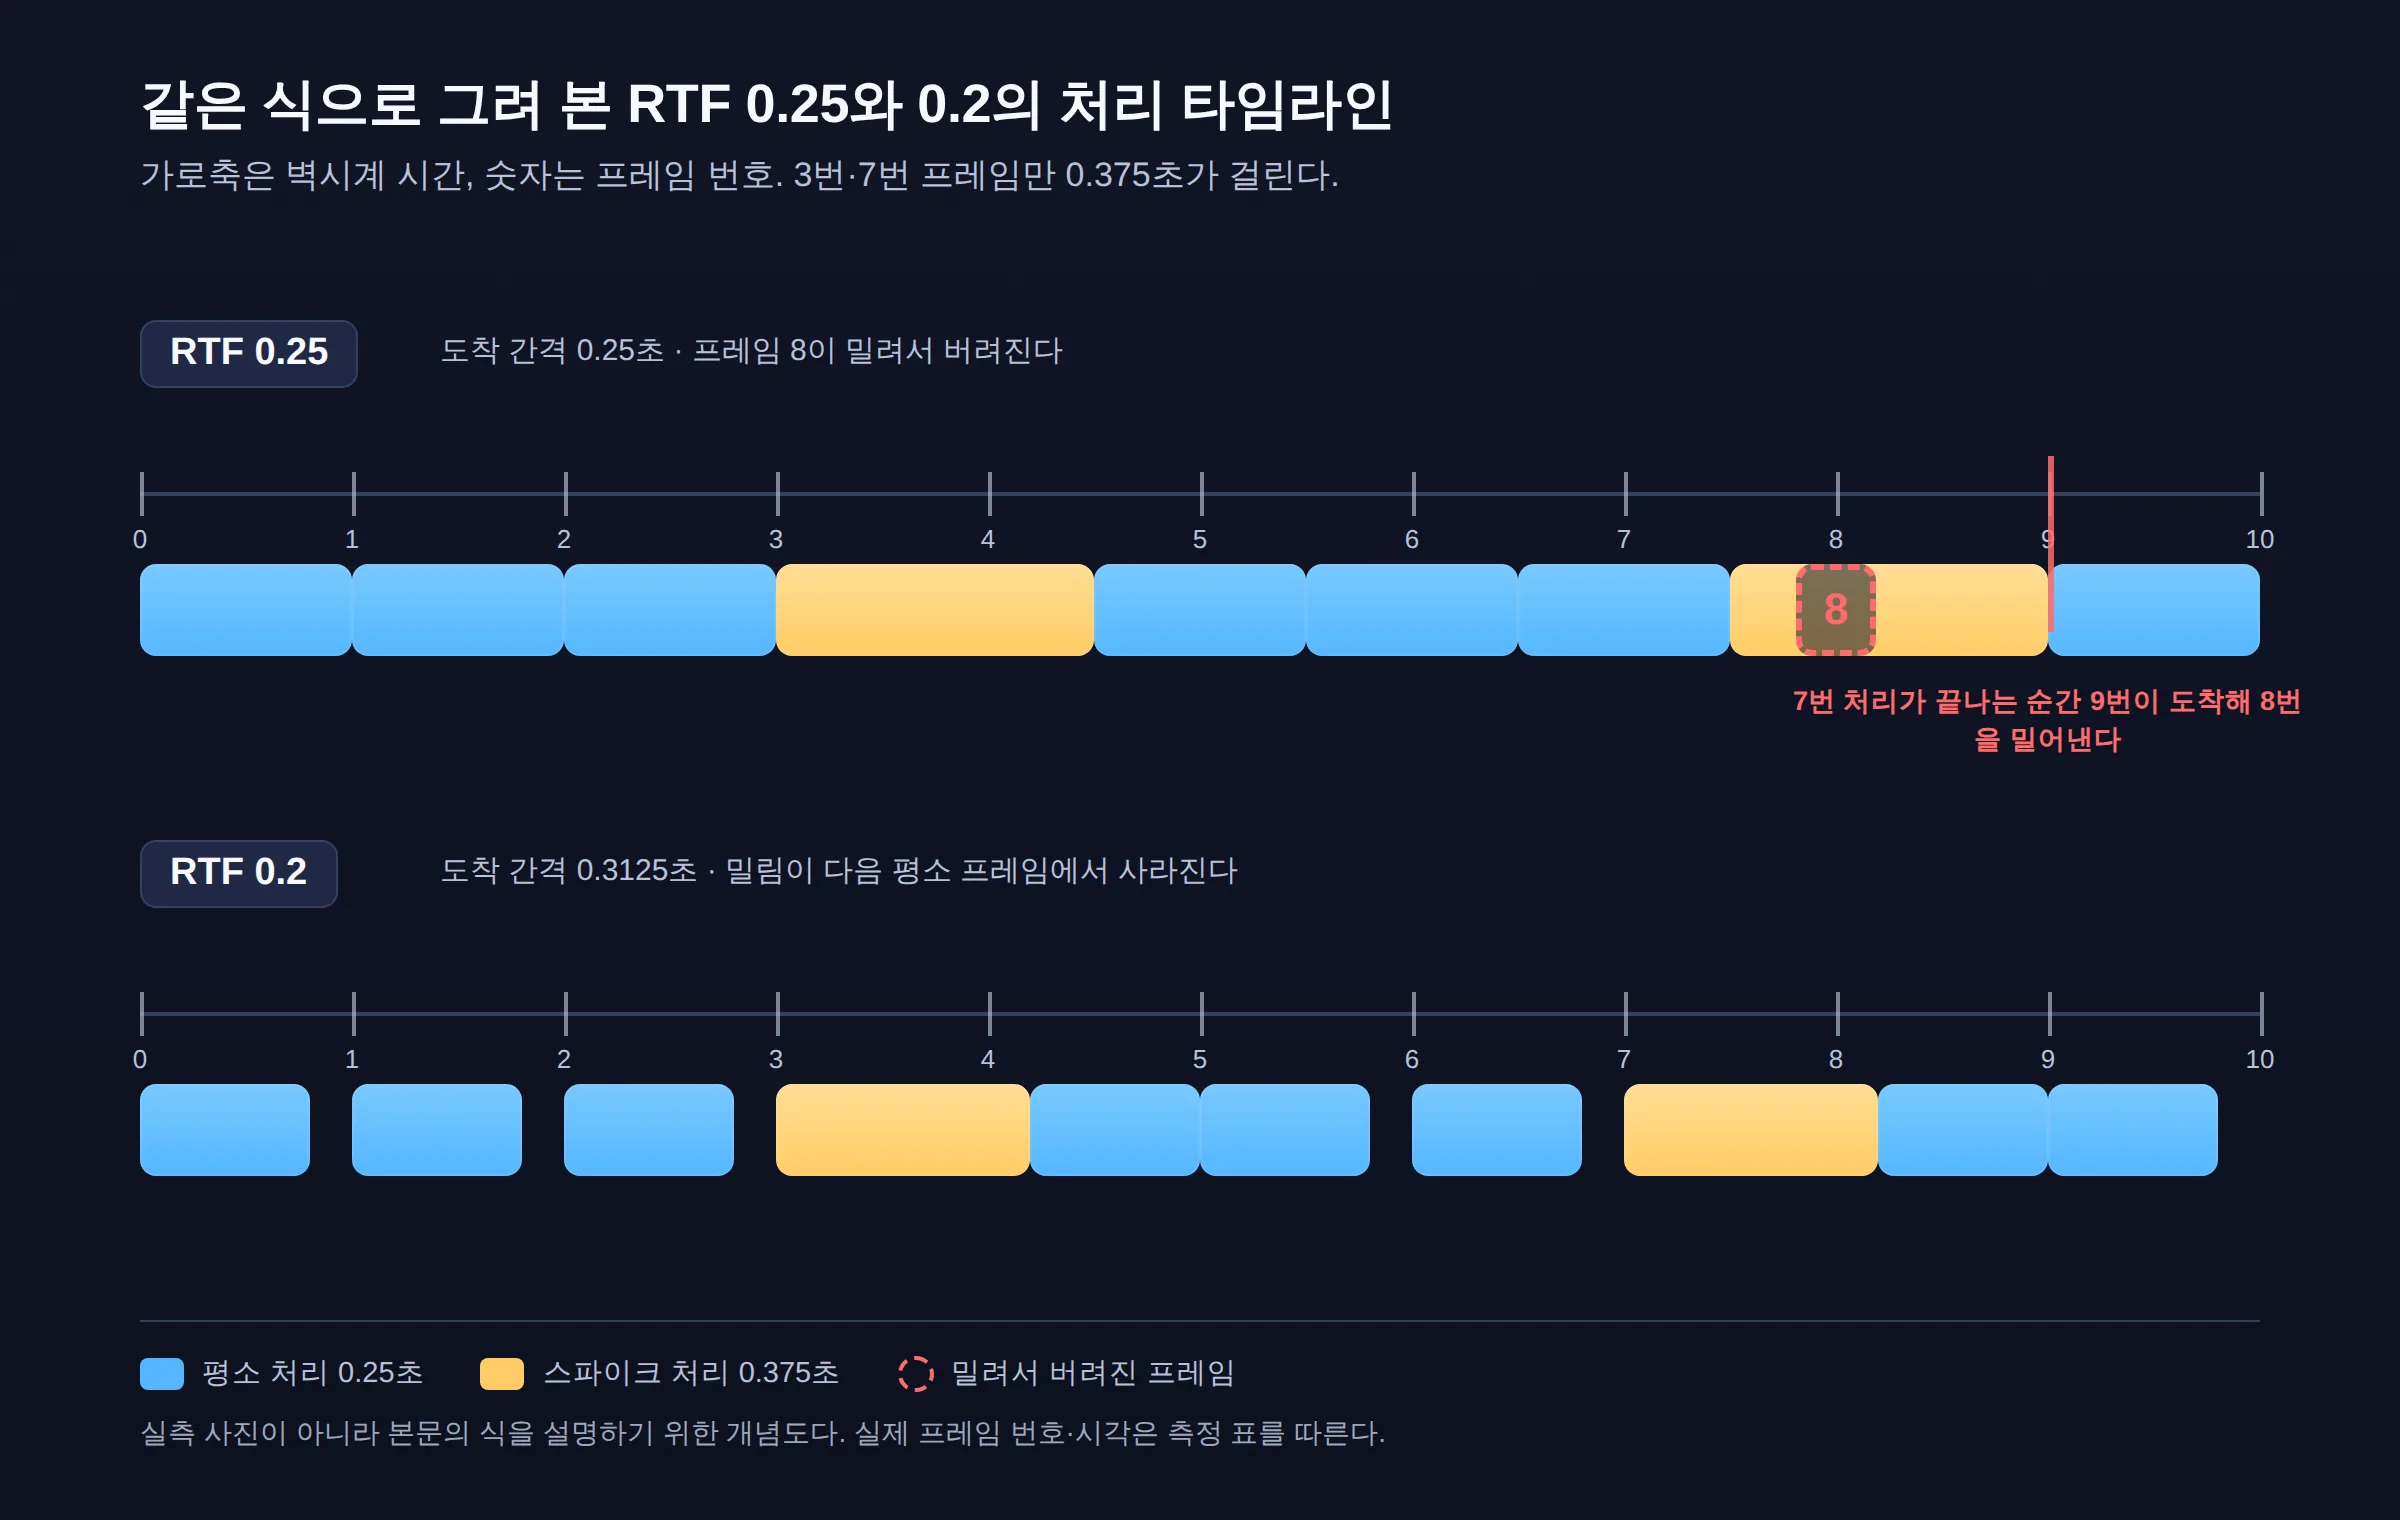
큐 한 칸은 도착 간격 하나보다 작은 밀림까지만 흡수한다. 평소 처리 시간이 도착 간격과 딱 맞으면 밀림을 갚을 틈이 없어서, 튀는 프레임 두 번이면 한 장이 빠진다.
RTF 0.2에서는 도착 간격이 0.3125초로 늘어난다. 평소 프레임마다 0.0625초씩 남고, 튀는 프레임이 넘긴 0.0625초는 다음 평소 프레임에서 바로 갚아진다. F가 손실 0이었고 프레임 나이 최대가 이 0.0625초 언저리에 머문 것이 계산과 맞는다.
가장 긴 처리 시간으로 잡은 상한(약 0.167)은 손실 0을 보장하는 충분조건이지 유일한 답은 아니다. F의 0.2는 그보다 높은데도 손실이 없었다. 튀는 프레임이 드물고 그 뒤에 따라잡을 여유가 있었기 때문이다. 다만 이 판단은 처리 시간이 어떻게 분포하느냐에 달려 있고, 이 측정은 ‘네 번에 한 번’ 패턴 하나만 확인했다. 튀는 프레임이 연달아 오면 결과가 달라질 수 있다. 자기 노드의 처리 시간 분포를 모른다면 가장 긴 값으로 상한을 계산하고 여유를 두는 쪽이 안전한 출발점이다. 평소값 상한을 그대로 쓰는 RTF는 E처럼 경계에서 무너진다.
손으로 풀어 볼 확인 문제
문제 1. 처리 시간이 항상 0.2초인 노드가 16 Hz 카메라를 keep last 1로 구독한다. 프레임을 놓치지 않는 RTF 상한은 얼마이고, RTF 1에서는 대략 몇 %를 처리할까?
답: 상한은 0.0625 ÷ 0.2 = 0.3125다. RTF 1에서 처리 비율은 0.0625 ÷ (0.2 × 1) = 0.3125, 약 31%다. 상한과 비율이 같은 숫자인 것은 우연이 아니다. RTF 1에서는 T ÷ (p × r)가 T ÷ p와 같아진다. 0.2초는 0.0625초의 정수배가 아니지만, Research의 960프레임 모델에서도 301개를 처리해 이 근사가 유지됐다.
문제 2. 처리 시간이 항상 0.25초인 노드로 60초 시뮬레이션을 RTF 0.2에서 돌린다. 놓치는 프레임과 걸리는 시간은?
답: 처리 한 번 동안 도착하는 프레임은 0.25 × 0.2 ÷ 0.0625 = 0.8개로 1보다 작으니 놓치는 프레임은 없다. 벽시계로는 60 ÷ 0.2 = 300초가 걸린다. 상한 0.25를 쓸 때보다 60초를 더 쓰는 대신 처리 시간이 조금 흔들려도 견딜 여유를 산다.
문제 3. RTF 1을 유지한 채 depth를 5로 올리면 손실 문제가 풀릴까?
답: 풀리지 않는다. 처리 속도는 여전히 0.25초에 하나라서 처리 수는 거의 같고, 큐가 찬 뒤 결과 지연이 대략 5 × 0.25 = 1.25초 수준으로 커진다. Research 모델에서는 960프레임 가운데 245개를 처리했다.
Gazebo Harmonic에서 RTF를 바꾸는 곳, 그리고 정말 멈춰 세우는 방법
Gazebo 공식 문서는 Ubuntu 24.04와 ROS 2 Jazzy에 Gazebo Harmonic을 권장 조합으로 표시하고(Installing Gazebo with ROS), Harmonic은 gz-sim8을 쓴다(gazebodistro collection-harmonic.yaml). 계산한 RTF를 넣는 자리는 두 곳이다.
- world 파일: SDF의
<physics>안에 있는<real_time_factor>가 목표 RTF다. SDFormat 명세는 이를 ‘sim 시간 대 실제 시간의 비율로 정한 목표 속도’로 정의하고 기본값을 1.0,<max_step_size>기본값을 0.001초로 둔다(SDFormat 1.11 physics.sdf L17-L30). - 실행 중: UserCommands 시스템이
/world/<world 이름>/set_physics서비스를gz.msgs.Physics타입으로 연다(UserCommands.cc L640-L642). 기본 서버 구성에는 이 시스템이 들어 있지만(server.config), world 파일이 자체 plugin 목록을 지정하면 빠질 수 있으니gz service -l로 서비스가 있는지 먼저 본다. 새 RTF는 0보다 클 때만 반영된다.
서비스 이름과 메시지 타입을 소스 코드로 맞춰 본 호출 형태는 다음과 같다. 실행해서 확인한 명령은 아니며, max_step_size를 함께 보내지 않을 때의 동작도 확인하지 않았다.
gz service -s /world/<world 이름>/set_physics --reqtype gz.msgs.Physics --reptype gz.msgs.Boolean --timeout 2000 --req 'real_time_factor: 0.2'
2025년 1월 지원이 끝난 Gazebo classic은 방식이 다르다. 공식 튜토리얼은 max_step_size × real_time_update_rate가 RTF의 상한을 정한다고 설명하므로, RTF 0.25를 원하면 예컨대 0.001초 × 250으로 맞춘다(Gazebo classic Physics Parameters). 원 질문에서 가장 높은 점수를 받은 답변(Tully, 2021년 11월 24일)은 physics의 real_time_factor를 조정하라고 했는데, classic에서 그 요소가 단독으로 무엇을 하는지는 소스를 확인하지 못해 단정하지 않는다.
정말로 ‘결과가 나올 때까지 멈춰 세우는’ 장치는 RTF가 아니다. gz-sim은 /world/<world 이름>/control 서비스로 일시정지, 한 스텝 진행, multi_step(정한 스텝 수만큼 진행), run_to_sim_time을 받는다(SimulationRunner.cc L322-L327, L1338-L1356, run_to_sim_time은 L1375-L1379). 노드가 처리를 마치면 시뮬레이터를 N 스텝 진행시키고 다시 멈추는 식으로 둘을 맞물리게 하면(lockstep) 모든 프레임을 처리할 수 있다. 이 방식에서는 RTF 계산이 필요 없지만 시뮬레이션 속도가 가장 느린 노드에 묶이고, 구현은 이 글에서 다루지 않는다.
원 질문의 루프는 성격이 조금 다르다. ‘직전 계산 시점부터 지금까지’를 한 번에 계산하고 계산 시간이 구간 길이에 비례한다고 가정하면, 계산 시간이 a + b × 구간(벽시계)일 때 다음 구간은 r × 계산 시간이 된다. 이 반복은 r × b < 1이면 일정한 구간으로 수렴하고, 그렇지 않으면 구간이 끝없이 길어진다. 예를 들어 a = 0.2초, b = 0.5라면 RTF 1에서는 0.4초로 수렴하지만 RTF 2.5에서는 발산한다. 이 경우 프레임이 버려지지는 않고 계산 구간이 늘어나며, RTF를 낮추면 수렴 쪽으로 돌아온다. 질문자의 실제 계산 비용 구조는 원문에 없으므로 이 설명은 가정 위의 계산이다.
실물 로봇에서는 시간을 늦출 수 없다
RTF를 낮추는 해법은 시뮬레이션 안에서만 통한다. 앞의 답변자도 시간을 늦출 수 없는 실물에서는 정보를 건너뛰어 최신 상태를 유지하도록 알고리즘을 바꾸는 편이 낫다고 덧붙였다. RTF 0.2에서 모든 프레임을 처리했다는 결과는 같은 노드가 실제 16 Hz 카메라를 따라간다는 증거가 아니다. 실물에서는 처리 시간이 0.0625초를 넘는 순간 손실이나 지연이 그대로 생기고, 그 결과로 제어 명령을 내면 로봇은 지난 장면을 근거로 움직인다. 이 글은 실물 실험을 안내하지 않는다. 시뮬레이션에서 만든 노드를 실물로 옮긴다면 적어도 처리 결과의 타임스탬프 나이를 확인해 정한 한도보다 오래된 결과로는 명령을 내지 않거나 정지하게 하고, 비상 정지 수단을 손 닿는 곳에 둔다.
시뮬레이션 안에서도 계산이 어긋날 수 있는 지점이 남아 있다.
- 처리 시간이 RTF와 무관하다고 가정했다. 실제로는 시뮬레이터와 노드가 CPU를 나눠 쓰므로 RTF를 바꾸면 처리 시간도 바뀔 수 있다. 측정은 가벼운 가짜 시뮬레이터로만 했다.
- 시뮬레이터가 목표 RTF를 달성한다고 가정했다. 물리 계산이 무거운 world에서는 실제 RTF가 목표보다 낮아지고, 그만큼 여유가 더 생긴다.
- keep last 1 계산은 ‘콜백 직전에 메시지를 꺼내는’ 클라이언트 라이브러리를 전제로 한다. rclpy Jazzy는 코드로 확인했지만, ros2_rust에서는 메시지를 즉시 꺼내 별도 큐에 쌓아 keep last 1이 적용되지 않는다는 미해결 보고가 있다(ros2_rust issue #725). HuntLab이 재현한 내용은 아니고, rclcpp도 코드로 확인하지 않았다.
느린 인식 알고리즘이 매 프레임에서 정확한지 오프라인으로 검증하려는 경우라면, 자기 노드의 콜백 시간을 기록해 가장 긴 값으로 T ÷ p 상한을 구하고 여유를 둔 RTF로 돌리는 방법이 맞다. 반대로 로봇이 실제 속도에서 어떻게 반응하는지 보려는 시험이라면 RTF를 낮추는 순간 그 시험의 의미가 사라진다. 그때는 RTF 1에서 프레임을 건너뛰는 설계를 검증하고, 모든 프레임을 결정적으로 처리해야 한다면 lockstep으로 간다. RTF를 반대로 높여 빨리 돌릴 때 타임스탬프가 얼마나 어긋나는지는 ROS 2 시뮬레이션을 10배속으로 돌릴 때의 타임스탬프 오차를 계산한 글이 이어지는 질문을 다룬다.
확인한 자료와 버전
모든 자료는 2026년 10월 15일(KST)에 확인했다. GitHub 코드는 링크에 적힌 고정 커밋 기준이다.
- ROS 2 Design — Clock and Time: sim time,
/clock,use_sim_time, RTF 정의, 느린 시뮬레이션 사용례. - ROS 2 Documentation — Quality of Service settings (rolling)와 Jazzy rmw qos_profiles.h: keep last, depth, keep all, 기본 프로필.
- SDFormat 1.11 physics.sdf와 gz-sim8 SimulationRunner.cc: RTF가 루프 주기를 정하는 방식.
- rclpy Jazzy executors.py L467-L470: 구독에서 메시지를 꺼내는(take) 지점. L900-L916: SingleThreadedExecutor의
_spin_once_impl이 준비된 handler를 바로 호출하는 지점. - Robotics Stack Exchange 질문 22917과 그 답변: 독자 질문의 출발점이며, 사양 근거로는 쓰지 않았다.
- 자체 검산: example.py, verification.json.
- 실측: experiment.py, results.json.
QoS 호환성 때문에 메시지가 아예 오지 않는 상황이라면 이 계산보다 먼저 ROS 2 QoS 호환성을 계산하는 글부터 확인한다.