Gazebo 고해상도 카메라 센서를 넣었더니 시뮬레이션이 느려질 때: 해상도·fps·QoS depth로 이미지 토픽이 초당 몇 MB를 내보내는지 먼저 계산하기
Gazebo Harmonic에 4512×4512 해상도, 형식 R8G8B8, update_rate 19인 카메라를 단 사람이 있다. Gazebo 명령줄 도구 gz topic이나 이미지를 ROS 2 토픽으로 넘겨 주는 ros_gz_image로 카메라 토픽을 구독하는 순간 실시간 비율(real time factor, RTF)이 약 100%에서 20%로 떨어졌고, CPU와 GPU는 둘 다 최대 부하가 아니었다고 한다. 2025년 2월 Robotics Stack Exchange에 올라온 이 질문(API 원문)은 2026년 10월 29일 확인 기준으로 조회 860회, 답변 0개다. Gazebo 고해상도 카메라 센서가 시뮬레이션을 느리게 할 때 해상도를 얼마나 낮출지 정하기 전에, 이 토픽이 초당 몇 MB를 내보내야 하는지는 곱셈 몇 번으로 나온다. 한 프레임 약 61.07 MB, 시뮬레이션 1초에 약 1160.4 MB다.
질문에 적힌 “구독하는 순간”이라는 조건이 이 숫자를 어디에 써야 하는지 정한다. Gazebo 소스에서 카메라는 구독자가 생겨야 렌더링을 시작하므로, 구독 전후의 차이에는 메시지 전송뿐 아니라 렌더링과 GPU→CPU 복사(GPU가 그린 픽셀을 CPU 메모리로 읽어 오는 일)가 함께 들어 있다. 메시지 경로만 떼어 보려고 Gazebo 없이 같은 크기의 합성 이미지를 1 CPU 컨테이너에서 보냈더니, 받지 못한 메시지를 다시 보내는 reliable 구독자는 640×480부터 1920×1080까지 30 Hz에서 5회 모두 계산값의 0.993–1.012배를 받았다. 놓친 메시지를 버리는 best effort 구독자는 같은 해상도에서도 회차에 따라 계산값의 0.624배까지 떨어졌고, 3840×2160과 질문자 크기는 발행 단계부터 목표 주기를 지키지 못했다. 곱셈은 토픽이 감당해야 할 양의 기준선이고, 실제로 그만큼 오가는지는 QoS와 프레임 크기에 따라 달랐다. 아래에서 자기 설정의 초당 MB와 큐 상한을 구한 뒤, 느려진 원인이 렌더링 쪽인지 메시지 쪽인지 나누는 순서로 이어 간다.
한 프레임은 가로 × 세로 × 픽셀당 바이트다
ROS 2 토픽을 발행하고 구독해 본 적이 있고 곱셈을 할 수 있으면 충분하다. 단위는 ros2 topic bw가 쓰는 것과 같이 1 MB = 1,000,000 바이트로 둔다. 1 MiB(1,048,576 바이트)와 섞으면 같은 값이 몇 퍼센트씩 달라 보인다.
해상도(resolution)는 가로 픽셀 수(width)와 세로 픽셀 수(height)다. 초당 프레임(frames per second, fps)은 Gazebo가 월드와 센서를 적는 설정 형식인 SDF(Simulation Description Format)에서 센서의 update_rate가 맡는다. SDFormat 명세는 update_rate를 “센서 데이터가 생성되는 빈도”로 정의하고, 값을 주지 않으면(기본 0) 매 시뮬레이션 사이클마다 생성한다고 적는다(sensor.sdf). 계산에 넣을 fps를 모르겠다면 SDF에서 이 값부터 찾는다. 이 주기는 시뮬레이션 시간 기준이다.
인코딩(encoding)은 픽셀 한 칸이 몇 개의 채널을 몇 비트로 담는지를 뜻한다. ROS 2의 rgb8은 빨강·초록·파랑 3채널을 8비트씩 담으므로 픽셀당 3바이트다(image_encodings.hpp). Gazebo 기본 카메라가 이 3바이트를 쓴다는 것은 소스에서 세 단계로 따라가 확인할 수 있다.
- SDF
<image><format>의 기본값은R8G8B8이다(camera.sdf). - Gazebo의 센서 라이브러리 gz-sensors는 이 형식을
RGB_INT8로 내보낸다(CameraSensor.cc). - Gazebo 토픽과 ROS 2 토픽을 이어 주는 ros_gz_bridge는
RGB_INT8을rgb8로 바꾸고, 한 줄의 바이트 수인step을width × 3으로 채운 뒤step × height만큼 데이터를 잡는다(sensor_msgs.cpp, L167–L169).
sensor_msgs/Image 정의도 데이터 크기를 step * rows로 적고 있다(Image.msg). 압축하지 않은 이미지이므로 식은 다음 두 줄로 끝난다.
프레임 바이트 = width × height × 픽셀당 바이트
초당 MB      = 프레임 바이트 × fps ÷ 1,000,000
1920×1080이면 2,073,600 픽셀, rgb8로 6,220,800 바이트이고 30 fps에서 초당 186.624 MB다. 네트워크 장비 쪽 단위인 비트로 바꾸면 약 1493 Mb/s이고, MiB로 표기하면 약 177.98 MiB/s다. 같은 토픽인데 단위에 따라 세 숫자가 나오므로, 남의 글과 비교할 때는 단위부터 맞춘다.
질문자 설정을 넣으면 4512 × 4512 × 3 = 61,074,432 바이트, 약 61.07 MB가 한 프레임이다. 19를 곱하면 초당 1,160,414,208 바이트, 약 1160.4 MB다. 가로와 세로를 각각 절반(2256×2256)으로 줄이면 픽셀 수가 두 방향에서 함께 줄어 한 프레임 약 15.27 MB, 초당 약 290.1 MB로 정확히 1/4이 된다. 1920×1080을 640×480으로 낮추면 6.75배가 줄지만, 이 경우는 16:9에서 4:3으로 화면 비율까지 바뀌므로 “같은 장면을 더 적은 픽셀로 보는” 비교가 아니다.
인코딩이 바뀌면 곱하는 수가 바뀐다. 같은 1920×1080 30 fps라도 흑백 mono8(1바이트)은 초당 62.208 MB, 투명도 채널이 붙은 rgba8(4바이트)은 248.832 MB다. 1920×1080, 640×480, 3840×2160 등 10개 사례의 식과 기대값은 산술 예제 example.py에 있고, Python 3.12.3으로 실행해 10개 모두 기대값과 같았던 기록은 검산 기록 verification.json에 남겼다. 이 둘은 사칙연산 검산이며 시뮬레이터나 로봇을 실행한 결과가 아니다.
QoS depth는 속도가 아니라 큐에 쌓일 수 있는 양을 정한다
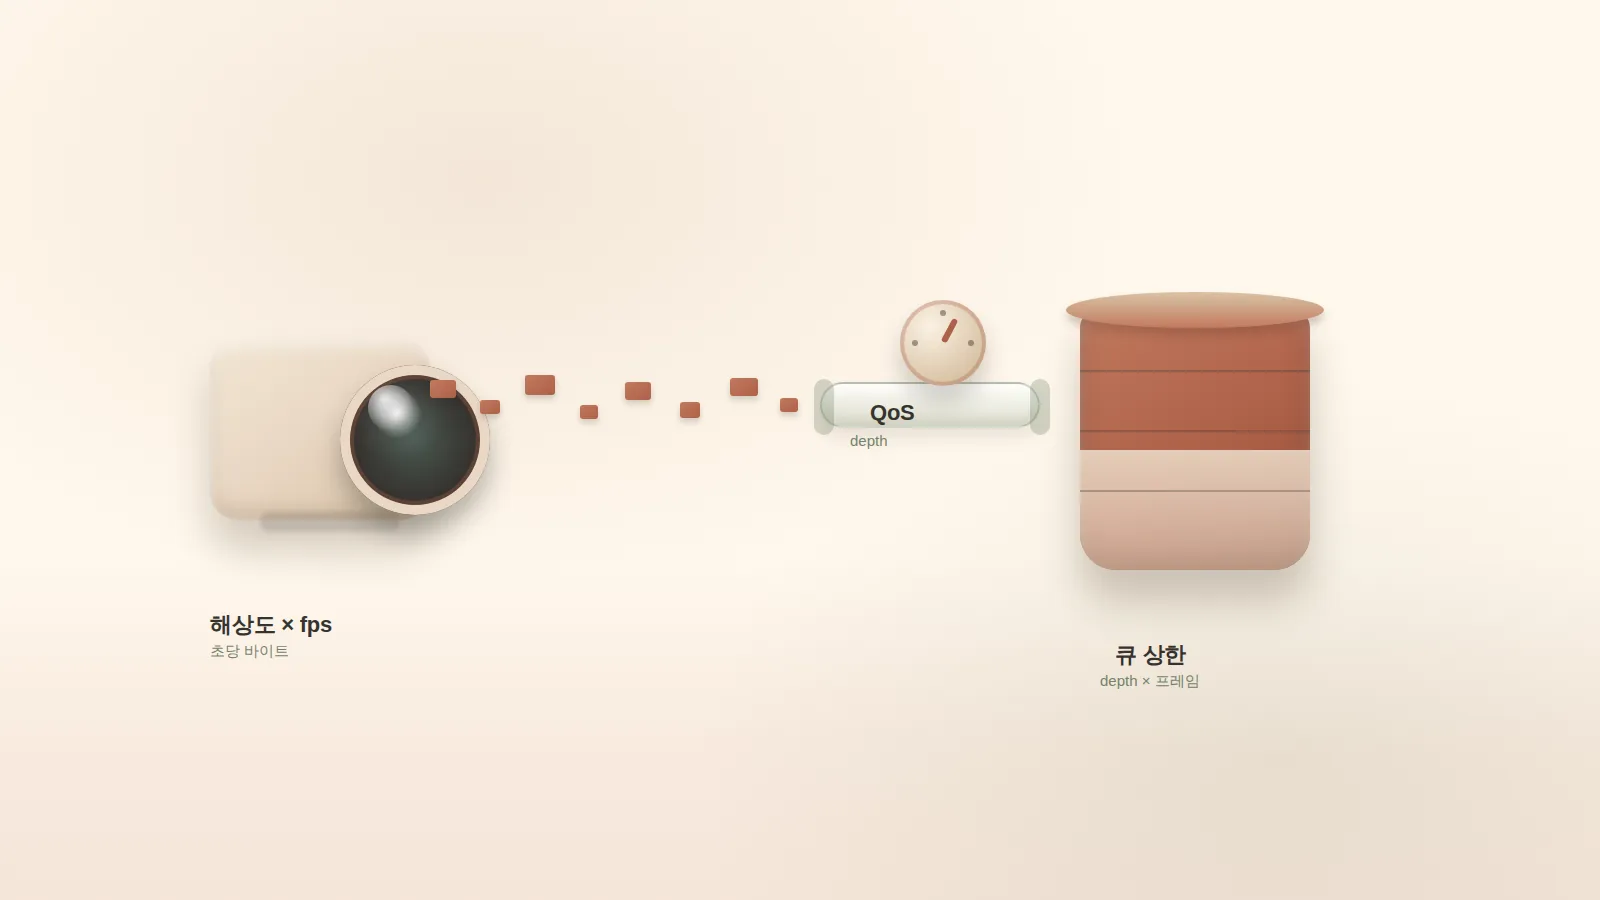
QoS(Quality of Service)는 ROS 2에서 메시지를 어떤 조건으로 주고받을지 정하는 설정 묶음이다. 그중 이력(history) 정책이 keep last이면 큐 깊이(depth) N만큼만 표본을 보관한다. 공식 문서는 이를 “최대 N개 표본만 저장”이라고 정의하고, 기본 발행자·구독자 설정을 keep last·depth 10·reliable로 적는다(QoS 문서, Jazzy 판도 같은 문장이다). 여기서 reliable(신뢰 전송)은 받지 못한 표본을 다시 보내는 방식이고, best effort(최선 노력 전송)는 놓친 표본을 그냥 버리는 방식이다. 센서 데이터용으로 미리 정의된 sensor data 프로필은 ROS 2 미들웨어 인터페이스(RMW) 소스상 best effort·depth 5다(qos_profiles.h).
정의에서 바로 상한이 나온다. 큐 하나가 붙잡을 수 있는 이미지 바이트는 depth × 프레임 바이트를 넘지 않는다.
| 이미지 | depth 1 | depth 5 | depth 10 |
|---|---|---|---|
| 1920×1080 rgb8 | 6.2208 MB | 31.104 MB | 62.208 MB |
| 4512×4512 rgb8 | 약 61.07 MB | 약 305.4 MB | 약 610.7 MB |
질문자 크기를 기본 depth 10으로 받으면 큐 하나의 상한만 약 610.7 MB다. 1 GiB가 1073.74 MB이니, 메모리가 작은 컨테이너나 보드에서는 이 상한 하나가 신경 쓰일 크기다. 발행자와 구독자가 각자 이력을 가지므로 엔티티마다 따로 계산해야 한다.
이 표를 메모리 사용량으로 읽으면 안 된다. RMW 아래 통신 구현 내부의 버퍼와 직렬화 과정의 복사본은 이 식에 들어 있지 않다. 그리고 depth는 렌더링 횟수나 발행 주기를 바꾸지 않는다. depth를 10에서 1로 줄이면 오래된 프레임이 쌓이는 양과 메모리 상한은 줄지만, 그것만으로 시뮬레이션이 빨라진다고 볼 근거는 없다. 연결 전에 QoS가 서로 맞는지와 연결 뒤 큐 문제를 나누는 방법은 QoS 호환성 먼저 계산하기에서 따로 다뤘다.
구독을 시작하는 순간 Gazebo는 렌더링부터 켠다
RTF는 시뮬레이션 시간이 벽시계 시간에 비해 얼마나 빨리 흐르는지의 비다. 1.0이면 실제 시간과 같고, 질문자의 20%는 벽시계 1초 동안 시뮬레이션이 0.2초만 진행됐다는 뜻이다.
질문자가 “구독하면 느려진다”고 적은 대목은 Gazebo 소스에서 그대로 보인다. gz-sensors의 CameraSensor::Update는 이미지 토픽에 연결된 구독자가 없고 이미지 이벤트 연결도 없고 저장도 꺼져 있으면 렌더링하기 전에 반환한다(CameraSensor.cc L485–L497). 그 조건을 지나야 Render()를 부르고 GPU→CPU 복사(CopyTo)를 한다(L508–L527). 시뮬레이터 본체인 gz-sim의 Sensors 시스템도 연결 없는 렌더링 센서를 다음 갱신 대상에서 빼고(Sensors.cc), 렌더링 루프에서 임시로 끈다(L476–L486).
같은 파일의 PostUpdate는 새 렌더링 작업을 넘기기 전에 이전 렌더링이 끝나기를 기다린다(L1005–L1018). 렌더링이 느리면 이 대기가 시뮬레이션 진행을 붙잡는 경로로 읽힌다. 이 부분은 소스를 읽은 해석이고 실행으로 확인하지는 않았다. Gazebo 메인테이너 iche033도 2023년 gz-sensors #332에서 “카메라는 구독자가 없으면 실제로 갱신하지 않는다”, 서버의 렌더링 센서는 한 렌더링 스레드에서 갱신되며 GPU→CPU 읽기, 직렬화(serialization, 메시지를 전송용 바이트열로 펼치는 일), 발행에서 경합이 생길 수 있다고 답했다. 당시는 Gazebo Garden 시기였지만, 위에 링크한 Harmonic 계열 소스의 동작과 일치한다. 같은 이슈에는 질문과 같은 날 같은 SDF·하드웨어·”Gazebo Harmonic 8.9.0″을 적은 댓글도 올라와 있다.
그래서 질문자의 전후 비교는 “렌더링 꺼짐”과 “렌더링 + GPU→CPU 복사 + 직렬화 + 전송 켜짐”의 비교다. 초당 1160 MB라는 메시지량은 그중 마지막 두 단계의 크기만 알려 준다.
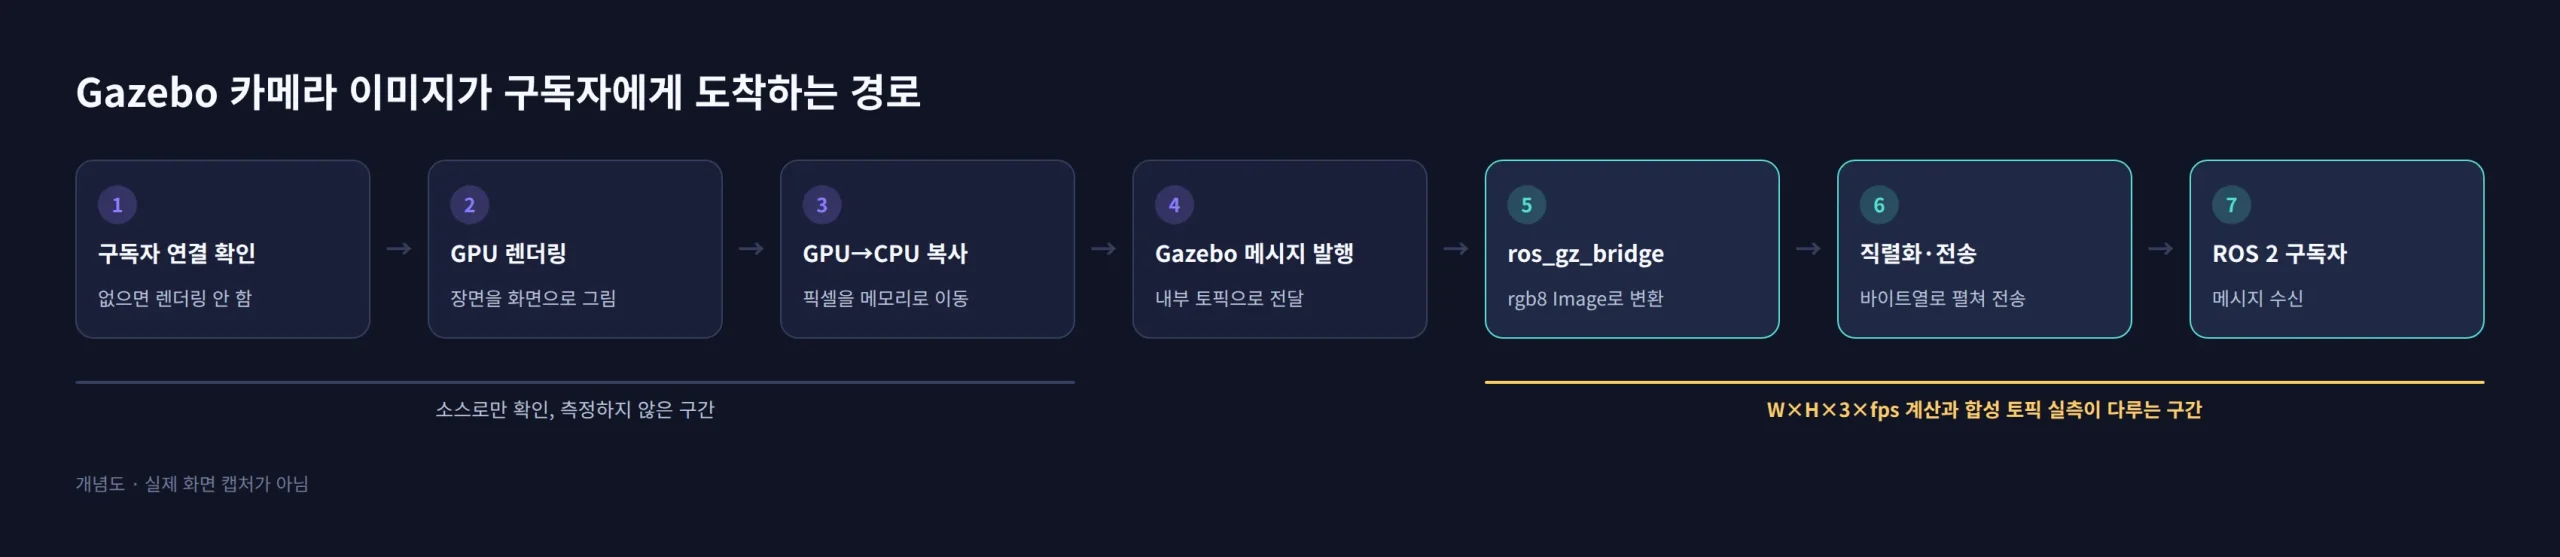
ros_gz_bridge에는 지연(lazy) 옵션이 있다. lazy 브리지는 ROS 쪽 구독자가 있을 때만 Gazebo 토픽을 구독하고, lazy가 아니면 시작하자마자 Gazebo 쪽 구독을 연다(bridge_handle.cpp). README 예시에서 lazy 기본값은 false다(README). 두 소스를 이어 붙이면, 기본 설정 브리지를 띄워 두기만 해도 ROS 구독자와 상관없이 카메라 렌더링이 켜져 있을 수 있다. 브리지의 구독이 Gazebo 쪽 연결 판정에 실제로 잡히는지는 실행해 보지 않았으므로, 자기 환경에서 브리지를 켠 상태와 끈 상태의 RTF를 비교해 확인하는 편이 안전하다.
Gazebo를 빼고 같은 크기의 이미지만 보내 봤다
렌더링을 빼면 메시지 경로만으로는 얼마나 버티는지 보기 위해, Gazebo 없이 같은 해상도의 합성 sensor_msgs/Image(rgb8)를 목표 주기로 발행하고 다른 프로세스의 구독자가 받은 양을 쟀다. 발행은 메인 Python 프로세스, 구독은 조건마다 새로 띄운 별도 Python 프로세스가 맡는다. 구독자는 ros2 topic bw처럼 메시지를 풀지 않은 직렬화 바이트열로 받아 길이와 수신 시각을 기록했다. 시각은 시스템 시각을 바꿔도 뒤로 가지 않는 단조 시계(monotonic clock)로 쟀고, 첫 수신 뒤 2.5초를 창으로 삼았다. 따로 같은 프로세스 안에서 전송 없이 직렬화만 했을 때의 크기와 시간도 쟀다.
환경은 다이제스트(이미지 내용 해시)로 고정한 ros:jazzy-ros-base 이미지(ros@sha256:8eed0a4669bbf43ee331878a4c39bd8ebddea8e3312a58b4fae8edb14526b617), Python 3.12.3, ROS 2 Python 클라이언트 라이브러리 rclpy 7.1.12, 기본 RMW인 rmw_fastrtps_cpp다. 이 RMW는 노드 사이에서 메시지를 실제로 주고받는 통신 미들웨어 DDS(Data Distribution Service)의 구현 중 하나인 Fast DDS를 쓴다. 컨테이너는 네트워크 없음, CPU 1개, 메모리 1 GiB로 묶었고 같은 스크립트를 5회 실행해 5회 모두 종료 코드 0이었다. 실험 계획을 만드는 동안 처음 고른 세 해상도(640×480, 1280×720, 1920×1080)만으로는 모든 조건이 목표 주기에 가깝게 수신돼 “어디서부터 못 받는가”에 답할 수 없었다. 그래서 3840×2160과 질문자 설정 4512×4512·19 Hz를 추가했고, 4512×4512는 메모리 한도 때문에 depth 1로만 돌렸다.
재현 스크립트와 실행별 원본 출력은 실험 저장소 디렉터리에 있다. 파일 단위로는 experiment.py와 5회 원본 출력 results.json이다. Docker가 있으면 빈 디렉터리에서 다음 명령으로 같은 이미지에서 다시 돌릴 수 있다. ROS 설치는 필요 없다.
mkdir gz-camera-bw && cd gz-camera-bw
curl -fsSLO https://raw.githubusercontent.com/sungpyo9053/blog/88bd7f67dfbcaa15d1c2bd61e64919cfa6e59bd1/experiments/gazebo-high-resolution-camera-image-topic-bandwidth-qos-depth/experiment.py
docker run --rm --network none --cpus 1 --memory 1g -v "$PWD":/work ros@sha256:8eed0a4669bbf43ee331878a4c39bd8ebddea8e3312a58b4fae8edb14526b617 bash -c "source /opt/ros/jazzy/setup.bash && python3 /work/experiment.py"
정상이면 JSON이 한 줄씩 나오고 마지막 줄이 "kind": "done"이며, 하네스 실행에서는 회차마다 40초 안팎이 걸렸다. 하네스는 여기에 프로세스 수 제한과 /tmp 임시 파일시스템을 더하고 스크립트 디렉터리를 읽기 전용으로 붙였다. 스크립트는 결과를 표준 출력으로만 내보내므로 위 명령과 측정 대상은 같다. CPU 속도가 다른 머신에서는 큰 해상도의 수치가 달라진다.
먼저 크기는 계산과 맞았다. 5회 모두, 네 해상도 모두에서 직렬화된 메시지는 W×H×3보다 정확히 52바이트 컸다(header, encoding 문자열, 길이 필드 몫). 실험 계획서가 “약간 클 것”이라고 예측한 그대로다. 전송 없이 직렬화 한 번에 걸린 시간(3회 중앙값)은 5회 범위로 640×480이 1.439–1.532 ms, 1920×1080이 12.681–13.105 ms, 4512×4512가 139.686–151.243 ms였다.
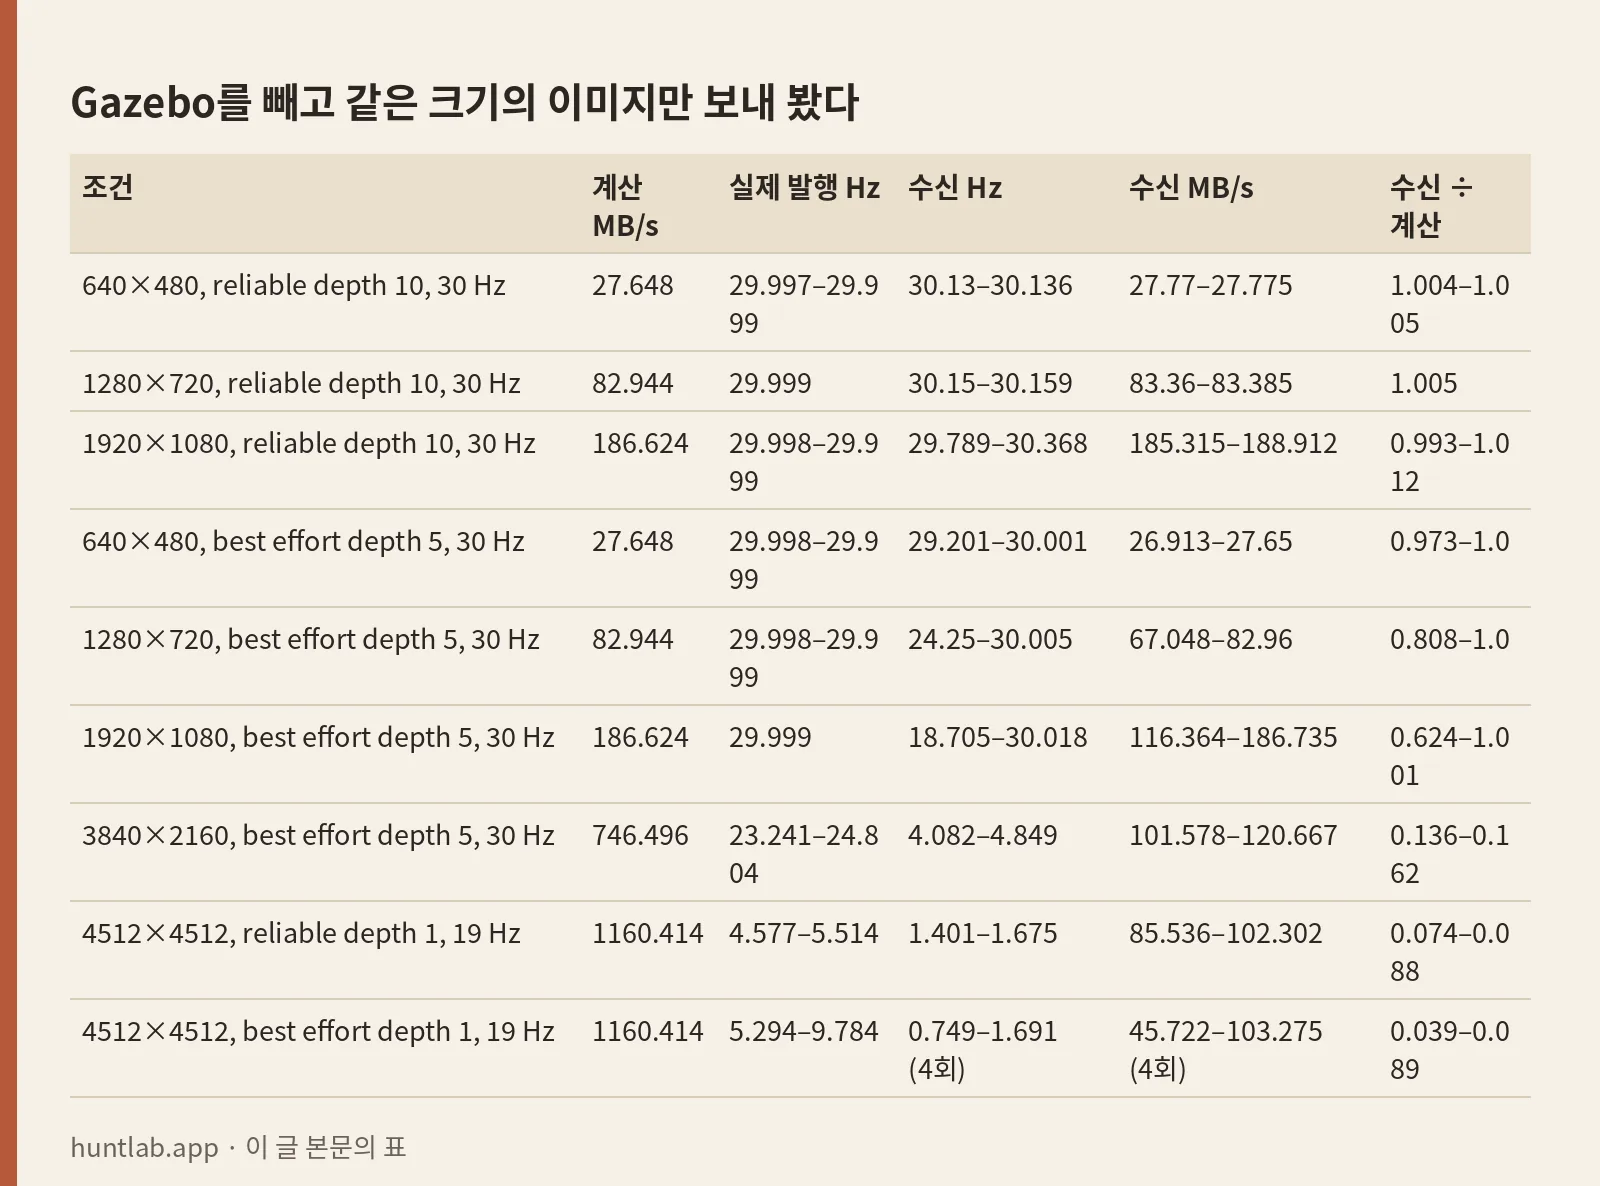
아래 표의 계산값은 목표 주기를 그대로 지켰을 때의 MB/s이고, 나머지 열은 5회 실행의 최솟값–최댓값이다. 수신 MB/s는 구독자가 받은 직렬화 바이트를 벽시계 시간으로 나눈 값이다.
| 조건 | 계산 MB/s | 실제 발행 Hz | 수신 Hz | 수신 MB/s | 수신 ÷ 계산 |
|---|---|---|---|---|---|
| 640×480, reliable depth 10, 30 Hz | 27.648 | 29.997–29.999 | 30.13–30.136 | 27.77–27.775 | 1.004–1.005 |
| 1280×720, reliable depth 10, 30 Hz | 82.944 | 29.999 | 30.15–30.159 | 83.36–83.385 | 1.005 |
| 1920×1080, reliable depth 10, 30 Hz | 186.624 | 29.998–29.999 | 29.789–30.368 | 185.315–188.912 | 0.993–1.012 |
| 640×480, best effort depth 5, 30 Hz | 27.648 | 29.998–29.999 | 29.201–30.001 | 26.913–27.65 | 0.973–1.0 |
| 1280×720, best effort depth 5, 30 Hz | 82.944 | 29.998–29.999 | 24.25–30.005 | 67.048–82.96 | 0.808–1.0 |
| 1920×1080, best effort depth 5, 30 Hz | 186.624 | 29.999 | 18.705–30.018 | 116.364–186.735 | 0.624–1.001 |
| 3840×2160, best effort depth 5, 30 Hz | 746.496 | 23.241–24.804 | 4.082–4.849 | 101.578–120.667 | 0.136–0.162 |
| 4512×4512, reliable depth 1, 19 Hz | 1160.414 | 4.577–5.514 | 1.401–1.675 | 85.536–102.302 | 0.074–0.088 |
| 4512×4512, best effort depth 1, 19 Hz | 1160.414 | 5.294–9.784 | 0.749–1.691 (4회) | 45.722–103.275 (4회) | 0.039–0.089 |
4512×4512 best effort depth 1은 한 회차에서 구독자가 메시지를 하나도 받지 못했고, 나머지 4회는 창 안에서 3–4개를 받았다. 수신 Hz가 30을 조금 넘는 칸은 짧은 창에서 도착 간격으로 계산한 탓이다.
판단을 바꾼 원본 출력은 2회차의 다음 네 줄이다. 첫 줄은 직렬화만 한 기록이고, 나머지는 같은 회차의 1920×1080 best effort와 reliable, 4512×4512 reliable 조건이다.
{"kind": "serialize", "width": 4512, "height": 4512, "frame_bytes": 61074432, "serialized_bytes": 61074484, "overhead_bytes": 52, "serialize_ms_median3": 151.243, "depth10_bound_MB": 610.744, "depth5_bound_MB": 305.372}
{"kind": "condition", "width": 1920, "height": 1080, "qos": "sensor_data", "reliability": "best_effort", "depth": 5, "target_hz": 30.0, "frame_bytes": 6220800, "predicted_MBps_at_target": 186.624, "depth_bound_MB": 31.104, "match_s": 0.151, "matched": true, "published": 105, "pub_hz": 29.999, "pub_call_ms_mean": 4.489, "pub_peak_rss_MB": 89.3, "pub_rss_reset": true, "sub_received": 39, "sub_window_s": 2.5, "sub_peak_rss_MB": 93.7, "sub_span_s": 2.0315, "sub_rx_hz": 18.705, "sub_rx_MBps": 116.364, "sub_msg_bytes_min": 6220852, "sub_msg_bytes_max": 6220852, "rx_over_predicted": 0.624, "rx_hz_over_pub_hz": 0.624, "overhead_bytes": 52}
{"kind": "condition", "width": 1920, "height": 1080, "qos": "default", "reliability": "reliable", "depth": 10, "target_hz": 30.0, "frame_bytes": 6220800, "predicted_MBps_at_target": 186.624, "depth_bound_MB": 62.208, "match_s": 0.151, "matched": true, "published": 105, "pub_hz": 29.999, "pub_call_ms_mean": 4.621, "pub_peak_rss_MB": 89.5, "pub_rss_reset": true, "sub_received": 77, "sub_window_s": 2.5, "sub_peak_rss_MB": 93.7, "sub_span_s": 2.5153, "sub_rx_hz": 30.215, "sub_rx_MBps": 187.962, "sub_msg_bytes_min": 6220852, "sub_msg_bytes_max": 6220852, "rx_over_predicted": 1.007, "rx_hz_over_pub_hz": 1.007, "overhead_bytes": 52}
{"kind": "condition", "width": 4512, "height": 4512, "qos": "reliable_depth1", "reliability": "reliable", "depth": 1, "target_hz": 19.0, "frame_bytes": 61074432, "predicted_MBps_at_target": 1160.414, "depth_bound_MB": 61.074, "match_s": 0.151, "matched": true, "published": 19, "pub_hz": 5.158, "pub_call_ms_mean": 193.814, "pub_peak_rss_MB": 328.2, "pub_rss_reset": true, "sub_received": 5, "sub_window_s": 2.5, "sub_peak_rss_MB": 307.9, "sub_span_s": 2.525, "sub_rx_hz": 1.584, "sub_rx_MBps": 96.752, "sub_msg_bytes_min": 61074484, "sub_msg_bytes_max": 61074484, "rx_over_predicted": 0.083, "rx_hz_over_pub_hz": 0.307, "overhead_bytes": 52}
reliable 구독자부터 보면, 1920×1080 30 Hz까지 5회 모두 계산값의 0.993–1.012배를 받았다. 이 범위에서는 W×H×3×fps가 실제로 오간 양을 그대로 맞혔다.
같은 해상도의 best effort 구독자는 실행마다 흔들렸다. 2회차의 1920×1080은 발행자가 29.999 Hz로 105개를 보내는 동안 구독자가 18.705 Hz만 받았다. 계획서는 이 해상도들이 모두 계산 근처로 수신될 것으로 예측했고, reliable은 예측대로였지만 best effort에는 예측보다 낮은 회차가 섞였다.
3840×2160부터는 발행 쪽이 먼저 밀렸다. publish() 한 번의 평균 시간이 32.386–36.695 ms로 30 Hz의 한 주기와 비슷해졌고, 실제 발행은 23.241–24.804 Hz에 그쳤다. 4512×4512에서는 publish() 평균이 102.071–220.443 ms로 19 Hz의 프레임 간격(약 53 ms)보다 모든 회차에서 길었고, 실제 발행은 4.577–9.784 Hz였다.
여기서부터는 해석이다. best effort가 놓친 원인은 이 실험에서 따로 나누지 않았다. CPU 하나를 발행자, 구독자, DDS 스레드가 나눠 쓰는 동안 구독자가 제때 읽지 못한 표본을 best effort는 다시 보내지 않고 버리는 정의와는 맞아떨어지지만, 측정으로 확인한 인과는 아니다. 4512×4512의 최대 상주 메모리(VmHWM, 프로세스가 실행 중 가장 많이 차지한 실제 메모리)는 reliable depth 1에서 발행 프로세스 328.1–358.5 MB, 구독 프로세스 307.7–308.4 MB로 프레임 한 장(61.074 MB)의 몇 배였다. rclpy와 DDS를 포함한 프로세스 전체 값이라 depth 상한과 1:1로 비교할 수는 없고, 어디서 몇 장이 복사됐는지도 이 실험은 나누지 않았다.
이 실측이 질문의 범위를 어디까지 좁히는지도 분명히 해 둔다. 이 대조군은 Python 발행자와 Python 구독자가 CPU 하나를 나눠 쓴 결과다. Gazebo의 ros_gz_bridge는 C++이고 질문자가 적은 하드웨어(RTX 3070 GPU를 쓰는 머신)도 이 컨테이너와 다르므로, “4512×4512는 메시지 경로만으로도 19 Hz가 불가능하다”고 일반화할 수는 없다. 말할 수 있는 것은, 프레임 하나가 수십 MB를 넘으면 렌더링이 없어도 직렬화와 발행 자체가 주기 안에 끝나는지 따로 재 봐야 한다는 점이다. 이 1 CPU 환경에서는 발행 한 번의 비용이 1920×1080까지 주기 안에 들어왔고, 3840×2160에서 주기를 넘어섰다.
ros2 topic bw가 계산보다 작게 나올 때 먼저 볼 것
자기 Gazebo 토픽에 ros2 topic bw나 ros2 topic hz를 붙여 계산과 비교할 때는 이 도구가 무엇을 재는지부터 알아야 한다. ros2cli 소스를 보면 bw는 sensor data QoS(best effort, depth 5)로 구독해 직렬화된 메시지 길이를 최근 100개 동안 더하고, 그 합을 노드 시계로 잰 경과 시간으로 나눈다. MB 표시는 1000 기반이다(bw.py, L168–L175). hz도 같은 QoS로 구독한다(hz.py). 노드 시계는 use_sim_time을 켜지 않으면 벽시계다.
# 토픽 이름은 자기 브리지 설정에 맞게 바꾼다
ros2 topic bw /camera/image_raw
ros2 topic hz /camera/image_raw
그러면 bw 값이 계산보다 작게 나오는 원인은 적어도 세 갈래다.
- RTF가 1보다 작다. 계산값은 시뮬레이션 1초 기준이고
bw는 벽시계 1초 기준이다. 카메라가 시뮬레이션 시간으로 19 Hz를 지키더라도 RTF가 0.2라면 벽시계로는 3.8 Hz, 약 232.1 MB/s로 보일 수 있다. 질문자가 공개한 측정값은 없고, 이 숫자는 식으로 만든 예시다. 메인테이너도 #332에서ros2 topic hz가 벽시계 기준이라 RTF가 낮으면 목표보다 낮게 보인다고 설명했다. - 측정하는 구독자가 놓쳤다.
bw와hz는 best effort로 받는다. 위 실측에서 best effort 구독자는 발행자가 30 Hz로 보내는 동안에도 18.705 Hz만 받은 회차가 있었다.bw가 낮다고 해서 발행자가 덜 보냈다고 단정하지 않는다. - 측정 도구 자체가 부하다. 큰 이미지에서는
bw·hz구독자가 메시지를 받는 일 자체가 CPU를 쓴다. Gazebo에서는 이 구독이 렌더링을 켜는 계기이기도 하다.
반대로 평균 메시지 크기는 계산보다 아주 조금만 커야 한다. 위 실측에서 그 차이는 52바이트였다. bw가 보여 주는 평균 크기가 프레임 계산값과 크게 다르면 인코딩이나 해상도가 생각과 다르게 설정된 것이다.
실물 카메라로 옮기면 비닝과 CameraInfo가 곱셈에 끼어든다
Gazebo 안에서 해상도를 낮추는 손잡이는 SDF의 width와 height 하나다. SDFormat 카메라 명세와 gz-sensors에는 비닝 설정이 없고, gz-sensors는 카메라 보정 정보를 담는 sensor_msgs/CameraInfo의 크기를 SDF 이미지 크기로 채운다. 내부 파라미터(intrinsics)를 따로 주지 않으면 렌더링 투영 행렬에서 초점거리와 중심점을 계산한다(CameraSensor.cc). ros_gz_bridge의 CameraInfo 변환도 비닝과 ROI를 채우지 않는다(sensor_msgs.cpp). 시뮬레이션에서는 SDF 해상도를 바꾸면 CameraInfo가 함께 따라온다.
실제 카메라 드라이버로 옮기면 비닝(binning)이 식에 하나 더 들어온다. 비닝은 이웃 픽셀 여러 개를 하나로 묶어 출력 해상도를 줄이는 카메라 설정이다. CameraInfo 정의에서 width와 height는 “카메라를 보정할 때의 이미지 크기”이고, 내부 파라미터 행렬 K(초점거리 fx·fy와 중심점 cx·cy를 담은 3×3 행렬)를 포함한 보정값은 다시 보정하기 전까지 그대로다. 보정하지 않았으면 0으로 채워져 K[0] == 0으로 미보정을 알아볼 수 있다. 반면 binning_x·binning_y와 관심 영역(region of interest, ROI, 센서의 일부 창만 읽는 설정)은 재보정 없이 바꾸는 운영 값이다. 비닝을 쓰면 출력은 (width / binning_x) × (height / binning_y)가 되고, 0은 1과 같은 뜻이다(L108–L131). 2×2 비닝이면 1920×1080 rgb8 한 프레임이 1,555,200 바이트, 1/4로 준다.
그래서 ROI가 기본값(모두 0, 전체 해상도)일 때, 받은 Image의 width는 CameraInfo.width / max(binning_x, 1)과 같아야 하고 height도 같은 식이어야 한다. ROI는 전체 해상도 좌표로 센서 창을 가리키므로, ROI를 설정했다면 이 단순식을 그대로 쓰면 안 된다. ROI와 비닝을 함께 쓸 때 드라이버가 CameraInfo를 어떻게 채우는지는 드라이버마다 다르고, 여기서는 확인하지 않았다. 크기가 맞지 않으면 K를 그 이미지에 그대로 쓰지 않는다. K로 픽셀을 미터 단위 좌표로 바꾸는 과정은 RGB-D 카메라 픽셀과 깊이를 XYZ로 바꾸기에서 다뤘다.
본문에 없는 설정으로 풀어 보는 세 문제
답은 모두 위 식으로 다시 계산할 수 있다. 문제의 설정과 측정값은 설명용으로 정한 가정이며 실제 측정이 아니다.
1. 로봇에 1280×720 mono8(흑백, 픽셀당 1바이트) 카메라 두 대를 30 fps로 달았다. 두 토픽을 합치면 초당 몇 MB이고, sensor data 프로필(depth 5)로 받는 구독자의 큐 하나는 최대 몇 MB를 붙잡을 수 있는가?
한 대의 프레임은 1280 × 720 × 1 = 921,600 바이트이고 30 fps에서 초당 27.648 MB, 두 대를 합치면 55.296 MB다. 큐 하나의 상한은 5 × 921,600 = 4,608,000 바이트, 약 4.608 MB이며 토픽마다 따로 생긴다. 픽셀 수는 640×480의 세 배지만 채널이 하나라서 한 프레임의 바이트 수는 640×480 rgb8과 같다. 해상도만 보고 부담을 비교하면 인코딩이 만드는 세 배 차이를 놓친다.
2. 1280×720 rgb8 카메라의 update_rate가 30이고 시뮬레이션은 RTF 약 0.5로 돌고 있다. use_sim_time 없이 띄운 ros2 topic bw가 약 41 MB/s, ros2 topic hz가 약 15 Hz를 보인다면 메시지가 빠지고 있다고 봐야 하는가?
이 숫자만으로는 그렇게 볼 근거가 없다. 시뮬레이션 1초 기준 계산값은 1280 × 720 × 3 × 30 = 82,944,000 바이트, 82.944 MB/s다. 벽시계 1초 동안 시뮬레이션은 0.5초만 지나므로 벽시계 기준 기대값은 41.472 MB/s, 15 Hz이고 가정한 두 값이 이 기대값과 맞는다. 카메라는 시뮬레이션 시간으로 30 Hz를 내고 있다고 볼 수 있고, 풀어야 할 문제는 RTF가 왜 0.5인가다. hz가 15보다 눈에 띄게 낮게 나왔다면 그때 측정 구독자의 누락이나 발행 지연을 의심한다.
3. 실제 카메라에서 CameraInfo의 width가 1920, binning_x가 2, ROI는 기본값인데 받은 이미지의 가로가 1920이다. 무엇이 의심스러운가?
정의대로라면 받은 이미지 가로는 1920 / 2 = 960이어야 한다. 1920이 왔다면 드라이버가 비닝을 적용하지 않았거나, CameraInfo가 다른 설정의 값을 싣고 있다. 어느 쪽이든 그 K로 픽셀을 3D 좌표로 바꾸면 안 되고, 드라이버 설정과 보정 파일을 먼저 맞춘다.
어디부터 줄일지 정하는 순서
계산과 소스, 합성 토픽 실측을 합치면 질문자 같은 상황에서 확인할 순서는 다음과 같다.
- 아무도 구독하지 않을 때의 RTF와,
gz topic -e로 카메라 토픽 하나만 구독했을 때의 RTF를 비교한다. ROS 브리지가 lazy가 아니라면 브리지를 끈 상태가 “구독 없음”이다. - ROS 없이 Gazebo 쪽 구독만으로도 RTF가 크게 떨어지면 원인은 렌더링과 GPU→CPU 복사 쪽에 먼저 있다. SDF의 해상도,
update_rate, 그리고 사선 경계의 계단 현상을 줄이려고 픽셀마다 여러 번 샘플링하는anti_aliasing(기본 4, camera.sdf)을 줄이는 쪽이 첫 후보다. - 같은 크기의 합성 이미지를 Gazebo 없이 보내 보고 받은 MB/s와 Hz가 계산과 맞는지 본다. 위 스크립트의 해상도를 자기 값으로 바꿔 쓰면 된다. 합성 토픽만으로도 목표 Hz를 못 받으면 직렬화·전송·구독자 처리도 한계에 닿은 것이다.
- 그다음에 depth, reliable과 best effort, 압축, lazy 브리지를 조정한다. 압축은 이미지 토픽을 JPEG 같은 압축 형식으로도 내보내게 해 주는 ROS 패키지 image_transport로 붙인다. depth를 바꿔 줄어드는 것은 QoS 절에서 계산한 큐 상한까지다.
이 글이 확인하지 못한 범위도 남는다. Gazebo를 실행하지 않았으므로 렌더링과 GPU 복사에 실제로 몇 ms가 드는지, lazy 브리지가 정말 렌더링을 멈추는지, 해상도별 RTF가 어떻게 변하는지는 측정값이 없다. 합성 토픽 실측은 한 컨테이너 안의 프로세스 사이 전송이라 실제 네트워크나 C++ 구독자를 대표하지 않는다. 실물 카메라는 USB나 이더넷 링크 속도, 드라이버의 압축 여부에 따라 같은 해상도라도 다른 숫자가 나오며, 이 글은 실물 카메라를 다루지 않았다.
시뮬레이션이 느려지는 원인이 카메라가 아니라 알고리즘 처리 시간일 수도 있다면, 처리 시간으로 RTF의 상한을 계산하는 ROS 2 시뮬레이션이 느릴 때 RTF와 처리 시간 예산이 다음 확인 지점이다.
자주 묻는 질문
Gazebo 4512×4512 카메라 토픽은 초당 몇 MB를 내보내야 하나?
rgb8은 픽셀당 3바이트라 한 프레임이 4512 × 4512 × 3 = 61,074,432 바이트, 약 61.07 MB다. update_rate 19를 곱하면 시뮬레이션 1초에 약 1160.4 MB다.
카메라 토픽을 구독하자마자 RTF가 떨어지는 이유는 무엇인가?
Gazebo 소스에서 카메라는 구독자가 없으면 렌더링하기 전에 반환하고, 구독자가 생겨야 렌더링과 GPU→CPU 복사를 한다. 그래서 구독 전후의 차이에는 메시지 전송뿐 아니라 렌더링, GPU→CPU 복사, 직렬화가 함께 들어 있다.
QoS depth를 줄이면 시뮬레이션이 빨라지나?
depth는 렌더링 횟수나 발행 주기를 바꾸지 않는다. 오래된 프레임이 쌓이는 양과 큐 하나의 메모리 상한(depth × 프레임 바이트)은 줄지만, 그것만으로 시뮬레이션이 빨라진다고 볼 근거는 없다.
ros2 topic bw 값이 계산보다 작으면 메시지가 빠지고 있는 것인가?
꼭 그렇지는 않다. 계산값은 시뮬레이션 1초 기준이고 bw는 벽시계 1초 기준이라 RTF가 1보다 작으면 낮게 보이고, bw는 best effort로 받으므로 측정하는 구독자가 놓친 것일 수도 있다. 큰 이미지에서는 측정 도구 자체도 CPU를 쓰는 부하다.
Gazebo 없이 같은 크기 이미지만 보내면 계산대로 받았나?
1 CPU 컨테이너에서 reliable 구독자는 640×480부터 1920×1080까지 30 Hz에서 5회 모두 계산값의 0.993–1.012배를 받았다. best effort 구독자는 같은 해상도에서도 회차에 따라 0.624배까지 떨어졌고, 3840×2160과 4512×4512는 발행 단계부터 목표 주기를 지키지 못했다.
참고 링크
- sensor_msgs/Image.msg (Jazzy), CameraInfo.msg (Jazzy) — 이미지 크기와 보정·비닝 정의
- ROS 2 About Quality of Service Settings, rmw qos_profiles.h — keep last와 기본·sensor data 프로필
- gz-sensors CameraSensor.cc, gz-sim Sensors.cc, gz-sensors #332 — 구독 연결과 렌더링
- ros2cli bw.py —
ros2 topic bw의 측정 방식 - 산술 예제 example.py, 검산 기록 verification.json, 합성 토픽 실험 results.json
소스 링크는 모두 2026년 10월 29일에 확인한 커밋으로 고정했다. 이 글에는 제휴·협찬이 없다.