ROS 2에서 PointCloud2 메시지를 다른 프레임으로 변환하려면: Python으로 xyz만 꺼내 회전·이동한 뒤 create_cloud로 다시 만들 때 intensity와 frame_id가 남는지 바이트 수로 확인하기
라이다나 깊이 카메라 드라이버가 laser 프레임으로 내보낸 점들을 base_link 기준으로 바꿔 다시 발행하려고 한다. rclpy 콜백에서 read_points_numpy로 xyz를 꺼내 회전과 이동을 적용하고 sensor_msgs_py.point_cloud2.create_cloud로 메시지를 다시 만들면 될 것처럼 보인다. 그렇게 PointCloud2 메시지를 다른 프레임으로 변환하면 intensity 같은 나머지 필드와 header.frame_id는 어떻게 될까. ROS 2 Jazzy 컨테이너에서 돌려 보면 x·y·z 필드 정의만 넘긴 경우 intensity는 오류 한 줄 없이 빠지고, 점 하나가 16바이트에서 12바이트로 줄며, 원본 msg.header를 그대로 넘긴 탓에 frame_id는 laser로 남는다. 좌표 숫자는 정확한데 메시지는 틀린 상태다.
원본 fields와 point_step, 그리고 target 프레임을 적은 새 Header를 함께 넘기면 둘 다 남는다. 공식 함수 tf2_sensor_msgs.do_transform_cloud도 같은 결과를 내지만, Jazzy의 sensor_msgs_py 5.3.8에서는 점 끝에 빈 바이트가 붙은 클라우드를 만나면 AssertionError로 멈춘다. 아래에서는 점 하나를 손으로 옮겨 보고, create_cloud가 바이트를 어떻게 다시 세는지 따라간 뒤, 발행 전에 넣을 검사를 실측 결과와 함께 정리한다. rclpy 구독 콜백, NumPy 배열, 2차원 회전 공식 정도를 안다고 가정한다. 근거는 2026년 11월 2일에 확인한 Jazzy 소스와 합성 메시지로 5회 반복한 컨테이너 실험이며, 실물 센서나 로봇에서 얻은 결과는 아니다.
좌표 숫자는 회전을 먼저 적용해야 맞는다
같은 점이라도 어느 기준점과 축 방향으로 재느냐에 따라 숫자가 달라진다. 그 기준을 좌표계(frame)라 하고, tf2는 ROS 2에서 좌표계 사이의 관계를 시간과 함께 관리하는 라이브러리다. 원래 데이터가 표현된 프레임을 source, 옮겨 갈 프레임을 target이라 부른다(ROS 2 Jazzy Tf2 문서). lookup_transform('base_link', 'laser', t)를 부르면 TransformStamped(시각과 기준 프레임 이름이 붙은 변환 메시지)가 돌아온다. 그 머리말의 기준 프레임 이름 header.frame_id에는 target인 base_link가, 옮겨 올 쪽 프레임 이름 child_frame_id에는 source인 laser가 적힌다(buffer_core.cpp L739-L740). 그 안의 회전 R과 이동 t를 점에 p_base = R·p_laser + t로 적용하면 laser 기준 숫자가 base_link 기준 숫자로 바뀐다. 부모·자식 방향을 거꾸로 잡아 생기는 실수는 TF 변환 방향을 다룬 글에서 따로 설명했다.
설명용 가정을 하나 세운다. 실제 센서 값이 아니다. laser 프레임은 base_link에 대해 z축 기준 반시계 방향으로 90° 돌아 있고, 원점은 base_link의 (0.25, 0, 0.125) m에 있다. 90°를 고른 이유는 삼각함수 없이 (x, y) → (−y, x)로 따라갈 수 있기 때문이고, 0.25와 0.125는 이진수로 정확히 표현돼 반올림이 끼지 않는다.
laser 앞쪽의 점 (1.0, 0.5, 0) m를 옮겨 보자.
- 회전:
(x, y) → (−y, x)이므로(−0.5, 1.0, 0) - 이동: t를 더해
(−0.5 + 0.25, 1.0 + 0, 0 + 0.125) = (−0.25, 1.0, 0.125)m
회전을 빠뜨리고 이동만 더하면 (1.25, 0.5)가 나온다. 정답과의 xy 제곱 오차는 1.5² + 0.5² = 2.5 m²이고, 제곱근을 씌우면 거리로 약 1.58 m다. 원점에서 1 m 남짓 떨어진 점이 1.5 m 넘게 어긋나니, 이동만 맞췄다고 변환이 끝난 것이 아니다.
변환한 좌표 (−0.25, 1.0, 0.125)의 세 값과 제곱 오차 2.5 m²는 example.py로 다시 계산했고 결과는 verification.json에 남아 있다. Python 3.12.3에서 돌린 산술 검산이며 ROS나 로봇을 실행한 기록은 아니다.
TransformStamped에서 이 회전은 쿼터니언(quaternion, 3차원 회전을 x·y·z·w 네 숫자로 적는 방식)으로 들어 있고, z축 +90°는 z = w = √0.5다. 공식 tf2_sensor_msgs의 내부 함수 transform_points도 쿼터니언을 회전행렬로 바꾼 뒤 einsum('ij, pj -> pi', R, points) + translation을 계산한다(tf2_sensor_msgs.py L59-L89). 손계산과 같은 순서다. 90° 한 각도만 다룬 예제이므로 임의 각도 코드의 일반 검산으로 쓰지는 않는다.
다시 만든 메시지의 모양은 넘긴 fields가 정한다
좌표를 맞게 바꿨다면 남은 일은 메시지를 다시 싸는 것이고, 여기서 intensity가 빠진다. 이유를 보려면 PointCloud2가 점을 담는 방식부터 짚어야 한다. 받은 메시지에서 offset으로 값을 꺼내는 쪽의 계산은 read_points_numpy로 PointCloud2를 xyz 배열로 바꾸는 글에서 다뤘으므로, 여기서는 다시 만들 때 필요한 만큼만 정리한다.
포인트 클라우드(point cloud)는 센서가 잰 3차원 점의 모음이다. ROS의 PointCloud2 메시지는 이 점들을 data라는 바이트 배열 하나에 차례로 이어 붙이고, 점 하나 안에서 어느 바이트가 무엇인지는 fields라는 목록에 따로 적는다. 목록의 각 항목이 PointField(필드)이며 name, offset(점의 시작에서 몇 바이트 뒤에 있는지), datatype(FLOAT32는 7), count를 가진다(PointField.msg). 점 하나가 차지하는 바이트 수가 point_step, 한 행이 차지하는 바이트 수가 row_step이고, data의 크기는 row_step × height다(PointCloud2.msg).
예를 들어 x·y·z와 intensity(반사 강도, 라이다가 돌아온 빛의 세기로 기록하는 값)가 모두 4바이트 float32이고 offset이 0·4·8·12라면 point_step은 16이다. 점이 1000개면 data는 16000바이트가 된다. intensity는 좌표가 아니므로 프레임을 바꿔도 회전하거나 이동하지 않고 값 그대로 따라가야 한다.
열 이름과 시작 위치만 적힌 표 머리(fields) 아래에 칸 구분선 없이 값을 이어 쓴 표(data)를 떠올리면 가깝다. 다만 실제 메시지에는 표 머리에 적히지 않은 빈 바이트, 즉 정렬을 맞추려고 넣은 패딩(padding)이 있을 수 있다. 가장 뒤 필드의 끝(offset + 바이트 크기)보다 point_step이 크면 점 끝에 패딩이 있다는 뜻이다. 이 빈칸이 뒤에서 공식 함수를 멈추게 하는 원인이다. 깊이 카메라처럼 이미지 격자 모양(height > 1)을 유지하는 클라우드는 organized 클라우드(정렬된 클라우드)라 부르고, 순서 없는 클라우드는 height = 1이다.
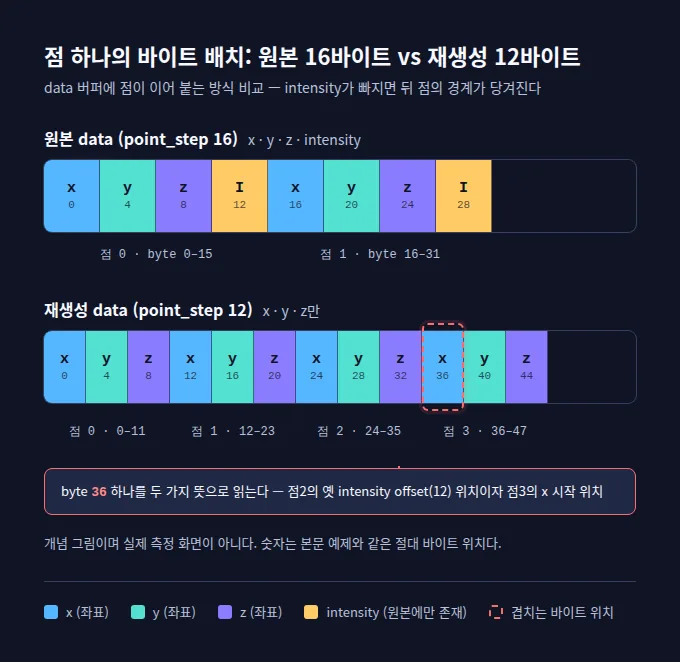
이제 create_cloud가 이 구조를 어떻게 다시 채우는지 보자. Jazzy 릴리스와 같은 커밋의 point_cloud2.py에서 create_cloud(header, fields, points, point_step=None)은 메시지를 이렇게 조립한다(L283-L304).
fields는 받은 목록 그대로 넣는다.point_step은 NumPy 배열 한 원소의 바이트 수(points.dtype.itemsize),row_step은 그 값에width를 곱한 값으로 새로 쓴다.- 1차원 배열이면
height = 1,width = 점 개수이고,is_dense는 입력과 상관없이 False로 고정된다. header는 받은 객체를 그대로 쓴다.
여기서 NumPy 배열은 구조화 배열(structured array, 필드 이름·오프셋·자료형을 가진 배열)로 바뀐 상태이고 그 dtype은 넘긴 fields로 만든다. x·y·z 세 필드만 넘기면 마지막 필드가 끝나는 8 + 4 = 12바이트가 점 하나의 크기가 된다. 함수가 intensity를 지우는 것이 아니라, 처음부터 intensity가 없는 설명서로 메시지를 짓는 셈이다.
같은 1000개 점으로 바이트를 세어 보면 차이가 분명하다(example.py 사례 5~9).
- 원본:
1000 × 1 × 16 = 16000바이트 - x·y·z만 넘겨 다시 만든 메시지:
1000 × 1 × 12 = 12000바이트, 줄어든 비율(16000 − 12000) / 16000 = 0.25. 줄어든 4바이트 × 1000이 intensity 몫이다. - 새 메시지에서 옛 intensity offset 12를 믿고 점 2를 읽으면 바이트 위치는
2 × 12 + 12 = 36이다. 점 3의 x가 시작하는 위치도3 × 12 = 36이다.
두 값이 같다는 것은 옛 offset으로 intensity를 읽는 하류 코드가 오류 없이 다음 점의 x를 읽는다는 뜻이다. 값이 엉뚱해질 뿐 예외는 나지 않는다.
frame_id 꼬리표는 호출한 쪽이 바꿔야 한다
header.frame_id는 “이 숫자들이 어느 좌표계 기준인가”를 적은 문자열이고, RViz나 다른 노드는 이 꼬리표를 보고 어떤 변환을 적용할지 고른다. create_cloud는 header를 받은 그대로 쓰므로, 원본 msg.header를 넘기면 결과 frame_id는 laser로 남는다.
tf2 문서는 가능하면 transform<T>(target_frame, ...) 계열 메서드를 쓰라고 권하는데, 이 메서드들이 데이터에서 source frame_id를 읽고 결과에 target frame_id를 써 주기 때문이다(Jazzy Tf2 문서). 직접 계산하면 그 일을 호출한 쪽이 해야 한다. 숫자는 base_link 기준인데 꼬리표가 laser인 메시지를 RViz가 받으면 laser에서 고정 프레임으로 가는 변환을 한 번 더 적용해, 이미 옮긴 점을 다시 옮겨 그릴 가능성이 있다. 이 부분은 소스에서 끌어낸 해석이며 이번 실험에서 화면으로 확인하지는 않았다.
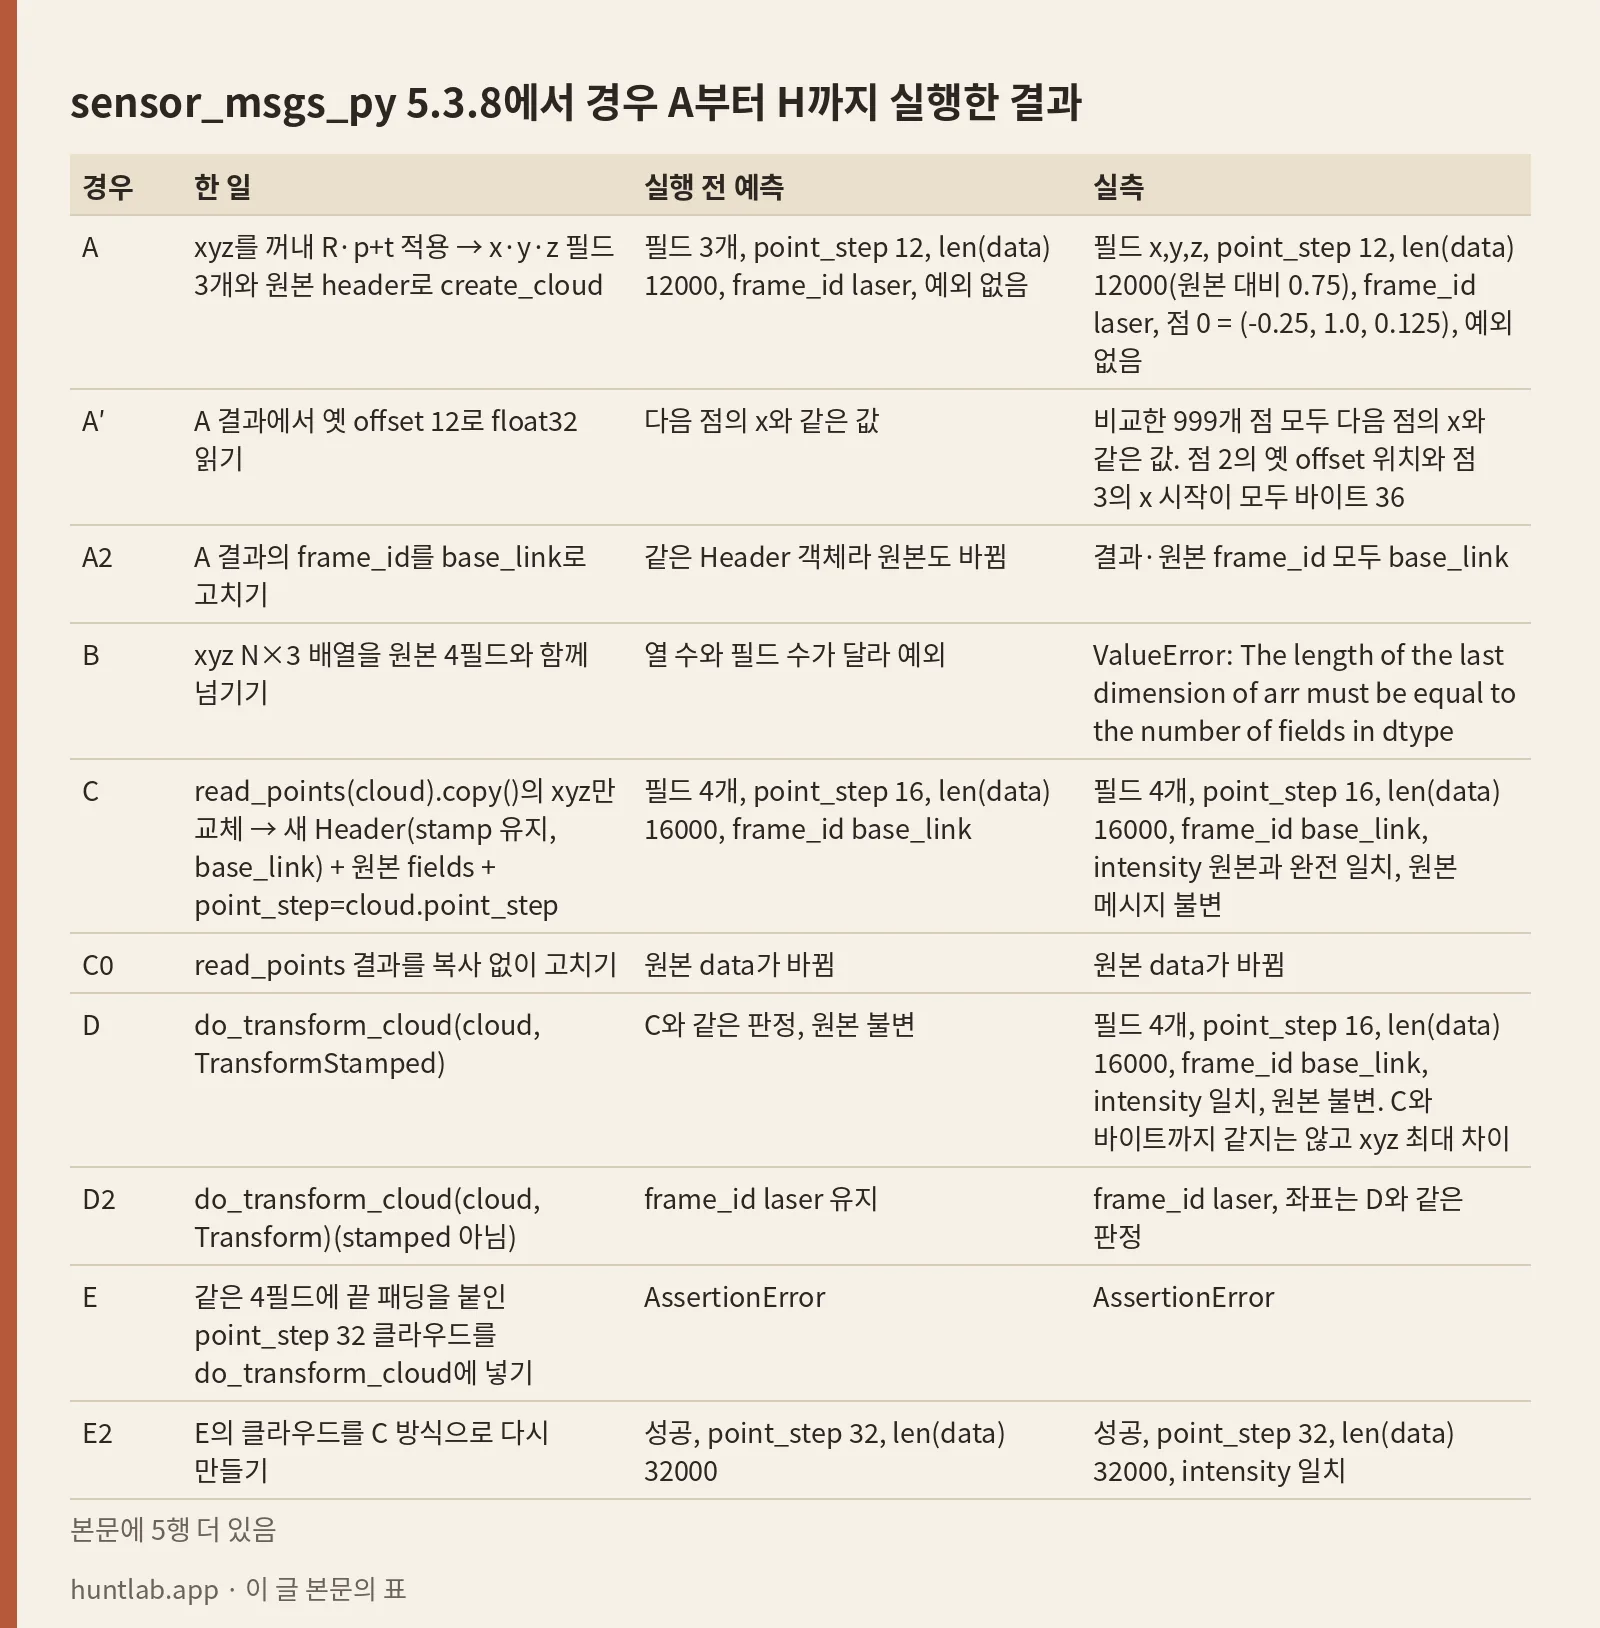
sensor_msgs_py 5.3.8에서 경우 A부터 H까지 실행한 결과
12바이트, 바이트 위치 36, laser 꼬리표는 모두 소스 코드와 산술로 얻은 값이다. Jazzy 이미지에 든 실제 라이브러리도 그렇게 동작하는지 보려고, 같은 합성 클라우드를 여러 방식으로 변환하고 결과 메시지를 실행 중에 쟀다. 입력 클라우드는 검사 대상인 create_cloud를 쓰지 않고 NumPy 구조화 배열을 직접 바이트로 포장해 만들었고, intensity는 점마다 다른 값을 넣었다. 시험 실행에서 실패는 없었으며, 허용오차 통과 여부를 따로 출력하는 within_tol 필드를 하나 추가한 뒤 본 실행을 했다.
측정 환경은 고정 이미지 ros@sha256:8eed0a4669bbf43ee331878a4c39bd8ebddea8e3312a58b4fae8edb14526b617(ros:jazzy-ros-base), 네트워크 없음, 1 CPU, 1 GiB 메모리다. 실행 중에 읽은 버전은 Python 3.12.3, NumPy 1.26.4, sensor_msgs_py 5.3.8, tf2_sensor_msgs 0.36.23, tf2_ros_py 0.36.23, rclpy 7.1.12-1noble.20260912.162354이고, RMW(ROS 2가 메시지를 실제로 주고받는 미들웨어 계층)는 기본값 rmw_fastrtps_cpp였다. 하네스가 같은 스크립트를 5회 실행했고 5회 모두 종료 코드 0이었으며, 소요 시간을 뺀 모든 측정값이 5회 동일했다.
공통 입력은 점 1000개, 필드 x·y·z·intensity(float32, offset 0·4·8·12), point_step 16, len(data) 16000, frame_id laser, stamp [1700000000, 123456789], is_dense=True다. 변환은 parent base_link, child laser, 이동 [0.25, 0.0, 0.125], 회전 z·w [0.7071067811865476, 0.7071067811865476]이다.
| 경우 | 한 일 | 실행 전 예측 | 실측 |
|---|---|---|---|
| A | xyz를 꺼내 R·p+t 적용 → x·y·z 필드 3개와 원본 header로 create_cloud |
필드 3개, point_step 12, len(data) 12000, frame_id laser, 예외 없음 |
필드 x,y,z, point_step 12, len(data) 12000(원본 대비 0.75), frame_id laser, 점 0 = (-0.25, 1.0, 0.125), 예외 없음 |
| A′ | A 결과에서 옛 offset 12로 float32 읽기 | 다음 점의 x와 같은 값 | 비교한 999개 점 모두 다음 점의 x와 같은 값. 점 2의 옛 offset 위치와 점 3의 x 시작이 모두 바이트 36 |
| A2 | A 결과의 frame_id를 base_link로 고치기 |
같은 Header 객체라 원본도 바뀜 | 결과·원본 frame_id 모두 base_link |
| B | xyz N×3 배열을 원본 4필드와 함께 넘기기 | 열 수와 필드 수가 달라 예외 | ValueError: The length of the last dimension of arr must be equal to the number of fields in dtype |
| C | read_points(cloud).copy()의 xyz만 교체 → 새 Header(stamp 유지, base_link) + 원본 fields + point_step=cloud.point_step |
필드 4개, point_step 16, len(data) 16000, frame_id base_link |
필드 4개, point_step 16, len(data) 16000, frame_id base_link, intensity 원본과 완전 일치, 원본 메시지 불변 |
| C0 | read_points 결과를 복사 없이 고치기 |
원본 data가 바뀜 | 원본 data가 바뀜 |
| D | do_transform_cloud(cloud, TransformStamped) |
C와 같은 판정, 원본 불변 | 필드 4개, point_step 16, len(data) 16000, frame_id base_link, intensity 일치, 원본 불변. C와 바이트까지 같지는 않고 xyz 최대 차이 5.960464477539063e-08 m |
| D2 | do_transform_cloud(cloud, Transform)(stamped 아님) |
frame_id laser 유지 |
frame_id laser, 좌표는 D와 같은 판정 |
| E | 같은 4필드에 끝 패딩을 붙인 point_step 32 클라우드를 do_transform_cloud에 넣기 |
AssertionError | AssertionError |
| E2 | E의 클라우드를 C 방식으로 다시 만들기 | 성공, point_step 32, len(data) 32000 | 성공, point_step 32, len(data) 32000, intensity 일치 |
| E3 | E의 클라우드를 x·y·z만 넘겨 다시 만들기 | 패딩까지 사라짐 | point_step 12, len(data) 12000(원본 대비 0.375) |
| F | 4×3 organized 클라우드를 do_transform_cloud에 넣기 |
height 1, width 12로 펴짐 | height 1, width 12, len(data) 192로 원본과 같음 |
| G | import tf2_sensor_msgs 후 Buffer.transform(cloud, 'base_link') |
frame_id base_link, 필드 유지 |
frame_id base_link, 필드 4개, intensity 일치 |
| G0 | 같은 호출을 tf2_sensor_msgs를 import하지 않은 새 프로세스에서 |
예외 | TypeException: Type <class 'sensor_msgs.msg._point_cloud2.PointCloud2'> is not loaded or supported |
| H | /tf_static 정적 변환 + /cloud_laser 발행 → 변환 노드가 Buffer.transform → /cloud_base 수신 |
G와 같은 판정 | 필드 4개, point_step 16, len(data) 16000, frame_id base_link, intensity 일치 |
좌표는 손 공식 (x, y) → (−y, x) + t와 비교했다. 허용오차 1e-6 m에 대해 최대 절대 오차는 A·C·D·D2·E2·G·H에서 5.960464477539063e-08 m, F에서 6.984919309616089e-09 m로 모두 통과했다. 입력은 is_dense=True였지만 결과 메시지는 모든 경우 false였고, stamp는 모든 결과에서 [1700000000, 123456789]로 유지됐다.
1회차 원본 출력 가운데 환경, 경우 A, 경우 E, 경우 G0 줄을 그대로 옮긴다.
{"kind": "env", "python": "3.12.3", "numpy": "1.26.4", "sensor_msgs_py": "5.3.8", "tf2_sensor_msgs": "0.36.23", "tf2_ros_py": "0.36.23", "tf2_sensor_msgs_file": "/opt/ros/jazzy/lib/python3.12/site-packages/tf2_sensor_msgs/__init__.py", "byteorder": "little"}
{"kind": "case", "case": "A_xyz_only_original_header", "ok": true, "ms": 1.19, "fields": ["x", "y", "z"], "offsets": [0, 4, 8], "point_step": 12, "row_step": 12000, "height": 1, "width": 1000, "len_data": 12000, "w_h_step": 12000, "frame_id": "laser", "stamp": [1700000000, 123456789], "is_dense": false, "len_matches_w_h_step": true, "len_ratio_vs_original": 0.75, "same_field_names": false, "same_shape": true, "point0": [-0.25, 1.0, 0.125], "max_abs_err_vs_hand": 5.960464477539063e-08, "within_tol": true, "intensity_field_present": false, "header_is_same_object": true, "original_unchanged": true, "old_offset12_byte_for_point2": 36, "point3_x_byte": 36, "old_offset12_equals_next_x_count": 999, "old_offset12_compared": 999}
{"kind": "case", "case": "E_do_transform_cloud_padded32", "ok": false, "ms": 0.67, "exception": "AssertionError", "message": "PointFields and structured NumPy array dtype do not match for all fields!                     Check their field order, names and types."}
{"kind": "case", "case": "G0_buffer_transform_without_import", "ms": 265.77, "tf2_sensor_msgs_loaded": false, "ok": false, "exception": "TypeException", "message": "Type <class 'sensor_msgs.msg._point_cloud2.PointCloud2'> is not loaded or supported"}
재현 스크립트와 5회 실행의 원본 출력은 공개 실험 디렉터리에 있다. 개별 파일은 experiment.py와 results.json이다. Docker가 있는 빈 디렉터리에서 다음 명령으로 같은 조건을 다시 돌릴 수 있다.
curl -fsSLO https://raw.githubusercontent.com/sungpyo9053/blog/7a50adac5d6acc7780adf41264d6f100680813c2/experiments/ros2-python-transform-pointcloud2-frame-keep-fields/experiment.py
sha256sum experiment.py  # 32157cff61b951007b7912d459e4ba1afd175f473b587064eb4b5c3bae651474 이어야 한다
docker run --rm --network none --cpus 1 --memory 1g -v "$PWD":/work ros@sha256:8eed0a4669bbf43ee331878a4c39bd8ebddea8e3312a58b4fae8edb14526b617 bash -c "source /opt/ros/jazzy/setup.bash && python3 /work/experiment.py"
정상 재현의 판정 기준은 종료 코드 0, 경우 A 줄의 "point_step": 12와 "frame_id": "laser", 경우 E 줄의 "ok": false와 "exception": "AssertionError"다. ms와 시간 값은 실행마다 달라진다.
표의 열다섯 줄 모두 실측이 실행 전 예측 열과 같은 판정으로 나왔다. sensor_msgs_py 5.3.8과 tf2_sensor_msgs 0.36.23은 소스에 적힌 대로 움직였다는 뜻이다. D와 C가 좌표는 허용오차 안에서 같지만 바이트가 다른 이유는, C는 실험 스크립트가 만든 회전행렬을, D는 tf2_sensor_msgs 내부 회전행렬을 써서 float 반올림 경로가 다르기 때문으로 본다. 그래서 두 결과를 비교할 때는 바이트 동일성이 아니라 좌표 차이를 봤다.
A2와 C0은 실수하기 쉬운 지점을 하나씩 더 보여 준다. 원본 header를 넘긴 뒤 결과의 frame_id만 고치면 같은 객체를 공유하는 원본 메시지의 frame_id까지 바뀐다. read_points가 돌려주는 배열은 원본 바이트 위에 얹은 뷰(view, 복사본이 아니라 같은 메모리를 가리키는 배열)라서, 복사 없이 xyz를 고치면 원본 메시지의 data가 바뀐다. do_transform_cloud가 새 Header를 만들고 points.copy()를 하는 것도 소스 주석에 적힌 대로 이 두 가지를 피하려는 것이다(tf2_sensor_msgs.py L92-L139).
공식 함수를 쓸지, point_step을 직접 넘길지는 점 끝의 빈칸이 정한다
do_transform_cloud는 x·y·z 필드가 있는지 확인하고, read_points로 모든 필드를 읽고, xyz만 변환한 다음 원본 cloud.fields로 create_cloud를 부른다. 이때 point_step은 넘기지 않는다. Jazzy의 create_cloud는 구조화 배열을 받으면 그 dtype을 dtype_from_fields(fields, None)과 비교하는데(L268-L271), 비교 대상은 마지막 필드 끝까지만 잡은 크기다. 끝 패딩이 있으면 둘이 달라 assertion이 난다. 이 실패는 issue #305에 Jazzy 사용자 보고로 올라와 있고, 원인이 read_points가 아니라 create_cloud의 비교식이라는 설명은 PR #324 본문에 있다. Rolling은 PR #295로 고쳤지만 Jazzy 백포트 PR #326은 2026년 11월 2일 확인 시점에 아직 병합되지 않았다.
그래서 Jazzy에서의 선택은 클라우드 레이아웃을 보고 정한다.
point_step이 가장 뒤 필드의 끝과 같다면(패딩 없음)tf2_ros.Buffer.transform이나do_transform_cloud를 그대로 쓴다. 필드,point_step, target frame_id가 모두 유지된다.- 끝 패딩이 있는 드라이버 출력이라면 Jazzy 5.3.8에서는 공식 함수가 멈추므로, 원본 fields와
point_step=cloud.point_step을 넘겨 직접 다시 만든다. - 백포트가 릴리스되면 두 번째 조건은 사라질 수 있다. 쓰는 이미지의 sensor_msgs_py 버전을 확인한 뒤 판단한다.
Buffer.transform을 쓸 때 놓치기 쉬운 점이 하나 있다. PointCloud2 변환 함수는 tf2_sensor_msgs 모듈이 import될 때 tf2_ros에 등록된다. import 한 줄이 없으면 위 표의 G0처럼 “not loaded or supported” 예외가 난다. 토픽 왕복 실험(H)의 변환 노드도 아래 형태였다.
import tf2_sensor_msgs  # noqa: F401  PointCloud2 변환을 tf2_ros에 등록한다
from rclpy.duration import Duration

def on_laser(msg):
    pub_base.publish(buf.transform(msg, 'base_link', timeout=Duration(seconds=0)))
buf는 TransformListener가 채우는 tf2_ros.Buffer이고 pub_base는 /cloud_base 발행자다. Python에서 do_transform_cloud를 찾지 못한다는 2022년 Robotics Stack Exchange 질문에는 Iron으로 올리라는 답이 달려 있지만, 이 Python 구현은 PR #778로 2025년 4월 Humble 브랜치에도 병합됐다. 어느 Humble 릴리스부터 들어갔는지는 확인하지 않았고, issue #305 댓글에는 Humble에서도 같은 패딩 실패가 보고돼 있다.
직접 다시 만든다면 경우 C와 E2에서 실제로 실행해 통과한 아래 함수를 출발점으로 쓸 수 있다. xyz_target은 base_link 기준으로 이미 변환한 N×3 배열이다. 실험에서는 TransformStamped의 쿼터니언을 회전행렬로 바꿔 R·p+t를 계산했다(experiment.py의 manual_xyz).
from std_msgs.msg import Header
from sensor_msgs_py import point_cloud2 as pc2

def rebuild_in_target(cloud, xyz_target, target_frame):
    pts = pc2.read_points(cloud).copy()          # 원본 data를 건드리지 않도록 복사
    pts['x'], pts['y'], pts['z'] = xyz_target.T  # xyz만 교체, intensity 등은 그대로
    header = Header(stamp=cloud.header.stamp, frame_id=target_frame)
    out = pc2.create_cloud(header, cloud.fields, pts, point_step=cloud.point_step)
    assert [f.name for f in out.fields] == [f.name for f in cloud.fields]
    assert out.point_step == cloud.point_step
    assert (out.height, out.width) == (1, cloud.width * cloud.height)  # read_points가 1차원이므로
    assert len(out.data) == len(cloud.data) == out.width * out.height * out.point_step
    assert out.header.frame_id == target_frame
    return out
assert 다섯 줄이 발행 전 검사다. 필드 이름 목록이 같은지, point_step이 같은지, 모양이 어떻게 바뀌었는지, len(data)가 원본과 같고 width × height × point_step과 맞는지, frame_id가 target인지를 본다. len(data) 하나만 보면 부족하다. 표의 F처럼 organized 클라우드가 1행으로 펴져도 바이트 수는 192로 그대로이기 때문이다. 이 함수도 organized 클라우드를 1행으로 펴며, 격자 모양을 되살리려면 축 관례 논의(issue #236)를 먼저 확인해야 한다. 이번 실험에서 이 함수를 organized 입력에 돌리지는 않았다.
직접 답해 보기: 점을 바꾸고, 끝 패딩을 붙이고, Stamped를 빼면 결과는 어떻게 달라질까
1번은 앞의 손계산을 다른 점으로 되풀이하고, 2번은 끝 패딩이 있는 클라우드에서 바이트를 세며, 3번은 계산 없이 넘긴 인자의 타입만으로 frame_id를 판단한다.
1. 같은 가정에서 laser 점 (0, 1.0, 0)은 base_link에서 어디인가?
회전 (x, y) → (−y, x)로 (−1.0, 0, 0)이 되고, t를 더하면 (−0.75, 0, 0.125) m다. 이동부터 더한 뒤 회전하면 (−1.0, 0.25, 0.125)가 나오니, 순서가 바뀌면 답이 바뀐다는 점도 함께 확인된다.
2. 끝 패딩이 있어 point_step이 32인 점 500개짜리 클라우드를 x·y·z만 넘겨 다시 만들면 data는 몇 바이트인가?
500 × 12 = 6000바이트다. 원본은 500 × 32 = 16000바이트다. x·y·z 필드만으로 짓는 dtype에는 intensity도 패딩도 없기 때문이다. 표의 E3에서 점 1000개로 같은 원리를 확인했다.
3. do_transform_cloud(cloud, ts.transform)처럼 Stamped가 아닌 Transform을 넘기면 결과 frame_id는?
laser 그대로다. 일반 Transform에는 target 프레임 이름이 없어서 함수가 frame_id를 바꿀 근거가 없다. 소스에서는 transform이 TransformStamped일 때만 transform.header.frame_id를 새 Header에 쓰고(L105-L113), 표의 D2가 그 결과를 보여 준다. 좌표는 맞게 옮겨지므로 겉으로는 오류가 보이지 않는다.
합성 클라우드의 결론을 실제 노드로 옮길 때 남는 일
이번 결론은 90° 한 각도, float32 네 필드 레이아웃, 끝 패딩 한 종류(32바이트), 4×3 organized 한 크기에서 나왔다. 행 끝 패딩(row_step > width × point_step)이 있는 클라우드에서는 위 함수의 len(cloud.data) 비교가 실패할 수 있는데, 이 조건은 실험하지 않았다. NaN 점 처리, 메시지 시각에 맞춘 lookup의 시간 동기, C++ tf2::doTransform이나 pcl_ros 경로, 처리 성능도 다루지 않았다.
x·y·z 말고도 좌표 성분을 담은 필드가 있다면 직접 옮겨야 한다. 함수 설명 문자열(docstring)이 x·y·z만 변환하고 나머지는 손대지 않는다고 적고 있어서다. 다만 필드의 성격에 따라 적용할 연산이 다르다. normal(법선, 면이 향하는 방향) 같은 방향 벡터는 회전 R만 적용하고, viewpoint(vp_x·vp_y·vp_z, 점을 관측한 시점의 위치) 같은 위치 필드는 점 좌표처럼 회전과 이동을 모두 적용한다. 이번 합성 클라우드에는 두 필드가 없었으므로 이 구분은 측정 결과가 아니라 소스 설명과 변환 정의에서 나온 주의다.
실험은 실물 라이다나 깊이 카메라, 로봇이 아니라 컨테이너 안의 합성 메시지로 했다. frame_id가 틀린 클라우드를 장애물 인식이나 맵핑 노드가 받으면 장애물을 엉뚱한 위치에 놓을 수 있다. 실제 로봇에 연결하기 전에는 rosbag 재생이나 시뮬레이션에서 RViz로 원본과 변환 클라우드를 겹쳐 보고, 실물에서 처음 켤 때는 로봇을 정지시킨 상태로 비상 정지 수단을 손에 둔 채 확인한다.
Jazzy에서 패딩 없는 클라우드라면 import tf2_sensor_msgs 후 Buffer.transform이 가장 짧은 길이다. 드라이버가 끝 패딩을 붙인다면 백포트가 나올 때까지 원본 fields와 point_step을 넘겨 직접 다시 만들고, 어느 쪽이든 발행 전에 필드 목록·point_step·len(data)·frame_id를 원본과 비교하는 검사를 넣는다. NaN 점 거르기(skip_nans)와 필드 자료형 확인은 xyz 배열을 꺼내는 앞 단계에 속해 이번 글에서 뺐다. 그 단계의 코드는 read_points_numpy 글에 있다.