ROS 2 센서 토픽이 멈춘 걸 liveliness로 알 수 있을까: 같은 노드의 다른 토픽이 lease를 갱신하는 문서 정의와 deadline으로 토픽 단위 감시하기
센서 드라이버 노드 하나가 20 Hz 카메라 토픽과 1 Hz 진단 토픽을 함께 발행하는데, 어느 순간 카메라만 멈췄다. ROS 2 센서 토픽이 멈춘 걸 liveliness로 알 수 있을까? Robotics Stack Exchange의 공개 질문(112988번, 2024년 9월)도 같은 고민에서 출발한다. 질문자는 RealSense 드라이버의 포인트 클라우드 발행이 가끔 멈춰 장애물 감지가 끊기는 상황을 감시하고 싶었고, deadline QoS를 떠올렸지만 드라이버가 개별 QoS 정책 대신 미리 정해진 프로필 이름만 고르게 한다고 적었다. 답은 ‘아니다’다. 이 경우 liveliness는 조용하고, 카메라 토픽에 건 deadline만 정지를 알린다.
다만 제목이 가정한 이유는 측정으로 좁혀졌다. ROS 2 사용자 문서는 Automatic liveliness를 “같은 노드의 다른 publisher가 발행하면 모든 publisher가 갱신된다”고 설명하지만, ROS 2 Jazzy와 기본 RMW인 Fast DDS에서 5회 실행해 보니 노드의 발행을 전부 멈춰도 프로세스가 살아 있는 동안에는 Automatic liveliness가 8초 관찰 내내 바뀌지 않았다. 진단 토픽이 lease를 갱신해서가 아니라, 미들웨어가 발행과 무관하게 생존 신호를 보내기 때문으로 읽힌다. 이 글은 공식 문서·산술 예제·컨테이너 실측으로 두 신호가 각각 무엇을 알려 주는지 가르고, 드라이버 QoS를 못 바꿀 때 감시 노드의 deadline 구독이 연결조차 안 되는 함정과 대안까지 다룬다. 실물 카메라나 로봇은 쓰지 않았다.
따라오는 데 필요한 배경은 두 가지다. ROS 2 노드가 토픽(topic)에 메시지를 내보내는 발행자(publisher)와 받아 가는 구독자(subscription)를 만든다는 구조, 그리고 양쪽이 QoS(Quality of Service, 메시지 전달 방식에 관한 설정 묶음)를 따로 정한다는 사실이다. 구독자의 요청값이 발행자의 제공값보다 엄격하면 짝이 맺어지지 않는다는 규칙은 뒤의 드라이버 QoS 절에서 설명 없이 바로 쓰이므로, 처음 듣는 규칙이라면 ROS 2 토픽 이름이 같은데 메시지가 안 올 때: QoS 호환성을 먼저 계산하기의 계산 예제로 감을 잡고 오면 된다. 본문의 코드 발췌는 rclpy(ROS 2의 Python 클라이언트 라이브러리) 몇 줄이다.
deadline은 토픽의 간격을, liveliness는 발행자의 생존을 묻는다
deadline(기한)은 한 토픽에 연속으로 도착하는 메시지 사이의 최대 허용 간격이다. 구독자가 그 간격 안에 다음 메시지를 받지 못하면 미들웨어가 QoS 이벤트(QoS event, 정책 위반을 알리는 콜백)인 Requested deadline missed를 구독자에게 보낸다. 발행자 쪽에는 같은 상황이 Offered deadline missed로 온다(ROS 2 QoS 문서 L53-L55, L286-L318, 2026-10-04 확인). 이 이벤트는 그 토픽, 그 발행자–구독자 쌍에만 걸린다. 같은 노드의 진단 토픽이 얼마나 자주 발행하든 카메라 토픽의 deadline과는 상관없다.
liveliness(생존 신호)는 “이 발행자가 아직 살아 있는가”를 묻는다. lease duration(리스 기간)은 발행자가 생존을 알리지 않고 버틸 수 있는 최대 시간이고, 그 시간 안에 생존을 알리는 행위를 assert(단언)라고 부른다. lease를 넘기면 발행자에게는 Liveliness lost, 구독자에게는 Liveliness changed 이벤트가 온다. 구독자 이벤트에는 alive_count(살아 있는 발행자 수)와 not_alive_count(정상 삭제가 아닌 이유로 단언을 멈춘 발행자 수)가 들어 있어, 노드가 정상 종료로 사라졌는지 비정상으로 멈췄는지를 구분할 수 있다(rmw liveliness_changed.h L28-L52).
비유로 옮기면 deadline은 “매일 오던 택배가 약속한 간격 안에 왔나”이고, liveliness는 “택배 회사가 아직 영업 중인가”다. 회사가 멀쩡해도 내 택배 한 종류만 끊길 수 있다. 비유가 맞지 않는 지점도 있다. liveliness의 “영업 중”을 무엇으로 판정하는지, 즉 무엇이 lease를 갱신하는지는 비유가 말해 주지 않고, 뒤에서 보듯 공식 문서끼리도 다르게 적는다.
이 글에서 다루는 liveliness 종류는 두 가지다. Automatic(자동)은 기본값이고, MANUAL_BY_TOPIC(토픽별 수동)은 그 토픽에 발행하거나 애플리케이션이 그 토픽의 생존을 직접 단언할 때만 살아 있다고 본다(rmw types.h L472-L491).
20 Hz 카메라와 1 Hz 진단 토픽으로 먼저 계산한다
실행 전에 문서 정의만으로 손으로 계산할 수 있는 부분이 있다. 가정은 다음과 같다. 한 노드가 카메라를 20 Hz, 진단을 1 Hz로 일정하게 발행하고, 지연과 흔들림(jitter)은 없으며, 단위는 ms다. 구독자는 카메라에 deadline 100 ms를 요청하고, 두 토픽 모두 Automatic liveliness에 lease 2000 ms를 쓴다.
- 카메라 발행 주기는 1000 / 20 = 50 ms다.
- deadline 100 ms는 100 / 50 = 2, 즉 프레임 간격 두 개 분량이다. 마지막 프레임 뒤 두 간격 동안 다음 프레임이 없으면 Requested deadline missed 조건이 된다.
- 진단 토픽 주기는 1000 ms다. 사용자 문서 정의대로라면 lease 2000 − 1000 = +1000 ms의 여유가 남으므로, 카메라가 멈춰도 진단 발행이 카메라 발행자의 lease까지 계속 갱신한다.
- lease 호환성은 “요청 − 제공”의 부호로 판정한다. 제공 lease 200 ms에 요청이 150이면 −50(비호환), 300이면 +100(호환), 200이면 0(경계, 호환)이다.
이 계산을 검사하는 Python assert 문 7개는 산술 예제 example.py에 있고, 2026-10-04 Python 3.12.3에서 종료 코드 0으로 통과한 출력은 검산 기록 verification.json에 남아 있다. 이것은 산술 검산일 뿐 ROS 2를 돌린 결과가 아니다. “lease 2000 ms면 카메라 몇 프레임 만에 정지를 알아챈다” 같은 항목은 넣지 않았다. 문서가 뒷받침하지 않는 계산이고, 3번도 사용자 문서 정의를 그대로 믿었을 때만 성립하는데 그 정의부터 출처마다 다르기 때문이다.
Automatic liveliness를 무엇이 갱신하는지는 출처마다 다르게 적혀 있다
같은 Automatic을 설명하는 1차 자료를 나란히 놓으면 갱신 주체가 둘로 갈린다(모두 2026-10-04 확인).
| 출처 | Automatic을 갱신하는 것 |
|---|---|
| ROS 2 사용자 문서 L61-L68 (Rolling, Jazzy 판 L60-L67도 같은 문장) | 노드의 publisher 중 하나라도 메시지를 발행하면 그 노드의 모든 publisher를 lease duration만큼 더 살아 있다고 본다 |
| rmw types.h L472-L491 | 생존 신호가 ROS의 rmw 계층에서 온다 |
| OMG DDS 1.4 §2.2.3.11 | 서비스(미들웨어)가 lease를 갱신하며, 프로세스와 연결이 살아 있는 한 살아 있다고 본다. 프로세스 수준 실패를 감지하는 용도 |
| Fast DDS 문서 LivelinessQosPolicy | 서비스가 필요한 주기로 lease를 갱신한다. 원격 애플리케이션이 실행 중인지만 알면 되는 경우에 적합 |
| ros2/demos liveliness 데모 README L61-L79 | Automatic에서는 “rmw 구현의 자동 단언을 모두 멈추기 위해” 발행을 멈추는 대신 talker를 삭제한다 |
여기서 DDS(Data Distribution Service)는 ROS 2가 기본으로 쓰는 통신 표준이고, RMW(ROS middleware interface)는 ROS 2와 Fast DDS 같은 DDS 구현을 잇는 어댑터 계층이다. Jazzy의 rmw_fastrtps는 lease를 지정하면 Fast DDS의 생존 알림 주기(announcement_period)를 lease의 2/3로 설정한다(rmw_fastrtps qos.cpp L119-L147). 코드에서 읽은 설정값이지 관측값은 아니다.
카메라만 멈춘 경우라면 두 해석의 답이 같다. 발행 기반 정의에서는 진단 토픽이 갱신을 이어 가고, 미들웨어 기반 정의에서는 발행과 상관없이 갱신된다. 갈리는 곳은 노드의 모든 발행이 멈췄지만 프로세스는 살아 있는 경우다. 사용자 문서대로면 lease 2000 ms 뒤 not alive가 되어야 하고, DDS·Fast DDS 쪽 설명대로면 아무 일도 없어야 한다. 문서만으로는 결정할 수 없는 질문이라 측정으로 넘겼다.
Jazzy 기본 RMW에서 다섯 번 재 본 결과
실험은 감시 프로세스 하나와 드라이버 프로세스 여섯 개로 구성했다. 드라이버마다 별도 프로세스라서 DDS participant(참가자, 보통 프로세스 하나에 하나씩 생기는 DDS 통신 주체)도 따로다. 각 드라이버 노드는 /<case>/camera를 20 Hz, /<case>/diagnostics를 1 Hz로 std_msgs/Float64 메시지에 담아 발행한다. 카메라 영상이 아니라 숫자를 보내는 가짜 드라이버이고, 시뮬레이터도 실물 센서도 아니다. 메시지 값에는 발행 시각을 넣고, 모든 프로세스가 같은 커널의 monotonic 시계(CLOCK_MONOTONIC, 시스템 시각 변경에 영향받지 않고 계속 증가하는 시계)로 시간을 잰다. 이벤트 시각은 콜백이 실제로 실행된 시각이라서 executor(콜백을 차례로 실행하는 rclpy의 실행기) 지연이 포함된다.
감시 노드는 모든 구독에 세 가지 이벤트 콜백을 붙였다. 아래는 experiment.py에서 그대로 옮긴 부분이다.
callbacks = SubscriptionEventCallbacks(deadline=on_deadline, liveliness=on_liveliness,
                                       incompatible_qos=on_incompatible)
node.create_subscription(Float64, topic, on_msg, qos, event_callbacks=callbacks)
준비 단계에서 카메라 수신과 alive_count ≥ 1을 확인한 뒤, 사례마다 다른 방식으로 동시에 멈추고 8초를 지켜봤다. A는 카메라 타이머만 취소하고, B는 노드의 타이머를 모두 취소하되 노드와 프로세스는 그대로 둔다. C는 A와 같지만 카메라를 MANUAL_BY_TOPIC으로 발행한다. D는 destroy_node()로 노드를 정상 삭제하고, K는 프로세스를 SIGKILL(즉시 강제 종료 신호)로 죽인다. 예측은 실행 전에 plan.md에 적어 두었다.
측정 환경: ros:jazzy-ros-base 이미지(digest ros@sha256:066420e07f60aa18262f2479981def87ebcfcec42eefb0c0c57c4a46098348ca), ROS 2 Jazzy, Python 3.12.3, rclpy 7.1.12, rmw_fastrtps_cpp 기본 설정, 네트워크 없음, 1 CPU·1 GiB, 하네스가 5회 실행해 5회 모두 종료 코드 0. 정지 후 관찰 창은 8.0초(lease 2000 ms의 4배)다. 재현 스크립트와 실행별 원본 출력은 실험 디렉터리와 results.json에 있다.
| 사례 | 실행 전 예측 (plan.md) | 실측 (5회) |
|---|---|---|
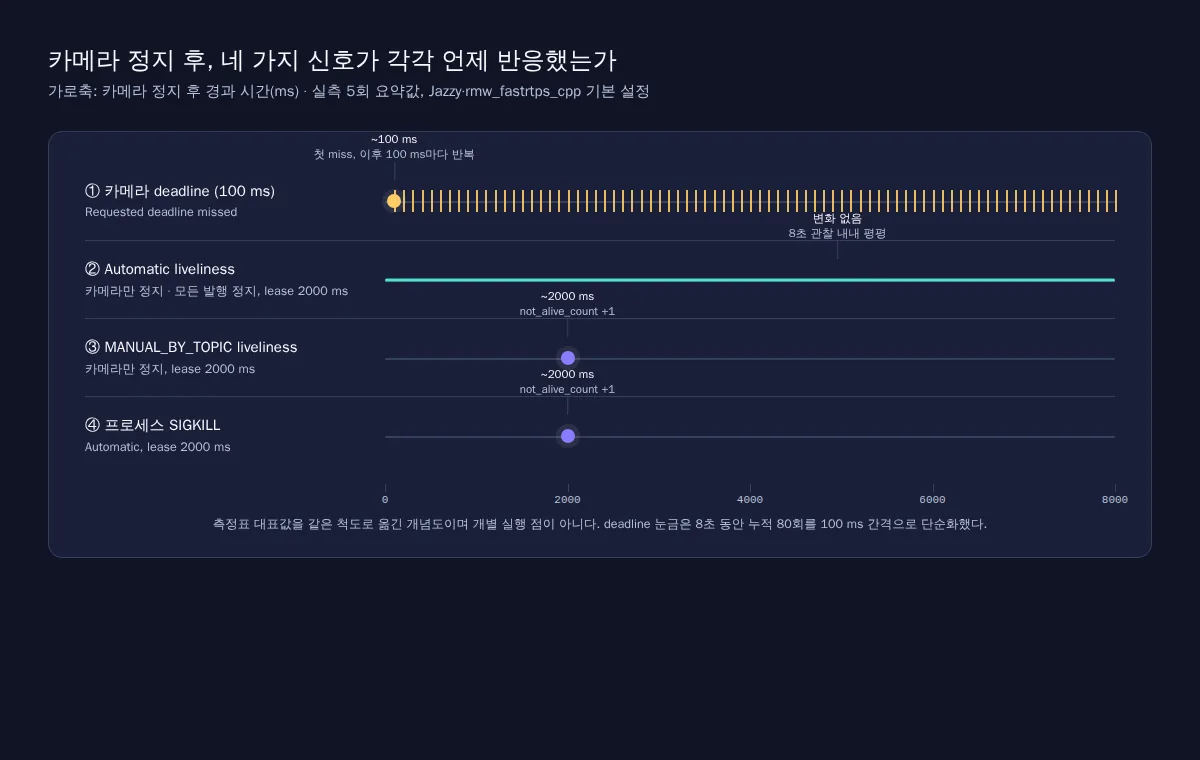
| A. 카메라만 정지, 진단 계속 (Automatic, lease 2000, deadline 100) | 약 100 ms 뒤 첫 Requested deadline missed, 8초 관찰이면 약 80회 누적. 카메라 liveliness 변화 없음 | 첫 deadline missed는 마지막 수신 뒤 97.0 / 99.6 / 98.0 / 98.0 / 125.3 ms. 정지 후 누적 80회(5회 모두). 카메라·진단 liveliness 하락 이벤트 0회. 진단은 정지 후에도 8개 수신 |
| B. 노드의 모든 발행 정지, 노드·프로세스 생존 | 사용자 문서 정의: 약 2000 ms 뒤 not alive. rmw·DDS·Fast DDS 정의: 변화 없음 | 카메라·진단 liveliness 하락 이벤트 0회(5회 모두). 마지막 발행 뒤 8002.1~8038.3 ms 동안 변화 없음. 드라이버 쪽 Liveliness lost도 0회. deadline missed는 A와 같이 80회 |
| C. 카메라만 MANUAL_BY_TOPIC, 카메라만 정지 | 약 2000 ms 뒤 구독자 not_alive_count +1, 발행자 Liveliness lost | 구독자 not_alive_count +1이 마지막 카메라 발행 뒤 2000.9 / 2000.8 / 2002.0 / 2002.1 / 2000.9 ms. 드라이버 Liveliness lost는 1999.9 / 1999.8 / 2001.5 / 2000.5 / 2001.0 ms. 진단 liveliness 변화 없음 |
D. destroy_node()로 정상 삭제, 프로세스 생존 |
alive_count −1, not_alive_count 변화 없음 | 명령 뒤 7.0~11.8 ms에 alive_count_change −1, not_alive_count_change 0. 관찰 끝 ROS 그래프의 카메라 publisher 수 0. deadline missed는 80~81회 계속 누적 |
| K. 프로세스 SIGKILL (Automatic, lease 2000) | lease 전후로 alive_count −1, not_alive_count +1 | SIGKILL 명령 뒤 1990.3 / 1995.3 / 1992.4 / 2002.4 / 1996.6 ms에 not_alive_count_change +1. 그런데 관찰 끝(명령 뒤 약 8초)에도 ROS 그래프의 카메라 publisher 수는 1 |
B를 판정한 run 1 원본 출력 한 줄과, 비교용 C·K 줄을 그대로 옮긴다.
{"case": "B_all_publishers_stop_process_alive", "baseline_camera_rx": 38, "baseline_diag_rx": 2, "camera_rx_after_stop_cmd": 0, "diag_rx_after_stop_cmd": 0, "last_camera_pub_relative_to_stop_cmd_ms": -9.1, "camera_deadline": {"first_miss_after_last_rx_ms": 98.4, "first_miss_after_last_pub_ms": 100.4, "callbacks": 80, "missed_after_last_rx": 80, "cumulative_total_count_at_window_end": 80, "window_after_last_rx_ms": 8008.1}, "camera_liveliness_drop_events": 0, "camera_first_drop": null, "diag_liveliness_drop_events": 0, "diag_first_drop": null, "observed_after_last_camera_pub_ms": 8010.1, "observed_after_last_pub_of_every_stopped_topic_ms": 8010.1, "driver_camera_liveliness_lost": [], "driver_liveliness_lost_events_any_topic": 0, "driver_camera_offered_deadline_missed_events": 82}
{"case": "C_camera_manual_by_topic_stop", "baseline_camera_rx": 45, "baseline_diag_rx": 2, "camera_rx_after_stop_cmd": 0, "diag_rx_after_stop_cmd": 8, "last_camera_pub_relative_to_stop_cmd_ms": -10.3, "camera_deadline": {"first_miss_after_last_rx_ms": 96.9, "first_miss_after_last_pub_ms": 100.1, "callbacks": 80, "missed_after_last_rx": 80, "cumulative_total_count_at_window_end": 80, "window_after_last_rx_ms": 8008.1}, "camera_liveliness_drop_events": 1, "camera_first_drop": {"alive_count": 0, "not_alive_count": 1, "alive_count_change": -1, "not_alive_count_change": 1, "after_last_camera_pub_ms": 2000.9}, "diag_liveliness_drop_events": 0, "diag_first_drop": null, "observed_after_last_camera_pub_ms": 8011.3, "observed_after_last_pub_of_every_stopped_topic_ms": 8011.3, "driver_camera_liveliness_lost": [{"after_last_camera_pub_ms": 1999.9, "total_count": 1}], "driver_liveliness_lost_events_any_topic": 1, "driver_camera_offered_deadline_missed_events": 84}
{"case": "K_process_sigkill", "baseline_camera_rx": 38, "last_camera_rx_relative_to_sigkill_cmd_ms": -7.3, "camera_liveliness_events": [{"alive_count": 0, "not_alive_count": 1, "alive_count_change": -1, "not_alive_count_change": 1, "after_sigkill_cmd_ms": 1990.3, "after_last_camera_pub_ms": 2001.8}], "diag_liveliness_events": [{"alive_count": 0, "not_alive_count": 1, "alive_count_change": -1, "not_alive_count_change": 1, "after_sigkill_cmd_ms": 1990.3}], "camera_deadline": {"first_miss_after_last_rx_ms": 97.0, "first_miss_after_last_pub_ms": 101.1, "callbacks": 80, "missed_after_last_rx": 80, "cumulative_total_count_at_window_end": 80, "window_after_last_rx_ms": 8008.0}, "graph_publishers_on_camera_at_window_end": 1, "observed_after_cmd_ms": 8000.7}
B 줄의 camera_liveliness_drop_events: 0이 판정값이다. 모든 발행이 멈춘 뒤 lease의 4배 동안 Automatic liveliness는 한 번도 떨어지지 않았고, 같은 lease 2000 ms를 쓴 C의 MANUAL_BY_TOPIC과 K의 SIGKILL은 2000 ms 근처에서 정확히 떨어졌다.
예측과 비교하면 A, C, D, K는 plan.md에 적은 대로 나왔다. A의 다섯 번째 실행에서 첫 deadline missed가 다른 실행보다 늦었는데, 1 CPU에서 프로세스 일곱 개가 함께 도는 조건이라 콜백 실행이 밀린 것으로 보이며 원인을 따로 재지는 않았다. B는 plan.md에 두 갈래 예측을 적어 둔 사례였고, 사용자 문서의 “발행하면 갱신” 정의에서 나온 예측은 다섯 번 모두 맞지 않았다. 결과는 rmw 헤더·DDS 표준·Fast DDS 문서·데모 README 쪽 설명과 일치한다. 그러니 이 환경에서 Automatic liveliness가 답하는 질문은 “노드가 발행 중인가”가 아니라 “그 프로세스가 살아서 통신하고 있는가”에 가깝다. DDS 표준이 말한 “프로세스 수준 실패 감지”가 K에서 그대로 나타났다.
해석을 하나 더 붙이면, K에서 not alive 이벤트가 SIGKILL 명령 뒤 2000 ms보다 조금 이르게 온 실행이 있다. lease가 kill 시점이 아니라 그 전에 보낸 마지막 생존 신호부터 세어진다고 보면 설명되지만, 생존 신호 시각을 직접 기록하지는 않았다.
측정에서 실무에 바로 쓸 수 있는 관찰도 두 가지 나왔다. D처럼 노드를 정상 삭제하면 alive_count만 줄고 not_alive_count는 그대로였고, K처럼 프로세스가 죽으면 not_alive_count가 늘었다. 그래서 감시 노드는 두 카운트로 “정상 종료”와 “비정상 정지”를 가를 수 있다. 반대로 SIGKILL 뒤 8초가 지나도 감시 노드의 count_publishers()는 죽은 카메라 publisher를 여전히 1개로 셌다. 적어도 이 관찰 창 안에서는 “그래프에 발행자가 있다”를 생존의 근거로 쓰면 강제 종료된 드라이버를 놓친다는 뜻이다. 측정한 것은 감시 노드 안의 이 함수 호출뿐이고, ros2 topic info 같은 CLI는 실행하지 않았다. 죽은 발행자가 그래프에서 언제 사라지는지도 재지 않았다.
D에서는 발행자가 사라진 뒤에도 deadline missed가 계속 쌓였다. deadline만 보면 “토픽이 멈췄다”는 사실만 알 뿐, 드라이버가 정상 종료했는지, 멈췄는지, 죽었는지는 liveliness 카운트를 함께 봐야 구분된다.
total_count를 읽을 때도 주의할 점이 있다. 시험 실행 단계에서 누적값인 total_count가 매칭 직후 첫 샘플 전에 놓친 주기까지 포함해 정지 후 증가분보다 1 크게 찍힌 실행이 있었다. 그래서 측정 스크립트는 정지 뒤의 total_count_change 합과 누적값을 따로 출력한다. 감시 코드도 “정지 후 몇 번 놓쳤나”를 알고 싶다면 누적값보다 total_count_change를 더하는 편이 정확하다.
다른 환경에서 같은 측정을 반복하려면 Docker와 고정 이미지 digest로 실행한다. 스크립트를 내려받은 디렉터리에서 다음 명령을 쓰면 된다.
curl -fsSLO https://raw.githubusercontent.com/sungpyo9053/blog/main/experiments/ros2-liveliness-lease-duration-vs-deadline-topic-stall/experiment.py
docker run --rm --network none --cpus 1 --memory 1g -v "$PWD":/work ros@sha256:066420e07f60aa18262f2479981def87ebcfcec42eefb0c0c57c4a46098348ca bash -c "source /opt/ros/jazzy/setup.bash && python3 /work/experiment.py"
정상이라면 종료 코드 0과 함께 사례별 JSON 줄이 출력된다. 준비 단계에서 25초 안에 기준 수신을 못 채우면 baseline_not_reached를 출력하고 종료 코드 1로 끝나므로, 그때는 숫자를 해석하지 말고 실행 환경부터 확인한다.
드라이버 QoS를 못 바꾸면 감시 노드의 deadline 구독은 연결되지 않는다
질문자가 막힌 지점은 따로 있었다. deadline 이벤트는 발행자도 deadline을 제공해야 성립한다. 발행자 deadline이 기본값(Default)인데 구독자만 값을 요청하면 비호환이라 연결이 맺어지지 않는다는 규칙은 HuntLab의 ROS 2 센서 토픽에 deadline QoS를 걸 때 확인할 호환성 글에서 공식 호환성 표와 산술로 이미 판정했고, 같은 표에서 lease duration도 “발행자 Default + 구독자 x”가 비호환이다(QoS 문서 호환성 표 L193-L275). 여기서 보탤 것은 두 가지다. 질문자처럼 프로필 이름만 고르게 하는 드라이버가 이 규칙에 걸리는지, 그리고 그 판정이 실제 rclpy 노드에서도 같은지다.
realsense-ros의 <stream_type>_qos 파라미터가 받는 값은 SYSTEM_DEFAULT, DEFAULT, PARAMETER_EVENTS, SERVICES_DEFAULT, PARAMETERS, SENSOR_DATA뿐이고(realsense-ros README L452-L457), rmw에서 이 프로필들은 모두 deadline과 lease가 기본값이다(rmw qos_profiles.h L25-L102). 두 사실을 합치면, 이런 드라이버에 감시 노드만 deadline을 요청하면 그 감시 구독이 통째로 끊긴다는 추론이 나온다. 각 전제는 공식 자료로 확인했지만 둘을 결합한 판단은 HuntLab의 추론이고, realsense-ros 자체를 실행하지는 않았다.
실험의 사례 E가 이 추론을 일반 rclpy 발행자로 확인한다. 기본 QoSProfile(depth=10)로 발행하는 /w/camera에 더 엄격한 요청을 붙였고, 별도로 lease 200 ms를 제공하는 /e/lease200에 세 가지 lease를 요청했다. 같은 방식으로 사례 W에서는 대안인 워치독(watchdog, 마지막 수신 시각을 주기적으로 확인하는 감시 타이머)을 기본 QoS 구독 위에 올렸다.
| 감시 구독의 요청 (발행자 제공) | 예측 | 실측 (5회) |
|---|---|---|
| deadline 100 ms (발행자 Default) | 비호환 | 수신 0, Requested incompatible QoS 1회, 정책 DEADLINE (5회 모두) |
| lease 150 ms (발행자 Default) | 비호환 | 수신 0, 정책 LIVELINESS (5회 모두) |
| MANUAL_BY_TOPIC (발행자 Automatic) | 비호환 | 수신 0, 정책 LIVELINESS (5회 모두) |
| lease 150 ms (발행자 lease 200) | 비호환, 150 − 200 = −50 | 수신 0, 정책 LIVELINESS (5회 모두) |
| lease 300 ms (발행자 lease 200) | 호환, +100 | 수신 212 / 186 / 191 / 187 / 218, 비호환 이벤트 0 |
| lease 200 ms (발행자 lease 200) | 호환, 경계 0 | 수신 수가 lease 300 구독과 실행마다 같음, 비호환 이벤트 0 |
| 워치독: 기본 QoS 구독, 임계 100 ms, 확인 주기 10 ms | 마지막 수신 뒤 100~110 ms 사이 발화 | 마지막 수신 뒤 104.4 / 104.2 / 109.2 / 100.4 / 109.3 ms에 발화. 5회 중 2회는 정지 전 준비 단계에서도 한 번씩 발화(그때 수신 간격 107.1 ms, 104.7 ms) |
run 1의 원본 출력 일부다.
{"case": "E_compatibility", "subscription": "e_deadline100_vs_default", "topic": "/w/camera", "messages_received": 0, "requested_incompatible_events": 1, "incompatible_total_count": 1, "last_policy": "DEADLINE"}
{"case": "E_compatibility", "subscription": "e_lease150_vs_offered200", "topic": "/e/lease200", "messages_received": 0, "requested_incompatible_events": 1, "incompatible_total_count": 1, "last_policy": "LIVELINESS"}
{"case": "E_compatibility", "subscription": "e_lease300_vs_offered200", "topic": "/e/lease200", "messages_received": 212, "requested_incompatible_events": 0, "incompatible_total_count": 0, "last_policy": null}
{"case": "W_watchdog_default_qos", "threshold_ms": 100, "check_period_ms": 10, "baseline_rx": 52, "fired": true, "fire_after_last_rx_ms": 104.4, "fire_after_last_pub_ms": 109.8, "fires_during_warmup_and_run": 2, "fires_before_stop_gap_ms": [107.1]}
호환성 표의 판정은 실제 노드에서도 그대로 나왔다. 기존 글이 표로 계산한 deadline 조합뿐 아니라 lease와 liveliness 종류 조합도 수신 0이었다. 그래서 감시 구독이 받은 메시지가 0개라면 센서가 멈춘 게 아니라 연결이 없는 것일 수 있고, 그 구분은 Requested incompatible QoS 이벤트로 한다. 이 실험은 비호환 콜백을 직접 등록했지만, 콜백을 따로 주지 않으면 rclpy가 “offering incompatible QoS” 경고를 남기는 기본 콜백을 붙인다는 것은 소스에서 읽은 내용이다(rclpy event_handler.py L205-L216).
워치독은 QoS 기능이 아니라 애플리케이션 코드라서 드라이버 QoS와 상관없이 붙는다. 실험에서 쓴 판정 부분은 이렇다.
def check_watchdog():
    rx = subs["w_camera"]["rx"]
    if not rx:
        return
    now = time.monotonic()
    stale = now - rx[-1][0] > WATCHDOG_THRESHOLD_MS / 1000.0
    if stale and not watchdog["stale"]:
        watchdog["fires"].append({"t": now, "last_rx": rx[-1][0], "last_pub": rx[-1][1]})
    watchdog["stale"] = stale
node.create_timer(WATCHDOG_CHECK_MS / 1000.0, check_watchdog)
대가도 측정에 나왔다. 임계를 프레임 간격 두 개로 빠듯하게 잡자, 1 CPU에서 프로세스 일곱 개가 뜨는 준비 단계에서 센서가 멈추지 않았는데도 두 번 발화했다. 이 측정은 적정 임계값을 알려 주지 않는다. 자기 시스템에서 정상 상태의 수신 간격 분포를 먼저 재고, 그보다 넉넉한 임계와 “연속 몇 번 초과해야 경보” 같은 규칙을 직접 정해야 한다. deadline도 같은 이유로 너무 짧게 잡으면 부하가 걸릴 때 경보가 쌓인다.
스스로 판정해 보기
문제 1. 드라이버의 카메라 발행자는 Automatic liveliness를 제공하고, 감시 노드가 그 토픽을 구독하다 Liveliness changed 이벤트를 받았다. alive_count_change는 −1, not_alive_count_change는 0이다. 드라이버에 무슨 일이 있었다고 읽어야 하나? 같은 이벤트에서 not_alive_count_change가 +1이었다면 무엇이 달라지고, 드라이버가 MANUAL_BY_TOPIC을 제공하는 경우에도 같은 해석을 쓸 수 있나?
앞의 경우는 사례 D와 같은 조합, 즉 발행자의 정상 삭제다. 뒤의 경우는 정상 삭제가 아닌 이유로 생존 신호가 끊긴 것인데, Automatic 발행자에서 이번 측정에 이 조합을 만든 것은 프로세스 SIGKILL(사례 K)뿐이었다.
마지막 물음에서 갈린다. 생존을 무엇으로 단언하는지는 발행자가 제공하는 liveliness 종류가 정하고, 구독자의 요청은 연결이 맺어지는지만 가른다. 발행자가 MANUAL_BY_TOPIC이면 사례 C처럼 프로세스는 멀쩡하고 카메라 발행만 멈춰도 2000 ms 근처에서 +1이 나왔다. C에서는 드라이버와 감시 구독이 둘 다 MANUAL_BY_TOPIC이었다. 감시 구독을 Automatic으로 만든다고 이 경우를 피할 수 있는 것도 아니다. 호환성 표에서 발행자 MANUAL_BY_TOPIC + 구독자 Automatic은 호환이라 연결이 맺어지고(QoS 문서 L222-L241), 그때도 단언은 발행자의 MANUAL_BY_TOPIC 방식을 따를 것으로 읽힌다. 이 조합 자체는 측정하지 않았다. 그래서 “+1이면 프로세스가 죽었다”고 읽기 전에 구독 설정이 아니라 드라이버 발행자가 제공하는 liveliness 종류가 Automatic인지부터 확인해야 한다.
문제 2. 같은 노드에서 소프트웨어 버그로 모든 타이머가 멈췄지만 프로세스는 살아 있다. Automatic liveliness, lease 2000 ms를 쓰는 구독자는 2초 뒤 Liveliness changed를 받는가?
ROS 2 사용자 문서 문장만 보면 받는다고 읽힌다. 그러나 Jazzy·rmw_fastrtps_cpp 기본 설정에서 측정한 사례 B에서는 lease의 4배를 기다려도 오지 않았다. 이 상황은 각 토픽의 deadline이 알려 준다. Automatic liveliness에 “노드가 일을 멈췄다”는 판정을 맡기면 안 된다.
문제 3. 카메라 토픽 하나만 생존 신호로 감시하고 싶고, 드라이버 코드를 직접 고칠 수 있다. 어떻게 설정하는가?
발행자를 MANUAL_BY_TOPIC으로 바꾸고 구독자도 MANUAL_BY_TOPIC과 같거나 더 긴 lease를 요청한다. 발행자 Automatic + 구독자 MANUAL_BY_TOPIC은 비호환이라 구독자 쪽만 바꾸면 연결이 끊긴다(QoS 문서 L222-L241). 실험의 C 사례에서 드라이버는 assert_liveliness()를 따로 부르지 않았고, 카메라 발행만으로 alive 상태가 유지됐다. 다만 lease 단위로 알게 되므로, 같은 정지를 deadline 100 ms보다 훨씬 늦게 알아챈다.
어디까지 믿고 어디서 다시 재야 하나
신호별 역할을 나누면 이렇다. 토픽이 멈췄는지는 토픽별 deadline(발행자도 제공해야 함)이나, 드라이버 QoS를 못 바꾸면 워치독으로 본다. 프로세스가 죽었는지는 발행자가 Automatic liveliness를 제공할 때의 not_alive_count로, 정상 종료인지는 not_alive_count 변화 없이 줄어드는 alive_count로 본다. 토픽 단위 생존 신호가 꼭 필요하고 발행자를 고칠 수 있을 때만 MANUAL_BY_TOPIC을 쓴다.
이 결론의 범위는 ROS 2 Jazzy, rclpy, rmw_fastrtps_cpp 기본 설정, 네트워크 없는 단일 호스트 컨테이너다. Cyclone DDS나 Zenoh 같은 다른 RMW, 여러 호스트 사이의 네트워크, rclcpp, 같은 프로세스 안의 다른 노드가 갱신에 주는 영향, 실물 카메라 드라이버의 내부 정지는 측정하지 않았다. 다른 RMW로 바꾸면 사례 B부터 다시 재야 한다. Automatic의 갱신 주체가 RMW 구현에 달려 있다는 것이 이번 측정이 보여 준 점이기 때문이다.
마지막으로, deadline·liveliness 이벤트와 워치독은 모두 진단 신호다. 장애물 감지처럼 안전에 걸린 센서라면 이 신호를 받아 속도 명령을 막는 상위 로직과 하드웨어 비상정지가 따로 있어야 하고, 그 동작은 실제 로봇에서 별도로 검증해야 한다. 감시 노드에 deadline을 걸기 전에 발행자의 deadline 제공값부터 계산하려면 ROS 2 센서 토픽에 deadline QoS를 걸 때 확인할 호환성을 이어서 보면 된다.
참고 링크
- ROS 2 Documentation — About Quality of Service settings (Rolling): deadline·liveliness 정의, 호환성 표, QoS 이벤트
- OMG Data Distribution Service 1.4 (PDF): §2.2.3.11 LIVELINESS
- ros2/rmw types.h, requested_deadline_missed.h: liveliness 종류와 deadline 카운트 정의
- rclpy event_handler.py:
SubscriptionEventCallbacks인자 - 실험 스크립트 experiment.py, 5회 원본 출력 results.json
이 글에는 제휴·협찬이 없다.