colcon build 스레드 수를 줄이고 싶을 때: 라즈베리 파이가 멈추면 –executor sequential로 동시 빌드 메모리와 시간 계산하기
라즈베리 파이에 ROS 2를 올리고 colcon build를 돌렸더니 화면과 마우스가 멈춘다. 이때 찾게 되는 질문은 대개 둘이다. colcon build 스레드 수를 어떻게 줄이는가, 그리고 줄이면 빌드가 얼마나 느려지는가. 2020년 ROS Answers(지금은 Robotics Stack Exchange로 옮겨졌다)에 올라온 질문도 요지가 같았다. 예전 빌드 도구에서 쓰던 -j 옵션이 colcon에서는 통하지 않는데, 동시에 도는 스레드 수는 어떻게 정하느냐는 것이었다.
공식 ROS 2 colcon 튜토리얼이 내놓는 답은 --executor sequential이다. 그런데 이 옵션이 1로 만드는 것은 동시에 빌드하는 패키지 수다. 패키지 하나를 빌드하는 동안 함께 도는 컴파일러는 여전히 CPU 수만큼 남는다. 그래서 제목의 “스레드 수 줄이기”를 끝까지 하려면 MAKEFLAGS="-j1" 같은 설정을 따로 줘야 한다. 아래에서는 colcon 소스 코드로 이 두 겹 구조를 확인하고, 손으로 검산한 예제로 메모리 예산과 시간 대가를 계산한 다음, 1 CPU·1 GiB 컨테이너에서 실제 colcon을 5회 돌린 측정과 맞춰 본다. 라즈베리 파이 실물에서 잰 값은 없다.
colcon build를 한 번 이상 돌려 봤고 프로세스와 RAM이 무엇인지 안다면 따라올 수 있다. 계산은 곱셈과 나눗셈이 전부다. 다 읽고 나면 내 장비에서 패키지를 몇 개까지 동시에 빌드해도 되는지, 그 대가로 시간이 어느 범위에서 늘어날지를 직접 정할 수 있다.
sequential을 켜도 컴파일러가 여러 개 남는 이유
먼저 용어 몇 개를 정리한다. 워크스페이스(workspace)는 src 아래에 패키지 여러 개를 두고 한꺼번에 빌드하는 폴더이고, 패키지(package)는 colcon이 빌드하는 단위다. 실행기(executor)는 colcon이 여러 패키지의 빌드 작업을 어떤 방식으로 처리할지 정하는 확장이다. 여러 개를 동시에 처리하는 parallel이 기본이고, 하나씩 처리하는 sequential을 고를 수 있다(colcon executor 인자 문서).
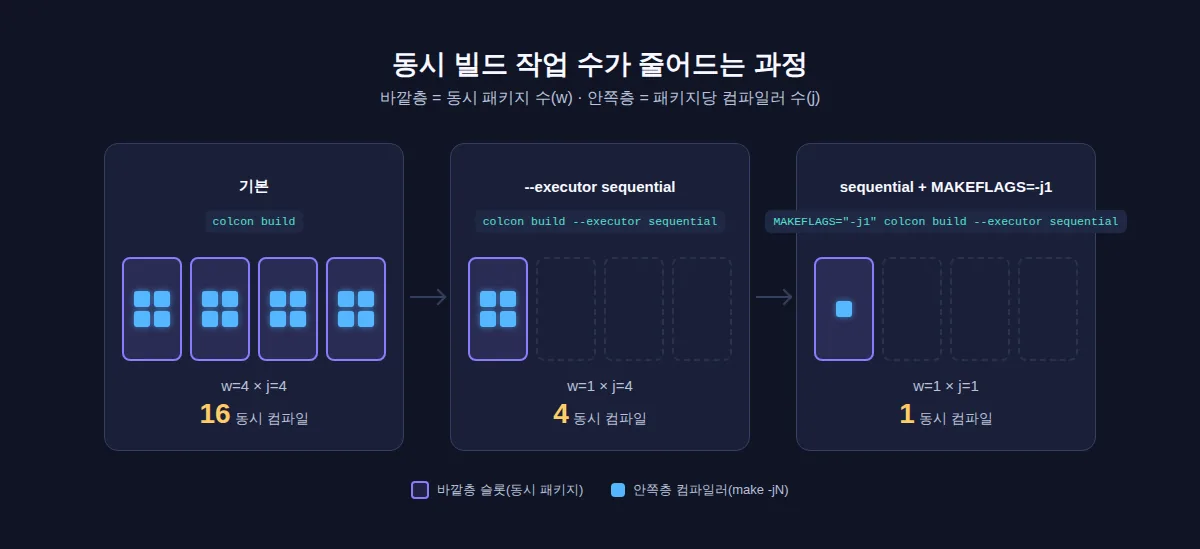
colcon의 동시성은 두 층에서 생긴다.
바깥층, 패키지 단위. parallel 실행기는 아직 시작하지 않은 패키지 가운데 자기가 의존하는 패키지가 모두 끝난 것만 시작 가능(ready)으로 본다. 그리고 진행 중인 개수가 --parallel-workers(병렬 작업자 수)에 닿으면 더 시작하지 않는다. 이 값의 기본은 논리 CPU 수다. 코드로는 os.cpu_count()와, 프로세스가 쓸 수 있도록 허용된 CPU 개수(affinity) 중 작은 값이다(parallel.py L51-L63, ready 판정 L129-L134).
sequential 실행기는 소스 주석 그대로 “한 번에 패키지 하나를, 위상 정렬 순서로” 처리한다(sequential.py L21-L25). 위상 정렬(topological ordering)은 “먼저 끝나야 하는 패키지가 앞에 오도록” 줄을 세우는 방법이다.
안쪽층, 패키지 내부. CMake 기반 패키지(ament_cmake 포함)를 빌드할 때 colcon-cmake는 cmake --build <빌드 디렉터리> -- -jN -lN을 실행하고, N은 여기서도 CPU 수다. -j(jobs)는 make가 동시에 실행하는 작업 수다. 보통 작업 하나가 컴파일러 프로세스 하나라서, -j4면 컴파일러가 최대 4개 함께 돈다.
-l(load average)은 개수가 아니라 시스템 부하를 보고 거는 제동이다. load average는 실행 중이거나 실행을 기다리는 작업 수의 최근 평균이고, GNU make는 이미 작업이 하나 이상 돌고 있을 때 이 평균이 -l 값보다 낮지 않으면 새 작업 시작을 미룬다(GNU make 병렬 실행). 그래서 실제 동시 작업 수는 -j 값보다 적을 때가 있다.
colcon이 붙이는 -jN -lN을 바꾸는 손잡이는 환경 변수 MAKEFLAGS(make가 실행될 때 읽는 옵션 묶음)다. 여기에 -j, -l, --jobs, --load-average 가운데 하나라도 들어 있으면 colcon-cmake는 자기 값을 붙이지 않고 MAKEFLAGS에 맡긴다(build.py L281-L316).
두 층을 합치면 식은 하나다.
동시에 돌 수 있는 컴파일 작업 수의 상한 = (동시 패키지 수 w) × (패키지당 make 작업 수 j)
라즈베리 파이 4와 5는 모두 4코어다(BCM2711, BCM2712). 소스의 기본값을 그대로 넣으면 이렇게 된다.
| 명령 | w | j | 상한 |
|---|---|---|---|
colcon build |
4 | 4 | 16 |
colcon build --executor sequential |
1 | 4 | 4 |
colcon build --parallel-workers 2 |
2 | 4 | 8 |
MAKEFLAGS="-j1" colcon build --executor sequential |
1 | 1 | 1 |
sequential은 16을 4로 줄일 뿐 1로 만들지 않는다. --parallel-workers 1도 바깥층만 1로 만든다는 점에서 같고, 문서상 이 옵션은 parallel 실행기에서만 의미가 있다. 주방에 비유하면 sequential은 요리 팀을 한 팀만 들이는 조치이고, 그 팀이 켜는 화구 수(make 작업)는 그대로다. 비유가 놓치는 점도 있다. 표의 숫자는 켤 수 있는 화구의 최대치일 뿐이고, 실제 동시 개수는 ready인 패키지 수, 패키지마다 컴파일할 파일 수, -l 제동 때문에 이보다 적을 수 있다.
CMAKE_BUILD_PARALLEL_LEVEL=1로 줄이려는 시도도 흔하다. colcon-cmake가 -- 뒤에 -jN을 직접 넘기는 경로에서는 이 변수를 바꿔도 컴파일러 수가 줄지 않을 수 있다. 이 부분은 colcon-cmake 코드 경로에서 읽은 해석이고, CMake 공식 문서로 우선순위를 따로 확인하지는 않았다. 안쪽층을 줄일 때는 MAKEFLAGS를 쓰는 편이 코드와 맞는다.
소스는 colcon-parallel-executor 0.4.0(커밋 bb4e553), colcon-cmake 0.2.30(커밋 5d6bc11), colcon-core master(커밋 6bfb100, 최신 태그 0.21.3)를 2026년 10월 4일에 확인했다. 설치된 버전은 다를 수 있다. 소스상 colcon build --help가 --parallel-workers 기본값을 함께 표시하도록 되어 있으니 내 환경에서는 그 줄을 보면 된다.
메모리 예산은 동시 패키지 수와 패키지 하나의 최고점을 곱한다
메모리를 따질 때 쓰는 값은 상주 메모리(RSS, resident set size), 즉 프로세스가 실제로 RAM에 올려 쓰고 있는 양이다. RAM이 모자라면 리눅스는 메모리 일부를 디스크의 스왑(swap) 공간으로 내보낸다. 메모리 부족을 늦춰 주지만, 디스크를 오가는 동안 빌드는 느려질 수 있다.
예산식은 바깥층만 센다.
필요한 메모리 상한 ≈ w × m
여기서 m은 패키지 하나를 빌드하는 동안의 메모리 최고점이다. 이 값에는 그 패키지 안에서 make -j로 함께 돈 컴파일러들이 이미 들어 있다. w × m이 장비 RAM보다 크면 스왑을 쓰거나 프로세스가 강제 종료될 위험이 커진다. 패키지들의 최고점이 늘 같은 순간에 겹치지는 않으므로 이 곱은 최악의 겹침을 가정한 상한이다.
손으로 검산하려고 고른 값으로 계산해 보자. RAM 4 GB, m = 1.25 GB, 4코어 기본값이라 w = 4다. 라즈베리 파이에서 잰 숫자가 아니라 계산을 따라가기 위한 가정이다.
- 기본 빌드: 4 × 1.25 = 5 GB. RAM보다 1 GB 많다.
- sequential: 1 × 1.25 = 1.25 GB.
- RAM에 들어가는 동시 수: 4 ÷ 1.25 = 3.2이므로 정수 부분인 3, 곧
--parallel-workers 3이 이 가정에서의 최대치다. OS와 데스크톱이 쓰는 메모리는 이 계산에 빠져 있으니 실제로는 더 낮게 잡는다. - 같은 워크스페이스를 CPU 4개, RAM 16 GB인 데스크톱에서 빌드하면 w는 그대로 4이고, 5 GB는 RAM의 5 ÷ 16 = 0.3125, 약 31%다. 이 장비라면 sequential이 필요할 가능성은 낮다.
- 단, w의 기본값은 CPU 수를 따라간다. 같은 16 GB라도 논리 CPU가 16개면 기본 w = 16이고, m을 1.25 GB로 그대로 둬도 16 × 1.25 = 20 GB로 RAM을 넘는다. 이때는 j도 16이 되므로 실제 m은 이보다 클 수 있다. 이 곱은 아래 example.py의 10개 식에 들어 있지 않은, 여기서 덧붙인 손 계산이다. RAM이 넉넉해 보여도 CPU 수를 w에 먼저 넣어 봐야 한다.
이 계산과 다음 절의 시간 계산은 교육용 예제 코드 example.py에 10개 식으로 들어 있고, Python 3.12.3에서 10개가 모두 기대값과 일치해 종료 코드 0으로 끝난 검산 기록 verification.json도 공개돼 있다. 산술 검산이지 colcon이나 컴파일러를 실행한 기록은 아니다.
여기서 놓치기 쉬운 지점이 있다. m 안에 -j4 컴파일 4개가 들어 있으므로 sequential은 w만 4에서 1로 줄이고 m은 건드리지 않는다. 무거운 C++ 패키지 하나가 -j4만으로 RAM에 가까운 m을 만든다면 sequential을 켜도 부족하고, MAKEFLAGS로 j를 줄여야 m이 내려간다. Robotics Stack Exchange에는 2 GB 라즈베리 파이 4B에서 sequential, --parallel-workers 1, CMAKE_BUILD_PARALLEL_LEVEL=1을 모두 줘도 컴파일러 4개가 계속 돌았고 MAKEFLAGS="-j 1"로 해결했다는 사용자 보고가 있다. 위 식이 설명하는 상황과 같다.
시간 대가는 패키지 시간의 합과 가장 긴 사슬 사이에 있다
시간은 벽시계 시간(wall-clock time), 즉 명령을 친 순간부터 끝날 때까지 실제로 흐른 시간으로 잰다. 계산을 위해 “패키지 하나의 빌드 시간은 다른 패키지가 동시에 도는지와 상관없다”고 가정한다. 이 가정이 언제 깨지는지는 뒤의 측정에서 드러난다.
패키지 시간이 30, 40, 50, 60초인 독립 패키지 4개를 생각하자.
- sequential: 시간의 합, 30 + 40 + 50 + 60 = 180초.
- 작업자 4개인 병렬 빌드의 하한: 일을 고르게 나누면 180 ÷ 4 = 45초지만, 패키지 하나는 쪼갤 수 없으니 가장 긴 60초보다 빨리 끝날 수 없다. 둘 중 큰 값인 60초가 하한이다.
- 그러므로 sequential은 이 가정에서 최대 180 ÷ 60 = 3배 느리다.
일반화하면 병렬 빌드의 하한은 max(시간의 합 ÷ 작업자 수, 가장 긴 의존 사슬)이다. 가장 긴 의존 사슬을 임계 경로(critical path)라고 부르는데, “A가 끝나야 B를 시작할 수 있다”로 이어진 패키지 줄 가운데 시간이 가장 긴 줄이다.
반례도 있다. 네 패키지가 A→B→C→D로 한 줄로 의존하면 parallel 실행기도 ready인 패키지가 늘 하나뿐이라 한 번에 하나씩 빌드한다. 임계 경로가 180초 전부이므로 sequential로 바꿔도 잃는 시간이 없다.
3배는 위 가정 아래의 상한이다. 패키지마다 이미 make -j4가 4코어를 거의 채운다면 패키지 4개를 동시에 돌려도 쓸 수 있는 CPU 총량은 늘지 않는다. 그때 패키지들은 서로 CPU를 나눠 쓰며 각자 느려지고, sequential과의 차이는 3배보다 작아진다. 반대로 CMake 설정 단계나 링크처럼 안쪽 병렬성이 없는 구간이 길면 패키지를 동시에 돌리는 이득이 커진다. 메모리가 넘쳐 스왑을 쓰기 시작하면 이 모델로는 시간을 예측할 수 없다.
1 CPU 컨테이너에서 colcon을 실제로 돌린 결과
계산이 실제 colcon 동작과 맞는지 보려고 ROS 2 Jazzy 공식 이미지 안의 colcon·CMake·make·gcc로 작은 워크스페이스를 빌드했다. CMake 패키지 4개(p30, p40, p50, p60)에 C 파일이 4개씩 있다.
모든 컴파일은 컴파일러 앞에 끼워 실행되는 런처(CMAKE_C_COMPILER_LAUNCHER)를 거친다. 런처는 컴파일 한 건마다 16 MiB 메모리를 실제로 잡고, 패키지별로 정한 시간만큼 기다린 뒤 진짜 gcc를 실행하며 시작·종료 시각과 자기 최대 RSS를 남긴다. 기다리는 시간은 위 예제의 30~60초를 200분의 1로 줄인 값이다. “무거운 C++ 파일 하나”를 흉내 낸 입력 조건일 뿐 측정값이 아니고, 실제 C 파일은 아주 작다.
호스트 CPU가 2개뿐이어서 taskset으로 4코어 보드를 흉내 낼 수는 없었다. 그래서 4코어에서 colcon이 쓸 기본값(--parallel-workers 4, make -j4 -l4)을 명시한 조건을 따로 넣었다. 컨테이너에는 1 CPU 할당량이 걸려 있지만 affinity는 바뀌지 않으므로 colcon은 CPU를 2개로 본다. 따라서 이 환경의 기본값은 w = 2, j = 2로 예측했다.
재현 스크립트와 실행별 원본 출력은 공개 저장소의 실험 폴더에 있다(experiment.py, results.json).
측정 환경. 이미지 ros@sha256:066420e07f60aa18262f2479981def87ebcfcec42eefb0c0c57c4a46098348ca(ros:jazzy-ros-base), 네트워크 없음, 1 CPU·1 GiB 제한(cgroup cpu.max = 100000 100000), os.cpu_count() 2, affinity 2. Python 3.12.3, colcon-core 0.21.3, colcon-cmake 0.2.30, colcon-parallel-executor 0.3.0, CMake 3.28.3, make 4.3, gcc 13.2.0. RMW는 기본값 rmw_fastrtps_cpp지만 노드를 띄우지 않으므로 결과에 관여하지 않는다. 전체 실험을 5회 반복했고 5회 모두 종료 코드 0이었다. 각 조건은 모든 .c 파일의 수정 시각을 갱신한 뒤 다시 빌드한 값이며, CMake 설정이 포함된 첫 빌드는 비교에서 뺐다.
동시에 몇 개가 돌았나. 계산값은 w × j, 실측은 런처의 시작·종료 구간을 겹쳐 센 최댓값이다.
| 조건 | 계산 (w × j) | colcon이 붙인 make 인자 | 동시 패키지 (5회) | 동시 컴파일 (5회) |
|---|---|---|---|---|
기본 colcon build |
2 × 2 = 4 | -j2 -l2 |
2 | 4 |
--executor sequential |
1 × 2 = 2 | -j2 -l2 |
1 | 2 |
--parallel-workers 1 |
1 × 2 = 2 | -j2 -l2 |
1 | 2 |
--executor sequential + MAKEFLAGS=-j1 |
1 × 1 = 1 | 없음 | 1 | 1 |
4코어 기본값 재현 (--parallel-workers 4 + MAKEFLAGS="-j4 -l4") |
4 × 4 = 16 | 없음 | 4 | 16, 5회차만 15 |
| 일렬 의존 p30→p40→p50→p60, 기본 | ready 1개 → 1 × 2 = 2 | -j2 -l2 |
1 | 2 |
시간. 벽시계 시간과, 컴파일 작업 한 건씩 걸린 시간을 모두 더한 값의 5회 범위(초)다.
| 조건 | 계산이 말한 방향 | 벽시계 | 컴파일 작업 시간 합 |
|---|---|---|---|
| 기본 | 기준 | 3.103~3.641 | 4.579~5.374 |
--executor sequential |
기본보다 길다 (컴파일 단계 하한 2배) | 4.111~4.374 | 4.498~4.624 |
--parallel-workers 1 |
sequential과 같다 | 4.1~4.325 | 4.49~4.748 |
sequential + MAKEFLAGS=-j1 |
sequential보다 길다 | 5.838~6.766 | 4.064~4.186 |
| 4코어 기본값 재현 | 기본보다 짧다 (컴파일 단계 하한 3분의 1) | 3.162~3.217 | 10.294~10.783 |
| 일렬 의존, 기본 | sequential과 거의 같다 | 4.205~4.292 | 4.445~4.636 |
| 일렬 의존, sequential | 위와 거의 같다 | 4.278~4.298, 1회차만 5.614 | 4.569~4.917 |
| CPU를 쓰는 부하, 기본 | 차이가 없거나 병렬이 느릴 수 있다 | 4.98~5.09 | 9.542~10.242 |
| CPU를 쓰는 부하, sequential | 위와 비교 | 4.645~5.335 | 4.93~5.683 |
“CPU를 쓰는 부하”는 런처가 기다리는 대신 CPU를 소모하게 바꾼 조건이며, 실행 시간 한도 때문에 부하를 0.5배로 줄였다. 일렬 의존 sequential의 1회차는 p50 하나가 2.15초 걸린 실행이다. colcon 콘솔의 Finished <<< 시간을 패키지별로 더하면 기본 빌드에서는 5.01~5.69초였고, 실제 sequential 빌드에서는 3.66~3.93초였다.
메모리. 같은 순간 살아 있던 컴파일 작업(런처) RSS 합의 최고점과, /usr/bin/time -v의 “Maximum resident set size”와 같은 원천인 getrusage(RUSAGE_CHILDREN).ru_maxrss를 나란히 놓았다(MiB, 5회 범위).
| 조건 | 컴파일 작업 RSS 합 최고점 | ru_maxrss |
|---|---|---|
sequential + MAKEFLAGS=-j1 |
27.6 | 40.7~41.0 |
--executor sequential |
55.0~55.1 | 40.7~41.0 |
| 기본 | 109.7~110.1 | 40.7~40.8 |
| 4코어 기본값 재현 | 380.3~439.4 | 40.8~41.0 |
컴파일 작업 한 개의 최대 RSS는 27.6~27.7 MiB였다. 9개 조건 전체에서 ru_maxrss는 40.7~41.2 MiB 사이였고, /proc 표본으로 본 가장 큰 단일 프로세스는 매번 컴파일 작업이 아니라 /usr/bin/python3 /usr/bin/colcon, 즉 colcon 자신이었다.
1회차 원본 출력에서 세 줄을 그대로 옮긴다.
{"kind": "condition", "label": "sequential", "colcon_args": "--executor sequential", "makeflags": null, "hold_mode": "sleep", "note": "", "exit_code": 0, "wall_s": 4.287, "jobs_total": 16, "jobs_failed": 0, "max_concurrent_jobs": 2, "max_concurrent_packages": 1, "sampled_peak_launchers": 2, "sum_job_s": 4.624, "sum_finished_s": 3.84, "finished_s": {"p30": 0.79, "p40": 0.95, "p50": 0.98, "p60": 1.12}, "sampled_peak_launcher_rss_sum_mib": 55.1, "sampled_peak_all_rss_sum_mib": 167.7, "sampled_max_single_rss_mib": 40.7, "sampled_max_single_proc": "/usr/bin/python3 /usr/bin/colcon", "max_job_vmhwm_mib": 27.7, "ru_maxrss_children_mib": 40.7, "loadavg1_before": 0.615234375, "sampler_samples": 188, "colcon_added_make_args": ["-j2 -l2"]}
{"kind": "condition", "label": "sequential_makeflags_j1", "colcon_args": "--executor sequential", "makeflags": "-j1", "hold_mode": "sleep", "note": "", "exit_code": 0, "wall_s": 5.857, "jobs_total": 16, "jobs_failed": 0, "max_concurrent_jobs": 1, "max_concurrent_packages": 1, "sampled_peak_launchers": 1, "sum_job_s": 4.068, "sum_finished_s": 5.41, "finished_s": {"p30": 1.06, "p40": 1.26, "p50": 1.44, "p60": 1.65}, "sampled_peak_launcher_rss_sum_mib": 27.6, "sampled_peak_all_rss_sum_mib": 121.6, "sampled_max_single_rss_mib": 40.7, "sampled_max_single_proc": "/usr/bin/python3 /usr/bin/colcon", "max_job_vmhwm_mib": 27.7, "ru_maxrss_children_mib": 40.7, "loadavg1_before": 0.615234375, "sampler_samples": 283, "colcon_added_make_args": []}
{"kind": "condition", "label": "quad_core_defaults", "colcon_args": "--parallel-workers 4", "makeflags": "-j4 -l4", "hold_mode": "sleep", "note": "4코어 보드에서 colcon이 쓸 기본값(작업자 4, make -j4 -l4)을 명시적으로 준 조건", "exit_code": 0, "wall_s": 3.217, "jobs_total": 16, "jobs_failed": 0, "max_concurrent_jobs": 16, "max_concurrent_packages": 4, "sampled_peak_launchers": 16, "sum_job_s": 10.378, "sum_finished_s": 10.74, "finished_s": {"p30": 2.59, "p50": 2.66, "p40": 2.74, "p60": 2.75}, "sampled_peak_launcher_rss_sum_mib": 380.3, "sampled_peak_all_rss_sum_mib": 549.2, "sampled_max_single_rss_mib": 41.0, "sampled_max_single_proc": "/usr/bin/python3 /usr/bin/colcon", "max_job_vmhwm_mib": 27.7, "ru_maxrss_children_mib": 41.0, "loadavg1_before": 0.5205078125, "sampler_samples": 76, "colcon_added_make_args": []}
동시성은 계산과 그대로 맞았다. --executor sequential과 --parallel-workers 1은 동시 패키지를 1로 만들었지만 colcon-cmake가 여전히 -j2 -l2를 붙여 컴파일은 2개씩 돌았다. MAKEFLAGS=-j1을 더하자 colcon은 make 인자를 붙이지 않았고 컴파일도 1개로 내려갔다. 4코어 재현 조건의 5회차가 16이 아니라 15였던 것은 -l4 제동과 시작 타이밍 탓으로 보인다. 상한이지 고정값이 아니라는 앞의 설명과 어긋나지 않는다.
시간도 방향은 계산대로 나왔다. sequential은 다섯 번 모두 기본보다 오래 걸렸고, 안쪽층까지 1로 줄이면 더 오래 걸렸다. 다만 sequential과 기본의 차이는 컴파일 단계 하한이 말한 2배에 한참 못 미쳤다. colcon과 CMake가 패키지마다 쓰는 고정 시간이 섞이기 때문이라고 본다.
일렬 의존 워크스페이스는 반례 계산과 같았다. parallel 실행기도 한 번에 패키지 하나만 빌드했고, sequential과 시간 차이가 거의 없었다.
4코어 재현 조건에서는 동시 컴파일이 16개까지 올라갔는데도 벽시계 시간이 기본값 범위 안에 들어갔다. 실험 계획은 “벽시계 비율이 컴파일 단계 하한의 비율보다 작을 것”이라는 방향만 예측했고, 결과는 그 방향의 끝, 곧 이득이 거의 없는 쪽이었다. 컴파일 작업 시간 합은 기본의 약 두 배로 늘었다. 작업 16개가 1 CPU 할당량을 나눠 쓰느라 한 건 한 건이 느려졌다고 해석할 수 있다.
CPU를 쓰는 부하에서는 sequential이 5회 중 4회 더 빨랐다. 앞 절에서 말한 “CPU가 이미 차 있으면 패키지 병렬의 이득은 작다”를 작은 규모로 확인한 결과다.
메모리 쪽은 측정 도구를 고를 때 바로 쓸 수 있는 결과다. 동시에 살아 있던 컴파일 작업의 RSS 합은 동시 작업 수를 따라 늘었지만, /usr/bin/time이 보여 주는 값과 같은 ru_maxrss는 어느 조건에서나 거의 같았다. getrusage(2)가 설명하듯 이 값은 가장 큰 자식 프로세스 하나의 RSS이지 동시에 돈 프로세스의 합이 아니다. 이 실험에서는 그 “가장 큰 하나”가 colcon 자신이었다. 실제 C++ 빌드라면 컴파일러 하나가 colcon보다 커질 수 있겠지만 그래도 단일 프로세스 값이라는 점은 같다(측정하지 않은 해석이다).
이 측정에는 분명한 한계가 있다. 부하는 기다리기와 CPU 소모로 만든 모형이라 실제 C++ 컴파일러의 메모리·시간이 아니다. 1 CPU 할당량에 호스트 CPU 2개인 컨테이너이고, 라즈베리 파이의 열 제한, SD 카드 입출력, zram 같은 조건은 들어 있지 않다. make의 -l은 컨테이너 밖 호스트 부하에도 영향을 받는다. RSS 합에는 공유 라이브러리 페이지가 중복으로 들어간다. 이미지의 colcon-parallel-executor는 0.3.0이어서 소스를 읽은 0.4.0과 버전이 다르지만, 기본 작업자 수가 CPU 수라는 점은 동시 패키지 2라는 실측으로 확인됐다.
같은 측정을 직접 돌리려면 Docker가 있는 컴퓨터에서 고정 커밋의 스크립트를 받아 해시를 확인한 뒤, 측정 때와 같은 이미지·CPU·메모리·네트워크 제한으로 실행한다. 측정에 쓴 실행 명령에는 이 밖에 프로세스 수 제한(--pids-limit 256), /tmp를 메모리 파일시스템으로 두는 --tmpfs /tmp, 읽기 전용 마운트 같은 격리 설정이 더 있었다. 아래 명령은 그 설정을 뺀 형태다. sha256sum 결과는 7e96d0f59dacc2abede3f447ba05fa387fb9fc26d9e9e984a9868976d7e602cc여야 한다.
curl -fsSLO https://raw.githubusercontent.com/sungpyo9053/blog/dea5c03b16d2e76f13790373281b01561a3dfa1a/experiments/colcon-build-executor-sequential-memory-budget/experiment.py
sha256sum experiment.py
docker run --rm --network none --cpus 1 --memory 1g -v "$PWD":/work ros@sha256:066420e07f60aa18262f2479981def87ebcfcec42eefb0c0c57c4a46098348ca bash -c "source /opt/ros/jazzy/setup.bash && python3 /work/experiment.py"
출력은 환경 한 줄, 워밍업 두 줄, 조건 9줄, done 한 줄의 JSON이다. 모든 조건의 exit_code가 0이면 정상 실행이고, 하나라도 빌드가 실패하면 스크립트가 그 조건 이름과 함께 멈춘다. 호스트 CPU 수가 다르면 기본값도 달라지므로 os_cpu_count를 먼저 보고, sequential 조건의 colcon_added_make_args가 그 CPU 수의 -jN -lN인지 확인한다.
내 워크스페이스에서 숫자를 정하는 순서
--executor sequential과 MAKEFLAGS=-j1 조합은 위 컨테이너에서 실제로 실행했다. MAKEFLAGS="-j2" 조합과 nproc, colcon graph, vmstat은 문서로 의미를 확인했을 뿐 이 글에서 출력을 확인하지 않았다.
# 1. 기본 w와 j의 기준이 되는 CPU 수
nproc
# 2. 의존 구조. 한 줄로 길게 이어져 있으면 sequential의 시간 손해가 작다
colcon graph
# 3. 다른 터미널에서 빌드하는 동안 5초마다 메모리(MiB 단위)와 스왑 입출력 기록
vmstat -S M 5
# 4. 바깥층만 1로
colcon build --executor sequential
# 5. 그래도 멈추면 안쪽층도 줄인다
MAKEFLAGS="-j2" colcon build --executor sequential
MAKEFLAGS="-j1" colcon build --executor sequential
colcon graph는 패키지를 위상 정렬 순서로 늘어놓고 직접·간접 의존을 표시한다. 여기서 가장 긴 사슬을 찾으면 병렬 빌드 하한을 가늠할 수 있다.
패키지별 시간은 colcon 콘솔의 Finished <<< <패키지> [시간] 줄에서 얻는다(console_start_end.py L47-L54). 이 시간들의 합이 sequential 빌드 시간의 근사치다. 다만 병렬 빌드 로그에서 더하면 패키지들이 자원을 나눠 쓰며 늘어난 시간이 섞여, 위 측정처럼 실제 sequential 시간보다 크게 나온다. sequential로 한 번 빌드한 로그에서 합과 가장 긴 사슬을 읽는 편이 정확하다.
메모리 압박은 vmstat(8)의 free(남은 메모리)와 si/so(초당 스왑에서 들여오고 내보낸 양) 열로 본다. /usr/bin/time -v colcon build의 최대 메모리는 앞에서 본 대로 가장 큰 프로세스 하나의 값이니 동시 빌드 합계로 읽지 않는다.
판정은 이렇게 한다. 빌드가 끝까지 가고, 빌드 내내 si/so가 대부분 0이고, 화면이 반응하면 그 설정으로 충분하다. 화면이나 SSH가 멈추거나, si/so가 계속 0이 아니거나, c++: fatal error: Killed signal terminated program cc1plus 같은 강제 종료 메시지가 나오면 한 단계 더 줄인다. 이 메시지는 메모리 부족 상황에서 사용자들이 흔히 보고하는 증상이지만, 원인이 메모리라고 단정할 근거는 메시지 자체에 없다.
줄이는 순서는 기본 → --executor sequential → MAKEFLAGS="-j2" → MAKEFLAGS="-j1"이다. MoveIt 2 시작 가이드는 메모리가 더 제한된 장비용으로 MAKEFLAGS="-j4 -l1" colcon build --executor sequential을 예로 든다. -l1이면 이미 작업 하나가 돌 때 load average가 1 이상인 한 새 작업을 미루므로, -j4라도 실제로는 훨씬 적게 돌 수 있다.
빌드를 멈추려면 Ctrl+C를 한 번 누른다. 기본 parallel 실행기는 이 신호를 받으면 진행 중인 패키지를 중단된 것으로 표시하고, 같은 신호를 받은 빌드 프로세스들이 멈추기를 기다렸다가 종료한다. 빌드를 끝까지 마치는 것이 아니라 멈추는 데 걸리는 짧은 대기다. 그 사이 누르는 두 번째 Ctrl+C는 무시하도록 되어 있다(parallel.py L78-L93). 화면이 완전히 굳었다면 다른 컴퓨터에서 SSH로 접속해 정리하는 방법을 생각해 둔다. 여기서 다루는 것은 빌드 작업뿐이어서 로봇이 움직이는 일은 없다.
손으로 풀어 볼 세 가지 상황
1. RAM 8 GB, 4코어, 패키지 하나의 최고점 m = 2.5 GB. 기본 빌드는 괜찮을까, 아니면 --parallel-workers를 얼마로 줘야 할까?
기본은 w = 4라서 4 × 2.5 = 10 GB로 RAM을 2 GB 넘는다. 들어가는 동시 수는 8 ÷ 2.5 = 3.2, 정수 부분 3이 상한이다. OS가 쓰는 메모리를 빼면 이보다 낮게 잡아야 한다.
2. 4코어 라즈베리 파이에서 --executor sequential만 켰다. 동시에 돌 수 있는 컴파일러는 최대 몇 개이고, MAKEFLAGS="-j2"를 더하면 어떻게 될까?
sequential은 w만 1로 만드니 1 × 4 = 4개다. MAKEFLAGS="-j2"를 주면 colcon-cmake가 자기 -j4 -l4를 붙이지 않으므로 1 × 2 = 2개가 된다.
3. 패키지 A(30초)→B(40초)가 이어져 있고 C(50초), D(60초)는 독립이다. 작업자 4개로 병렬 빌드하면 하한은 몇 초이고, sequential은 최대 몇 배 느릴까?
sequential은 합인 180초다. 병렬 하한은 max(180 ÷ 4 = 45, 가장 긴 사슬)인데, 가장 긴 사슬은 A→B의 70초로 D의 60초보다 길다. 하한은 70초이고, sequential은 이 가정에서 최대 약 2.6배 느리다. 의존 하나가 생기자 3배였던 상한이 줄어든다.
이 계산이 맞지 않는 조건
MAKEFLAGS로 안쪽층을 줄이는 방법은 리눅스 기본인 Makefile 생성기 기준이다. 생성기(generator)는 CMake가 어떤 빌드 도구용 파일을 만들지 정하는 설정이다. colcon-cmake가 -jN -lN을 붙이지 않는 것은 다중 구성 생성기일 때뿐이고(build.py L238-L243), 코드가 다중 구성으로 보는 것은 Ninja Multi-Config, Visual Studio, Xcode다(__init__.py L224-L228). 그래서 일반 Ninja 생성기도 Makefile과 똑같이 -- -jN -lN을 받는다.
Ninja에서 달라지는 쪽은 MAKEFLAGS 단계다. MAKEFLAGS에 -j가 있으면 colcon은 생성기와 상관없이 자기 -jN -lN을 빼는데, Ninja가 그 MAKEFLAGS를 읽어 작업 수를 줄이는지는 이 글에서 확인하지 않았다. Ninja를 쓴다면 위의 MAKEFLAGS 단계를 그대로 옮기지 말고, 동시에 도는 컴파일러 수를 직접 확인해야 한다. ament_python 패키지는 이 CMake 경로를 타지 않으므로 표의 j가 적용되지 않는다.
메모리 예산식은 최악의 겹침을, 시간 모델은 패키지 시간이 동시 실행과 무관하다는 가정을 깔고 있다. 위 측정이 보여 주듯 CPU가 이미 차 있으면 병렬의 이득은 계산보다 작아지고, 스왑이 시작되면 시간은 예측 범위를 벗어난다.
그래서 판단은 장비와 워크스페이스에 따라 갈린다. RAM 4 GB 이하 보드에서 무거운 C++ 패키지를 빌드한다면 --executor sequential만으로 끝내지 말고, 멈춤이 계속될 때 MAKEFLAGS로 안쪽층까지 줄인다. CPU 수를 넣은 w × m이 RAM에 여유 있게 들어가고 화면이 멀쩡하다면 기본값을 바꿀 이유가 없다. 의존 관계가 한 줄로 길게 이어진 워크스페이스라면 sequential로 바꿔도 잃는 시간은 작다. 옵션을 고르기 전에 colcon graph와 sequential 빌드 한 번의 Finished 시간, 그리고 그동안의 vmstat 기록부터 남겨 두자.
참고 링크
- ROS 2 문서: colcon 튜토리얼 원문(rolling) — 자원이 부족한 시스템에서
--executor sequential을 권하는 팁, 2026-10-04 확인 - colcon executor 인자 문서 —
--executor,--parallel-workers기본값 - colcon-cmake build.py, make 인자 결정 구간
- GNU make 병렬 실행 —
-j와-l - 실험 스크립트와 5회 실행 원본 results.json
제휴·협찬 없이 작성했다.