ROS 2 Python에서 PointCloud2를 xyz 배열로 바꾸려면: read_points_numpy와 point_step·skip_nans로 점 개수와 바이트 위치 계산하기
깊이 카메라(depth camera)나 라이다(LiDAR)가 보낸 토픽을 rclpy 구독 콜백으로 받아 msg.data를 찍어 보면 좌표 대신 바이트가 길게 나온다. ROS 1에서 쓰던 sensor_msgs.point_cloud2.read_points()를 찾아도 ROS 2에는 같은 import 경로가 없다. 2022년 Robotics Stack Exchange에 올라온 질문도 정확히 여기서 막혔다. ROS 2 Python에서 PointCloud2를 xyz 배열로 바꾸려면 sensor_msgs_py.point_cloud2.read_points_numpy(cloud, field_names=['x', 'y', 'z'], skip_nans=True)를 쓰면 되고, 그 함수가 하는 일은 width, height, point_step, 필드별 offset 네 가지 값만 알면 손으로 계산할 수 있다.
그런데 이 호출이 기대와 다르게 움직이는 조건이 있다. skip_nans=True는 메시지의 is_dense가 False일 때만 NaN 점을 빼고, 같은 자료형인지 검사할 때는 고른 필드끼리가 아니라 첫 번째 필드 fields[0]을 기준으로 비교한다. 바이트 위치 공식 i*point_step + offset도 행 끝에 빈 바이트가 없을 때만 맞는다. 2026년 10월 13일, ROS 2 Jazzy의 sensor_msgs_py 5.3.8 소스를 읽고 세운 예측을 Jazzy 컨테이너에서 5회 실행해 대조했고, 모든 항목이 예측대로 나왔다. 합성 메시지로 확인한 결과이며 실제 센서 드라이버와 Humble 런타임은 실행하지 않았다. 다 읽고 나면 받은 메시지의 필드 몇 개만 출력해 보고 read_points_numpy를 그대로 쓸지, 다른 경로로 돌아갈지 고를 수 있다.
data는 점 하나에 point_step 바이트씩 잘린 배열이다
점구름(point cloud)은 3차원 점 좌표의 모음이다. ROS에서는 이를 sensor_msgs/PointCloud2 메시지로 보낸다. 이 메시지는 좌표를 숫자 배열로 들고 있지 않고, 모든 점을 이진 덩어리(binary blob) data에 이어 붙인 뒤 그 덩어리를 어떻게 잘라 읽을지를 따로 적어 둔다. 설명에 쓰이는 필드는 PointCloud2.msg와 PointField.msg에 정의돼 있다.
height,width: 점의 배치다. 깊이 카메라처럼 이미지와 같은 격자로 점을 내보내는 정렬된 클라우드(organized cloud)는height행 ×width열이다. 순서 없는 클라우드는height=1이고width가 점 개수다.fields: 점 하나 안에 무엇이 들었는지 적은PointField목록이다. 각 항목은 이름(name), 점의 시작에서 몇 바이트 떨어져 있는지(offset), 자료형 번호(datatype, 예: FLOAT32=7, UINT16=4), 원소 개수(count)를 갖는다.point_step: 점 하나가 차지하는 바이트 수다. 필드 크기 합보다 클 수 있고, 남는 자리는 빈 바이트(padding)다.row_step: 한 행이 차지하는 바이트 수다. 메시지 정의상data의 길이는row_step * height다.is_dense: 메시지 주석 원문은 “True if there are no invalid points”, 즉 무효한 점이 하나도 없다는 송신 측의 표시다.
바이트 순서(엔디언, endianness)를 알려 주는 is_bigendian도 있지만, 이 글은 리틀엔디언 환경만 다룬다.
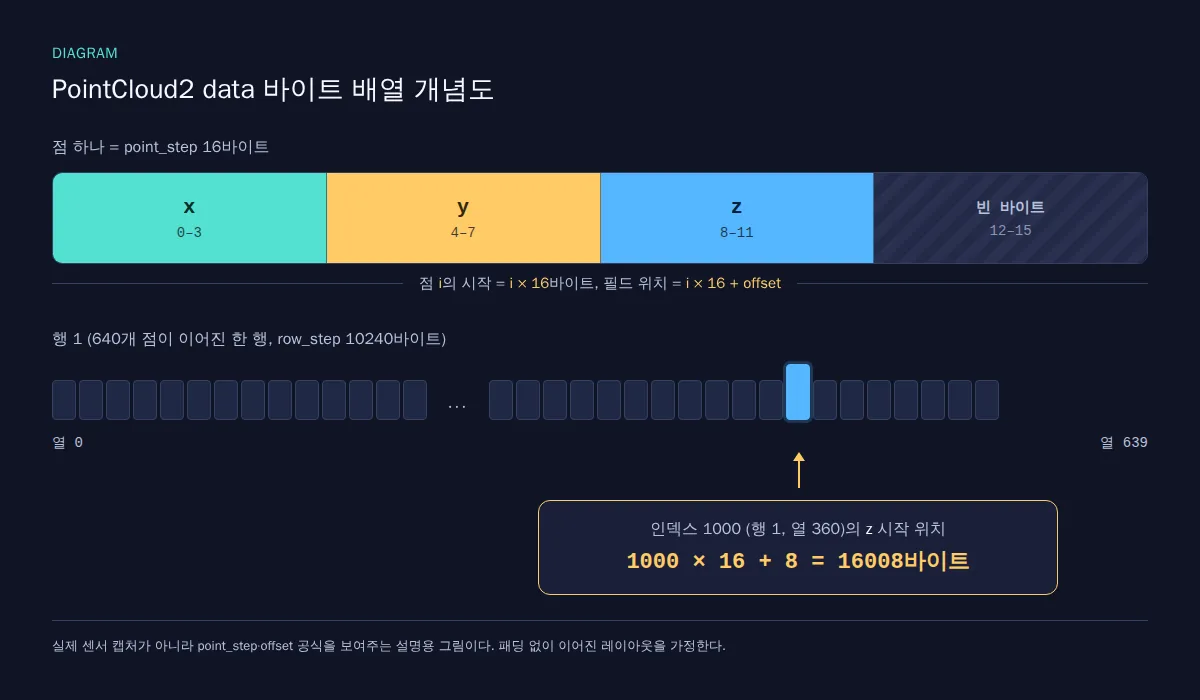
예를 들어 x, y, z가 각각 4바이트 float32이고 offset이 0, 4, 8, point_step이 16이라면 점 하나는 “x 4바이트, y 4바이트, z 4바이트, 빈 4바이트”로 된 16바이트 칸이다. 이 칸이 빈틈없이 이어진다면 점 i는 i * 16 바이트에서 시작하고, 그 점의 z는 거기서 8바이트 더 간 i * 16 + 8에서 시작한다. 일반식은 i * point_step + offset이다. 이 공식이 맞으려면 행 끝에 빈 바이트가 없어야 한다(row_step == width * point_step). 이 조건은 뒤에서 다시 다룬다.
640×480 깊이 카메라 클라우드로 먼저 계산해 본다
설명용 가정을 하나 세운다. 깊이 카메라가 640×480 정렬 클라우드를 보내고, 필드는 x, y, z(float32, offset 0, 4, 8), point_step은 16, 행 끝 패딩은 없다. 실제 장치에서 잰 레이아웃이 아니라 계산을 따라가기 위한 값이다.
| 알고 싶은 값 | 식 | 결과 |
|---|---|---|
| 점 개수 | 640 × 480 | 307200개 |
data 길이 |
307200 × 16 | 4915200바이트 |
한 행의 길이(row_step) |
640 × 16 | 10240바이트 |
| 인덱스 1000 점의 z 시작 위치 | 1000 × 16 + 8 | 16008바이트 |
| 전체 빈 바이트 | 307200 × (16 − 12) | 1228800바이트 |
| xyz만 꺼낸 float32 배열 | 307200 × 3 × 4 | 3686400바이트, shape (307200, 3) |
인덱스 1000은 width가 640이므로 행 1, 열 360의 픽셀이다. 행 단위로 다시 계산하면 row_step × 1 + 360 × 16 + 8 = 10240 + 5760 + 8 = 16008로 같은 값이 나온다. 두 식이 일치하는 것은 패딩이 없어 row_step이 정확히 width × point_step이기 때문이다.
마지막 행이 눈에 띈다. data는 4915200바이트인데 xyz 배열은 3686400바이트다. 차이 1228800바이트가 바로 빈 바이트이며, xyz만 꺼내면 이 자리가 빠진다. NaN이 섞인 경우도 같은 방식으로 계산할 수 있다. 예컨대 NaN 점이 40000개라면 skip_nans=True의 결과는 307200 − 40000 = 267200행이어야 한다. 다만 이 기대는 다음 절에서 볼 is_dense 조건이 맞을 때만 성립한다.
이 산술은 자체 예제 example.py로 작성했고, Python 3.12.3에서 8개 사례가 기대값과 일치했다는 검산 기록 verification.json이 공개돼 있다. 이것은 사칙연산 검산이며 ROS나 센서를 실행한 결과가 아니다. ROS에서 실제로 같은 값이 나오는지는 아래 실측 절에서 따로 확인한다.
read_points_numpy는 이 공식을 NumPy dtype으로 옮긴다
read_points_numpy가 바이트를 직접 한 칸씩 읽지는 않는다. Jazzy 소스를 따라가면 순서는 이렇다.
dtype_from_fields가 필드마다 이름, NumPy 자료형,offset을 넣고 원소 크기(itemsize)를point_step으로 고정한 구조화 dtype을 만든다(L190-L235). 구조화 배열(structured array)은 원소 하나가 이름 붙은 여러 필드를 갖는 NumPy 배열이다.read_points가np.ndarray(shape=(width*height,), dtype=..., buffer=cloud.data)로data를 복사 없이 그 dtype으로 해석한다(L84-L87). 원소 크기가point_step이니 원소 i는i*point_step에서 시작하고, 필드는 거기서offset만큼 더 간 자리를 읽는다. 앞 절의 공식이 그대로 코드가 된 셈이다.field_names가 있으면points[list(field_names)]로 고른다(L90-L94). 열은 요청한 순서대로 나온다.['z', 'x']를 주면 z, x 순이다.read_points_numpy는 자료형 검사를 한 뒤structured_to_unstructured로 구조화 배열을 평범한 2차원 배열로 바꾼다(L150-L155). float32 xyz라면 결과는 float32(N, 3)이다.
from sensor_msgs_py import point_cloud2 as pc2

xyz = pc2.read_points_numpy(cloud, field_names=["x", "y", "z"], skip_nans=True)
2단계에서 쓰는 값은 width*height와 point_step뿐이다. row_step은 어디에도 등장하지 않는다. 행 끝에 패딩이 있는 클라우드라면 두 번째 행부터 읽는 위치가 밀린다는 뜻이다. ROS 1의 read_points는 행마다 row_step * v로 이동했다(ROS 1 L81-L113).
앞의 Stack Exchange 질문에 2024년에 달린 유일한 답변은 read_points_list로 namedtuple 리스트를 만든 뒤 np.array로 다시 묶는 방법을 안내한다. 동작은 하지만, read_points_list는 이미 만든 구조화 배열을 리스트로 풀어낸 것(L186-L187)이어서 같은 배열을 한 바퀴 돌아 얻는 경로다. 속도 차이는 재지 않았으므로 여기서는 경로가 하나 더 길다는 점만 짚는다.
skip_nans는 is_dense 표시를 그대로 믿는다
공식 API 문서는 skip_nans를 “If True, then don’t return any point with a NaN value”라고만 설명한다. 소스의 조건은 한 단어가 더 붙은 if skip_nans and not cloud.is_dense:다(L101-L109). is_dense=True인 메시지에서는 NaN 검사 자체가 실행되지 않는다.
메시지 정의로 보면 이상한 동작은 아니다. is_dense=True가 “무효한 점이 없다”는 약속이니, 약속을 믿고 검사를 건너뛴 최적화로 읽힌다. 문제는 송신 측이 NaN을 담고도 is_dense=True를 보낼 때다. 그러면 skip_nans=True를 줘도 NaN 행이 배열에 그대로 남는다. 이런 송신 측이 얼마나 흔한지는 확인하지 않았다. 확인할 수 있는 것은 “그런 메시지가 오면 이렇게 된다”까지다.
ROS 1에서 옮겨 온 코드라면 결과가 바뀔 수도 있다. ROS 1 Noetic은 if skip_nans:만 보고 점마다 NaN을 검사했고 is_dense는 보지 않았다(ROS 1 L81). 같은 인자를 넘겨도 ROS 2에서는 걸러지지 않는 메시지가 생길 수 있다.
필터가 실행될 때도 걸러지는 것은 NaN뿐이다. 검사가 np.isnan이라 무한대(inf) 값이 든 점은 남는다. 그래서 is_dense 표시를 믿지 않으려면, 또는 inf까지 빼려면 마스크를 직접 거는 편이 확실하다.
import numpy as np

xyz = pc2.read_points_numpy(cloud, field_names=["x", "y", "z"], skip_nans=False)
xyz = xyz[np.isfinite(xyz).all(axis=1)]
“is_dense는 깨끗하다는 표시이고 skip_nans는 그 표시를 믿는다”는 비유는 송신 측 표시를 검증하지 않는다는 데까지만 맞다. 표시가 False여도 inf는 그대로 통과한다는 점은 이 비유에 담기지 않는다.
자료형 검사의 기준은 첫 번째 필드다
read_points_numpy는 모든 열이 같은 자료형이어야 2차원 배열을 만들 수 있다. 그래서 변환 전에 assert로 검사한다. Jazzy 5.3.8의 검사식은 다음과 같다(L150-L152).
assert all(cloud.fields[0].datatype == field.datatype
           for field in cloud.fields[1:]
           if field_names is None or field.name in field_names)
비교 대상은 고른 필드로 좁혀지지만, 기준은 언제나 fields[0]이다. 이 차이는 필드 순서에 따라 드러난다.
[x f32, y f32, z f32, intensity f32, ring u16]에서['x', 'y', 'z']를 고르면 기준 x와 y, z가 모두 float32라 통과한다.- 같은 레이아웃에서
field_names를 생략하거나['x', 'ring']을 고르면 uint16인 ring 때문에 실패한다. [ring u16, x f32, y f32, z f32]처럼 첫 필드가 uint16이면, x, y, z만 골라도 기준 ring과 비교되어 실패한다. 고른 필드는 모두 float32인데도 그렇다.
실패하면 AssertionError: All fields need to have the same datatype. Useread_points()otherwise.가 난다. 세 번째 경우에는 메시지 안내대로 read_points로 구조화 배열을 받은 뒤 직접 펴면 된다.
from numpy.lib import recfunctions as rfn

xyz = rfn.structured_to_unstructured(pc2.read_points(cloud, field_names=["x", "y", "z"]))
field_names로 비교 범위를 좁히는 조건은 2023년 5월 커밋 10880a5로 들어왔다. Humble 4.9.2의 검사식에는 이 조건이 없어서 field_names와 관계없이 클라우드의 모든 필드가 같은 자료형이어야 한다. 소스대로라면 Humble에서는 첫 번째 레이아웃도 ring 때문에 실패하므로, Humble 사용자는 처음부터 read_points + structured_to_unstructured 경로를 쓰는 편이 낫다. Humble은 소스만 읽었고 실행하지는 않았다.
검사가 assert라는 점도 기억해 둘 만하다. python3 -O로 실행하면 assert가 사라져 이 검사도 함께 빠진다. ros2 run 같은 일반 실행에서는 해당하지 않는다.
행 끝 패딩, reshape, uvs는 평탄 인덱스 기준으로 움직인다
나머지 세 동작은 같은 뿌리에서 나온다. read_points는 클라우드를 길이 width*height의 한 줄짜리 배열(평탄 배열)로 본다.
- 행 끝 패딩: 앞에서 본 대로
row_step을 쓰지 않는다.data가width*height*point_step보다 길면 오류 없이 밀린 위치를 읽고, 짧으면 NumPy가 “buffer is too small” TypeError를 낸다. reshape_organized_cloud=True:points.reshape(cloud.width, cloud.height)를 호출한다(L120-L121). 메시지는height행 ×width열이므로 이미지 모양은(height, width)여야 한다. reshape는 점의 순서를 그대로 둔 채 모양만 바꾸므로 축을 맞바꾸는 전치(transpose)와 다르고, 그래서(width, height)결과의 한 “행”은 이미지의 한 행이 아니다. 이 문제는 이슈 #236에서 2026년 10월 13일 현재 열려 있고, 메인테이너가 “seems transposed”라고 답했다. 버그로 확정되거나 수정된 상태는 아니다.uvs: NaN을 걸러낸 뒤에points[uvs]로 고른다(L112-L117).skip_nans와 함께 쓰면 앞쪽 NaN 점 개수만큼 인덱스가 밀린다.
이미지 모양이 필요하면 NaN을 빼기 전의 평탄 결과를 직접 자르는 것이 메시지 정의와 맞는다.
grid = pc2.read_points_numpy(cloud, field_names=["x", "y", "z"]).reshape(cloud.height, cloud.width, 3)
Jazzy 컨테이너에서 예측과 실측을 나란히 놓았다
위 내용은 모두 소스를 읽고 세운 예측이다. 실측은 같은 프로세스 안의 rclpy 노드가 합성 클라우드를 publish하고 subscribe 콜백으로 한 번 받은 뒤, 받은 메시지로 했다. 노드 사이 전달은 ROS 2의 통신 계층 구현인 RMW(ROS Middleware)가 맡으며, 이번에는 기본값인 Fast DDS 기반 rmw_fastrtps_cpp를 썼다. 640×480 클라우드에는 시드를 고정해 고른 40000개 점의 x, y, z 중 한 칸에 NaN을 넣었다. create_cloud는 항상 is_dense=False로 메시지를 만들기 때문에 쓰지 않고 메시지 필드를 직접 채웠다.
측정 환경: ros:jazzy-ros-base 이미지(digest 고정, 아래 명령 참고), Python 3.12.3, sensor_msgs_py 5.3.8, numpy 1.26.4, rclpy 7.1.12-1noble.20260902.053513, RMW rmw_fastrtps_cpp(기본값), 리틀엔디언, 네트워크 차단, 1 CPU·1 GiB 제한. 같은 스크립트를 5회 실행했고 5회 모두 종료 코드 0이었으며, 실행 시간 줄을 뺀 측정값은 5회 모두 같았다.
| 항목 | 소스 기반 예측 | 실측 |
|---|---|---|
받은 메시지의 점 개수·data 길이 |
307200개, 4915200바이트 | 307200개, 4915200바이트, row_step 10240 |
| 인덱스 1000 점의 z 시작 위치 | 16008바이트(행 1, 열 360) | 16008바이트, struct로 읽은 값과 read_points_numpy 값 일치 |
| 전체 점의 z 비교 | 불일치 0 | 307200개 비교, 불일치 0 |
| xyz 배열 | (307200, 3) float32, 3686400바이트 |
(307200, 3) float32, 3686400바이트 |
skip_nans=True, is_dense=False |
267200행, NaN 행 0 | 267200행, NaN 행 0 |
skip_nans=True, is_dense=True(같은 데이터) |
307200행, NaN 행 40000 | 307200행, NaN 행 40000 |
np.isfinite 마스크 |
267200행 | 267200행 |
[x, y, z, intensity, ring] + ['x', 'y', 'z'] |
통과 | 통과, (16, 3) float32 |
같은 레이아웃 + 전체 필드 / ['x', 'ring'] |
AssertionError | 둘 다 AssertionError |
[ring, x, y, z] + ['x', 'y', 'z'] |
AssertionError, read_points 경로는 (16, 3) |
AssertionError, read_points 경로는 (16, 3) float32 |
| 라이다식 point_step 32, 10번 점 ring | 336바이트에서 시작 | 336바이트, struct 값 102 = read_points 값 102 |
inf 행 2개 + NaN 행 1개인 5점, skip_nans=True |
4행 남음(inf 2행 잔존), 마스크는 2행 | 4행, inf 행 2, 마스크 2행 |
2행 × 3열, reshape_organized_cloud=True |
shape (3, 2) |
shape (3, 2), 이미지 두 행에 걸친 “행” 1개 / 직접 reshape(height, width, 3)은 0개 |
NaN 있는 정렬 클라우드 + skip_nans + reshape |
ValueError | ValueError |
점 0이 NaN, uvs=[0] |
skip_nans=True면 원래 점 1, False면 점 0 |
원래 점 1 / 점 0 |
row_step 56(행 끝 8바이트 패딩) |
두 번째 행 첫 점 x가 10이 아니게 읽힘 | 실제 10.0, 읽힌 값 0.0(48바이트 위치를 읽음, 실제는 56바이트) |
data가 16바이트 짧음(80 < 96) |
TypeError | TypeError |
1회차 원본 출력에서 판단에 쓴 다섯 줄을 고쳐 쓰지 않고 그대로 옮겼다.
{"measure": "byte_position", "probes": [{"index": 0, "z_byte_start": 8, "row": 0, "col": 0, "z_struct": 1.0, "z_read_points_numpy": 1.0, "equal": true}, {"index": 1000, "z_byte_start": 16008, "row": 1, "col": 360, "z_struct": 1.0299999713897705, "z_read_points_numpy": 1.0299999713897705, "equal": true}, {"index": 307199, "z_byte_start": 4915192, "row": 479, "col": 639, "z_struct": 1.0, "z_read_points_numpy": 1.0, "equal": true}], "all_points_compared": 307200, "z_mismatches": 0, "xyz_array_shape": [307200, 3], "xyz_array_dtype": "float32", "xyz_array_nbytes": 3686400}
{"measure": "skip_nans_vs_is_dense", "input_rows": 307200, "input_rows_with_nan": 40000, "is_dense_false": {"rows": 267200, "rows_with_nan": 0}, "is_dense_true": {"rows": 307200, "rows_with_nan": 40000}, "manual_isfinite_rows": 267200}
{"measure": "type_check_C_first_u16_select_xyz", "read_points_numpy": {"ok": false, "error": "AssertionError", "message": "All fields need to have the same datatype. Use `read_points()` otherwise."}, "read_points_plus_structured_to_unstructured": {"ok": true, "shape": [16, 3], "dtype": "float32"}}
{"measure": "reshape_organized", "height": 2, "width": 3, "shape": [3, 2], "rows_col_row": [[[0, 0], [1, 0]], [[2, 0], [0, 1]], [[1, 1], [2, 1]]], "rows_spanning_two_image_rows": 1, "manual_reshape_shape": [2, 3, 3], "manual_rows_spanning_two_image_rows": 0}
{"measure": "row_step_padding", "width": 3, "height": 2, "point_step": 16, "row_step": 56, "data_len": 112, "width_x_height_x_step": 96, "row1_col0_true_x": 10.0, "row1_col0_read_points_numpy_x": 0.0, "row1_col0_byte_by_row_step": 56, "row1_col0_byte_assumed": 48, "rows_mismatched": 1}
재현 스크립트와 5회 실행별 원본 출력은 실험 디렉터리에 있다. 스크립트는 experiment.py, 결과는 results.json이다. Docker만 있으면 Python이나 ROS를 따로 설치하지 않고 아래 두 줄로 같은 조건을 재현할 수 있다. 이미지는 움직이는 태그 대신 실측에 쓴 digest(이미지 내용을 가리키는 고정 해시)로 지정했다. 처음 한 번은 이미지를 내려받느라 호스트 네트워크가 필요하고, 컨테이너 안은 네트워크가 차단된다.
curl -fsSLO https://raw.githubusercontent.com/sungpyo9053/blog/main/experiments/ros2-python-pointcloud2-to-xyz-array-read-points-numpy/experiment.py
docker run --rm --network none --cpus 1 --memory 1g -v "$PWD":/work ros@sha256:066420e07f60aa18262f2479981def87ebcfcec42eefb0c0c57c4a46098348ca bash -c "source /opt/ros/jazzy/setup.bash && python3 /work/experiment.py"
정상이라면 종료 코드 0과 함께 {"measure": ...} 형태의 JSON 17줄이 출력되고, roundtrip·done 줄의 시간 값을 빼면 위 표와 같아야 한다. roundtrip 줄의 "received": false는 publish한 메시지를 받지 못했다는 뜻이고, 이때 스크립트는 종료 코드 1로 끝난다.
예측과 다른 항목은 없었다. 틀린 결과가 드러나는 방식은 항목마다 다르다. is_dense를 True로 바꾸자 같은 데이터에서 NaN 행 40000개가 그대로 남았고, 이때 예외나 경고는 없었다. row_step 패딩도 오류 없이 0.0을 돌려줬다. 반면 자료형 불일치와 짧은 data는 예외로 바로 드러난다. 조용히 틀리는 쪽이 is_dense와 row_step이니, 받은 메시지에서 먼저 확인할 값도 이 둘이다.
reshape 항목에는 실험 스크립트를 처음 시험 실행할 때의 교훈이 하나 있다. 처음에는 “결과의 첫 행이 이미지 한 행인가”를 지표로 썼는데 true가 나왔다. 2행 × 3열에서 (3, 2) 결과의 첫 “행”은 점 0, 1이고, 둘 다 우연히 이미지 0행에 있었기 때문이다. 첫 행만 보면 축 순서 문제가 보이지 않는다. 그래서 모든 “행”이 이미지 두 행에 걸치는지 세도록 바꿨고, 그 값이 표의 1이다. 자기 코드에서 reshape 결과를 점검할 때도 첫 행만 보고 판단하면 같은 함정에 빠질 수 있다.
이 실측은 합성 메시지로 함수의 동작을 확인한 것이다. 실제 깊이 카메라나 라이다 드라이버가 is_dense, 필드 순서, row_step을 어떻게 채우는지는 보여 주지 않는다. 처리 시간도 기록됐지만 실행 확인용이며 성능 근거로 쓰지 않았다.
계산해 보고 답을 확인할 세 가지
1. 라이다식 레이아웃을 가정한다. point_step은 32, 필드는 x, y, z, intensity(float32, offset 0, 4, 8, 12)와 ring(uint16, offset 16)이다. 10번 점의 ring은 몇 바이트에서 시작할까?
답은 10 × 32 + 16 = 336이다. 점 시작이 i × point_step, 필드는 거기서 offset만큼 더 간다. 실측에서도 336바이트를 struct로 읽은 값과 read_points가 돌려준 ring 값이 같았다.
2. 같은 클라우드에서 read_points_numpy(cloud, field_names=['x', 'y', 'z'])는 Jazzy와 Humble에서 각각 통과할까?
Jazzy는 통과한다. 기준인 fields[0]이 float32인 x이고 고른 y, z도 float32다. Humble 4.9.2는 소스상 실패한다. field_names와 관계없이 모든 필드를 x와 비교하므로 uint16인 ring에서 걸린다.
3. 640×480 클라우드에 NaN 점이 40000개 있는데 송신 측이 is_dense=True로 보냈다. skip_nans=True의 결과는 몇 행일까?
307200행이다. is_dense=True이면 NaN 필터가 실행되지 않아 40000행이 그대로 남는다. 267200이라고 답했다면 is_dense=False일 때의 답을 쓴 것이다.
받은 메시지에서 먼저 출력할 것과 고를 경로
새 센서를 붙이면 콜백에서 레이아웃을 한 번 출력해 둔다. 두 줄이면 되고, 위에서 조용히 틀리던 두 경우를 여기서 미리 걸러 낼 수 있다.
print(msg.height, msg.width, msg.point_step, msg.row_step, msg.is_dense, len(msg.data))
print([(f.name, f.offset, f.datatype, f.count) for f in msg.fields])
이 출력으로 다음 순서대로 판단한다.
row_step == width * point_step인지 본다. 다르면read_points계열 함수가 두 번째 행부터 틀린 위치를 읽으므로, 결과를 그대로 쓰지 말고 행 단위로 직접 잘라야 한다.- Jazzy이고
fields[0]의 자료형이 고를 필드와 같으면read_points_numpy(msg, field_names=['x', 'y', 'z'])를 쓴다. Humble이거나 첫 필드가 다른 자료형이면structured_to_unstructured(read_points(msg, field_names=['x', 'y', 'z']))로 간다. is_dense=False라면skip_nans=True로 NaN이 빠진다.is_dense=True인데 NaN이 의심되거나 inf까지 빼야 하면skip_nans대신np.isfinite마스크를 건다.- 픽셀 위치나 이미지 모양이 필요하면
skip_nans,uvs,reshape_organized_cloud를 쓰지 않는다. NaN을 빼기 전의 평탄 결과를reshape(height, width, 3)하고, 유효 여부는 마스크로 따로 들고 다닌다.
별도 패키지인 Box-Robotics의 ros2_numpy는 코드상 is_dense와 관계없이 np.isfinite로 거르고 (height, width)로 reshape한다. 다만 ros-base 이미지에 기본으로 들어 있지 않고 기본 출력이 float64이며, row_step을 쓰지 않는 점은 같다. 이 패키지는 코드만 읽었고 실행하지 않았다. 표준 sensor_msgs_py만으로 위 네 단계를 지킬 수 있다면 의존성을 하나 더 늘릴 이유는 크지 않다.
드라이버가 패딩을 쓰는지, is_dense를 정확히 채우는지는 위 두 줄 출력으로 장치마다 확인해야 한다. 이슈 #236에 수정이 들어가면 reshape_organized_cloud의 축 순서도 바뀔 수 있으니, 배포판을 올린 뒤 이 옵션을 쓰는 코드가 있다면 결과 모양을 다시 확인한다. 이 글은 센서 데이터를 배열로 해석하는 데서 멈추며 로봇 구동기를 움직이지 않는다.
확인한 소스와 버전
모두 2026년 10월 13일에 확인했다.
- sensor_msgs_py/point_cloud2.py, Jazzy 5.3.8(커밋 a941f14):
read_points,read_points_numpy,dtype_from_fields의 동작. 로컬ros:jazzy-ros-base이미지에 설치된ros-jazzy-sensor-msgs-py5.3.8의 같은 파일과 SHA-256이 같다. - docs.ros.org sensor_msgs_py.point_cloud2 API(Jazzy):
skip_nans설명에is_dense조건이 없다. - PointCloud2.msg, PointField.msg: 필드 정의와
is_dense주석. - sensor_msgs_py/point_cloud2.py, Humble 4.9.2, ROS 1 Noetic point_cloud2.py: 배포판별 차이 대조용, 소스 판독만.
- 커밋 10880a5, 이슈 #236: 자료형 검사 변경 이력과 reshape 축 순서 논의.
받은 메시지의 레이아웃을 출력한 뒤 experiment.py를 같은 Jazzy 이미지에서 돌려 보면, 자기 센서의 값과 합성 메시지의 동작을 나란히 비교할 수 있다. 이 글에는 제휴·협찬이 없다.