로봇 관절 속도를 가우시안 정책으로 뽑으면 왜 행동 범위를 넘을까: 경계까지의 여유를 표준편차로 재기
Stable-Baselines3(SB3)에서 PPO와 A2C가 경험을 모으는 코드에는 이런 주석이 붙어 있다. “clip the actions to avoid out of bound error as we are sampling from an unbounded Gaussian distribution.” 경계가 없는 가우시안 분포에서 행동을 뽑으니, 환경에 넘기기 전에 잘라 둔다는 뜻이다. 로봇 관절 속도를 가우시안 정책으로 뽑으면 왜 행동 범위를 넘을까. 정책이 낸 평균이 범위 안에 있어도 평균에서 경계까지 남은 거리를 표준편차 단위로 잰 값이 작으면, 흔한 크기의 노이즈로도 샘플이 경계를 넘기 때문이다.
아래에서는 관절 속도 범위가 −1~+1 rad/s인 2관절 팔을 설명용으로 가정하고 평균, 표준편차, 노이즈로 샘플을 직접 계산한다. 계산을 따라가면 관절마다 (상한 − 평균) / 표준편차를 구해 노이즈가 얼마를 넘을 때 범위를 벗어나는지 말할 수 있고, 쓰는 라이브러리가 넘은 행동을 어디서 처리하는지 찾아볼 위치도 알게 된다. 사칙연산과 평균·표준편차의 뜻만 알면 되고 신경망 지식은 필요 없다. 관측·행동·정책이라는 말부터 낯설다면 관측·행동·피드백을 숫자로 이해하는 글을 먼저 보면 된다. 수치는 모두 Python 표준 라이브러리로 검산한 산술이며, 로봇이나 물리 엔진, 정책 학습을 실행한 결과가 아니다.
정책은 관절마다 평균과 표준편차를 내고 노이즈를 곱해 더한다
행동 공간(action space)은 환경이 받아들이는 유효한 행동 전체의 집합이다. Gymnasium 문서는 action_space를 유효한 행동에 대응하는 Space로 정의하고 모든 유효한 행동이 그 안에 있어야 한다고 적는다. 행동이 실수 벡터이면 연속 행동 공간(continuous action space)이라 하며, Spinning Up은 물리 세계의 로봇을 제어하는 경우를 그 예로 든다. 여기서는 행동 벡터의 원소 하나가 관절 하나의 속도 명령이다.
확률적 정책(stochastic policy)은 같은 관측을 받아도 매번 분포에서 행동을 뽑는다. 그중 대각 가우시안 정책(diagonal Gaussian policy)은 관절마다 서로 독립인 정규분포를 하나씩 둔다. 신경망이 관측으로부터 관절별 평균 행동 μ(mean action)를 계산하고 표준편차는 로그 표준편차 log σ로 들고 있다가 σ = exp(log σ)로 바꿔 쓴다. 이 글의 예제는 지수 단계를 건너뛰고 σ를 바로 준다.
샘플은 다음 식으로 만든다(Spinning Up rl_intro L188–L194).
a = μ + σ ⊙ z, z ~ N(0, I)
z는 평균 0, 표준편차 1인 표준정규분포에서 뽑은 노이즈다. ⊙는 원소곱(elementwise product), 즉 같은 위치끼리 곱한다는 기호다. 관절 i마다 a_i = μ_i + σ_i × z_i를 따로 계산하면 된다.
숫자를 넣어 본다. 관절 1은 μ=0.5, σ=0.25이고 z=1.5가 뽑혔다. 0.5 + 0.25 × 1.5 = 0.875 rad/s다. 관절 2는 μ=−0.25, σ=0.125이고 z=−2가 뽑혔다. −0.25 + 0.125 × (−2) = −0.5 rad/s다. 관절 2의 z가 절댓값으로 더 크지만 평균에서 벗어난 거리는 0.25 rad/s로, 관절 1의 0.375 rad/s보다 작다. 관절마다 자기 σ를 곱한다는 원소곱의 의미가 여기서 드러난다.
평균을 다트를 겨누는 지점, σ를 손이 떨리는 정도, z를 이번 던지기의 떨림 크기로 떠올리면 식이 쉽게 읽힌다. 다만 이 비유는 한 군데서 어긋난다. 사람 손의 떨림에는 물리적 한계가 있지만 정규분포의 z에는 상한도 하한도 없다. 큰 z는 드물 뿐 나올 수 없는 값이 아니고, 이 차이가 처음 질문의 답으로 이어진다.
평균 0.875 rad/s에서 z=1이 뽑히면 1.125 rad/s가 된다
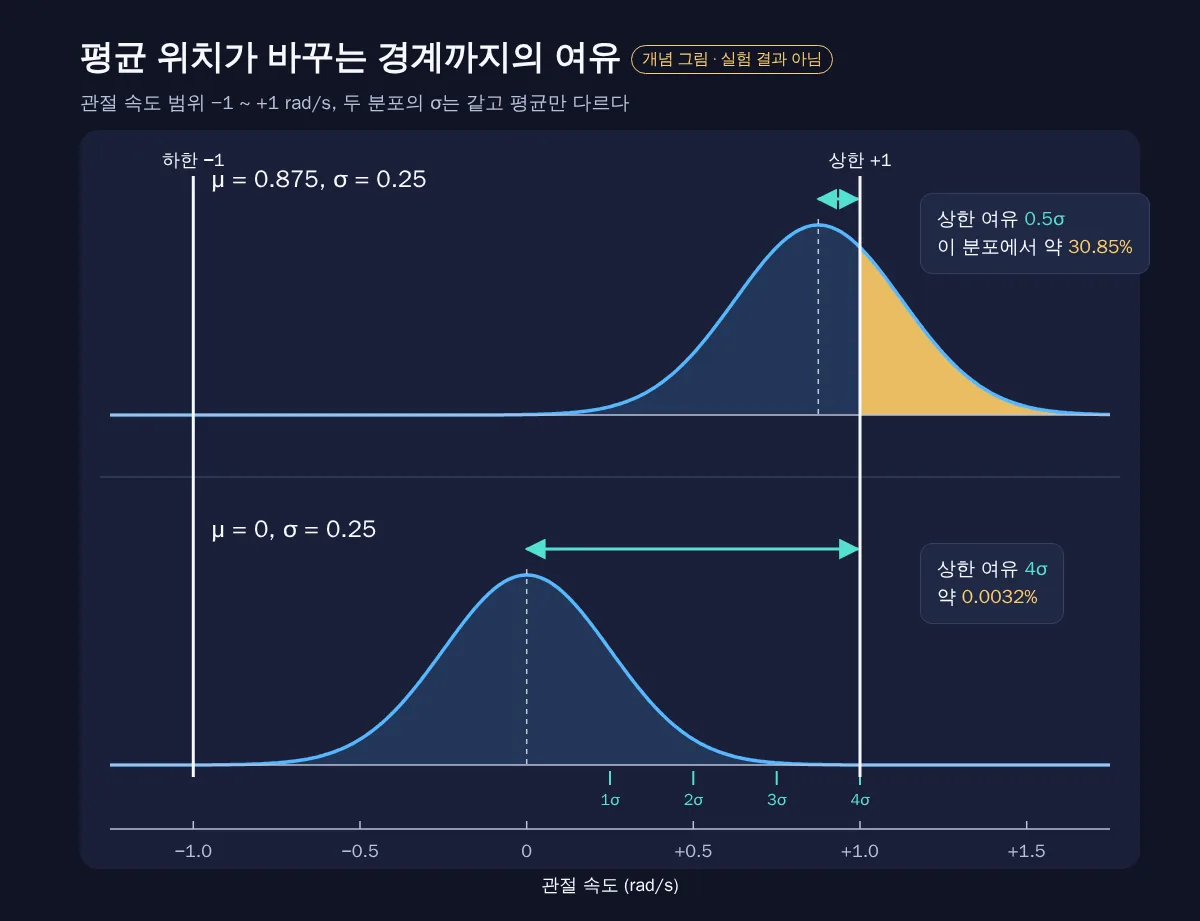
관절 1의 평균을 경계 가까이 옮겨 μ=0.875, σ=0.25로 둔다. z=1이 뽑히면 0.875 + 0.25 × 1 = 1.125 rad/s다. 평균은 범위 안인데 샘플은 상한 1 rad/s를 넘었다. z=1은 평균에서 표준편차 하나 떨어진 값으로, 표준정규분포에서 특별히 큰 수가 아니다.
SB3 공식 문서는 이 성질을 직접 적는다. “Another consequence of using a Gaussian distribution is that the action range is not bounded.” 그래서 유효 구간에 머물게 하려고 자르기(clipping)를 “임시방편(bandage)”으로 흔히 쓰며 더 나은 해법으로 SAC 방식의 눌러 담기(squashing) 함수나 Beta 분포를 든다. 같은 문서는 DDPG와 TD3에는 이 설명이 맞지 않는다고 따로 밝힌다. 두 알고리즘은 확률 분포에서 행동을 뽑지 않기 때문이다. 이 글의 계산도 가우시안에서 샘플하는 확률적 정책에만 해당한다.
경계까지 표준편차 몇 개가 남았는지가 넘는 z를 정한다
샘플 식을 부등식에 넣고 σ_i > 0으로 양변을 나누면 초과 조건이 z 하나의 비교로 바뀐다.
a_i > high_i  ⇔  z_i > (high_i − μ_i) / σ_i
a_i < low_i   ⇔  z_i < −(μ_i − low_i) / σ_i
이 글에서는 (high − μ) / σ를 상한 여유, (μ − low) / σ를 하한 여유라고 부른다. 분자와 분모의 rad/s가 지워지므로 여유는 단위가 없는 수이고, 뜻은 “경계까지 표준편차 몇 개”다. 계산은 통계의 z-점수와 같으며 ‘여유’는 설명을 위해 붙인 이름일 뿐 업계 표준 지표명이 아니다.
앞의 설정에 대입하면 다음과 같다.
- μ=0.875, σ=0.25: 상한 여유 (1 − 0.875) / 0.25 = 0.5. z가 0.5만 넘어도 상한을 넘는다. 하한 여유는 (0.875 + 1) / 0.25 = 7.5로 멀다. 경계에 붙은 관절은 한쪽만 위험하다.
- μ=0, σ=0.25: 상한 여유 1 / 0.25 = 4. z가 4를 넘어야 상한을 넘는다.
- μ=0.875, σ=0.0625: 상한 여유 0.125 / 0.0625 = 2. σ를 4분의 1로 줄이자 여유가 4배가 됐다.
- 관절 2(μ=−0.25, σ=0.125): 하한 여유 (−0.25 + 1) / 0.125 = 6.
여유가 얼마나 작아야 자주 넘는지 감을 잡기 위해, Research 단계에서 Python statistics.NormalDist의 cdf로 z가 여유보다 클 한쪽 꼬리 확률을 계산했다. μ와 σ가 고정된 이 설명용 분포에서의 값이며, 관측에 따라 μ(구현에 따라서는 σ도)가 달라지는 실제 정책의 초과 빈도가 아니다.
| 여유 | 해당 설정 | z가 여유를 넘을 확률 |
|---|---|---|
| 0.5 | μ=0.875, σ=0.25 (상한) | 약 30.85% |
| 2 | μ=0.875, σ=0.0625 (상한) | 약 2.28% |
| 4 | μ=0, σ=0.25 (상한) | 약 0.0032% |
| 6 | 관절 2 (하한) | 약 9.87×10⁻¹⁰ |
여유 0.5에서는 대략 세 번에 한 번꼴로 상한을 넘는다. 같은 분포를 고정 seed 20260925로 20만 번 뽑은 몬테카를로 계산에서는 30.717%가 나와 계산값과 가까웠다. seed 하나로 한 번 돌린 결과라 표본오차 수준의 차이는 남는다.
σ를 줄이면 여유가 커지지만 z에 상한이 없으므로 넘을 가능성이 0이 되지는 않는다. σ는 정책이 행동을 얼마나 넓게 뽑는지를 정하는 값이기도 해서, σ를 줄이는 일은 초과 방지 장치를 다는 것이 아니라 샘플 분포 자체를 바꾸는 선택이다. 그 선택이 학습에 유리한지는 이 계산으로 알 수 없다.
같은 1.125 rad/s라도 평균에 따라 필요한 z가 다르다
샘플 식을 거꾸로 풀면 z = (a − μ) / σ다. 로그에 1.125 rad/s가 찍혔고 σ=0.25였다고 할 때, 그 값을 만든 z는 평균에 따라 달라진다.
- μ=0.875라면 z = 0.25 / 0.25 = 1
- μ=0.5라면 z = 0.625 / 0.25 = 2.5
- μ=0이라면 z = 1.125 / 0.25 = 4.5
같은 샘플이어도 경계에 붙은 평균에서는 흔한 노이즈로 나온 값이고, 중앙 평균에서는 드문 노이즈가 있어야 나오는 값이다. 그래서 범위를 넘은 샘플 하나만 보고는 정책이 경계 쪽으로 쏠렸는지, 드문 노이즈가 한 번 나왔는지 구분할 수 없다. 앞의 경우는 계속 반복되고 뒤의 경우는 드물게 나타난다. 둘을 가르는 값은 샘플이 아니라 그 순간의 μ와 σ가 만든 여유다.
로그우도의 (a − μ)² / σ²는 뽑힌 z의 제곱이다
로그우도(log-likelihood)는 어떤 행동이 이 분포에서 나올 가능성을 로그로 나타낸 값이다. 정책을 학습시키는 쪽은 이 값을 학습 신호 계산에 쓴다. 대각 가우시안 정책에서는 다음 식으로 구한다(Spinning Up rl_intro L196–L200). k는 행동 차원 수, 여기서는 관절 수다.
log π(a|s) = −½ ( Σ_i [ (a_i − μ_i)² / σ_i² + 2 log σ_i ] + k log 2π )
샘플 식에서 (a_i − μ_i) / σ_i = z_i이므로 괄호 안의 첫 항은 뽑힌 z들의 제곱합이다. 관절 1(z=1.5)과 관절 2(z=−2)의 샘플이라면 1.5² + (−2)² = 2.25 + 4 = 6.25다. 나머지 항은 σ와 k에만 달려 있으므로, σ가 같다면 큰 노이즈로 뽑힌 행동일수록 로그우도가 작다. 이 두 관절 예제의 전체 로그우도는 −1.497141로, 식으로 계산한 값과 NormalDist(μ, σ).pdf의 로그를 더한 값이 일치했다.
여유 계산에 쓴 z와 로그우도에 들어가는 z는 같은 수다. 그렇다면 샘플이 1.125 rad/s로 범위를 넘어 잘렸을 때, 학습은 1.125와 1.0 중 어느 값의 z를 보게 될까.
환경은 자른 값을, 학습 버퍼는 자르기 전 값을 받는다
라이브러리 코드를 읽기 전에 용어 세 개를 정리한다. 롤아웃(rollout)은 정책을 환경에서 실행하며 차례로 모은 상태·행동의 기록이다. Spinning Up은 상태와 행동이 이어진 궤적(trajectory)을 에피소드(episode)나 롤아웃이라고도 부른다고 적는다(rl_intro L245–L247). 온폴리시(on-policy)는 매 업데이트에 가장 최근 정책으로 행동하며 모은 데이터만 쓰는 학습 방식이고(rl_intro2 L53), 오프폴리시(off-policy)는 학습 중 어느 시점에 모은 데이터든 업데이트에 다시 쓸 수 있는 방식이다(rl_intro2 L60). Spinning Up은 PPO를 온폴리시로(ppo.rst L29), SAC를 오프폴리시로(sac.rst L23) 분류한다.
SB3에서 PPO와 A2C는 OnPolicyAlgorithm 클래스를 상속하고, 이 클래스의 collect_rollouts가 현재 정책으로 롤아웃을 모아 버퍼를 채운다. 이 온폴리시 경로를 고정 커밋 7cfb4dd의 on_policy_algorithm.py L205–L218과 L247–L254에서 읽으면 값의 흐름은 다음과 같다. 아래는 코드가 아니라 흐름을 옮겨 적은 것이다.
self.policy(obs_tensor)  →  actions, values, log_probs         자르기 전 샘플과 그 로그우도
actions  →  np.clip(actions, low, high)  →  clipped_actions  →  env.step(clipped_actions)
actions, log_probs  →  rollout_buffer.add(...)                  학습이 나중에 읽는 값
행동 공간이 Box이고 squash_output을 쓰지 않으면, 환경은 np.clip으로 자른 값을 실행하고 버퍼에는 자르기 전 actions와 그 log_probs가 저장된다. 앞의 예제로 옮기면 μ=0.875, σ=0.25, z=1에서 환경은 1.0 rad/s를 실행하고, 버퍼에는 1.125 rad/s와 z=1로 계산한 로그우도가 남는다. 보상은 잘린 행동으로 얻었는데 학습은 원래 샘플을 기준으로 계산한다. 이 코드는 2026년 9월 9일 master 커밋(version.txt 2.9.2a0, 알파)을 확인한 것이라 릴리스마다 달라질 수 있고, SAC·TD3 같은 오프폴리시 경로와 predict() 경로는 이번에 코드로 확인하지 않았다.
다른 구현도 같은 패턴을 쓴다. ICLR 2022 Blog Track의 PPO 구현 세부 해설은 openai/baselines가 범위를 넘을 수 있는 연속 행동을 잘라 환경에 넘기면서도 “the original unclipped action is stored as part of the episodic data”라고 설명한다. Fujita와 Maeda의 Clipped Action Policy Gradient(ICML 2018) 초록은 범위 밖 행동이 실행 전에 잘리는데도 정책은 잘리지 않은 것처럼 최적화되는 관행을 문제로 다룬다. 논문은 초록만 확인했으므로 이 차이가 학습 성능에 얼마나 영향을 주는지는 여기서 말하지 않는다.
라이브러리와 환경마다 처리 위치가 다르다는 점도 확인해야 한다.
- Gymnasium 환경 자체: API 문서는 유효한 행동이
action_space안에 있어야 한다고만 정한다. 범위 밖 행동을 받았을 때 자르는지, 오류를 내는지, 그대로 쓰는지는 환경 구현마다 다를 수 있다. - Gymnasium
ClipAction:step에 넘기기 전에 행동을 환경의action_space로 자르는 래퍼다. 문서 예시에서는 Hopper-v4에[5.0, -2.0, 0.0]을 넘기면 기본 환경에서[1.0, -1.0, 0]이 실행된다. 이 예시는 문서 인용이며 직접 실행하지 않았다. v1.0.0부터 이 래퍼의action_space는 무한 경계로 표시된다. - Gymnasium
RescaleAction: Box 행동 공간을 지정한[min_action, max_action]으로 선형 재조정한다. 범위를 넘는 것을 막는 장치가 아니라 스케일을 맞추는 장치다. SB3 문서가 행동을[-1, 1]로 재조정하라고 권하는 이유는 대부분의 알고리즘이 평균 0, 표준편차 1에서 시작하는 가우시안을 쓰기 때문이다. - SAC의 tanh 눌러 담기: Spinning Up은 SAC의 샘플을
ã = tanh(μ + σ ⊙ ξ),ξ ~ N(0, I)로 설명한다. tanh가 행동을 유한 범위 안에 두며 VPG·TRPO·PPO 정책에는 이 단계가 없고, tanh를 거친 뒤의 분포는 더 이상 가우시안이 아니다. 이 경우 여기서 계산한 여유는 tanh 이전 값에서의 거리일 뿐 실행되는 행동에서의 거리가 아니다. tanh 뒤의 로그우도 보정식은 SAC 논문 부록 원문을 확인하지 못해 다루지 않는다.
무작위 행동으로 환경을 점검하는 습관도 이 문제를 가린다. Gymnasium의 Box.sample()은 경계가 있는 구간에서 균등분포로 Box 안의 값을 만든다. env.action_space.sample()로 돌려 보면 범위 밖 행동이 나오지 않으므로, 가우시안 정책의 초과는 정책 샘플을 직접 기록해야 보인다.
SB3 문서는 squashing이나 Beta 분포를 더 나은 해법이라고 쓰고, ICLR 해설은 tanh가 더 낫다는 선행 보고를 전하면서도 일관성을 위해 clip을 택했다고 적는다. 선행 연구 원문은 확인하지 못했으므로 여기서는 clip과 tanh의 우열을 판정하지 않는다. 독자에게는 자신이 쓰는 경로가 어느 쪽인지 아는 일이 필요하다.
확인 문제: 여유를 먼저 구하고 z와 비교한다
문제 1. 상한 1 rad/s인 관절에서 μ=0.75, σ=0.125다. z=2.2가 뽑히면 범위를 넘을까?
상한 여유는 (1 − 0.75) / 0.125 = 2다. 2.2 > 2이므로 넘는다. 실제 샘플은 0.75 + 0.125 × 2.2 = 0.75 + 0.275 = 1.025 rad/s로, 여유 비교와 같은 결론이 나온다. 샘플을 계산하지 않고도 z와 여유의 비교만으로 판정할 수 있다는 점을 확인하는 문제다.
문제 2. 두 관절이 있다. 관절 A는 μ=0.875, σ=0.25이고, 관절 B는 μ=−0.25, σ=0.125다. 로그에서 먼저 지켜볼 관절은 어느 쪽인가?
관절 A다. A는 상한 여유 0.5, 하한 여유 7.5이므로 작은 쪽이 0.5다. B는 하한 여유가 6이고, 평균이 하한 쪽에 치우쳐 있으니 상한 여유는 그보다 크다. 관절마다 두 여유 중 작은 값을 비교하면 A가 훨씬 경계에 가깝다.
문제 3. 문제 1에서 σ만 절반인 0.0625로 줄이면 상한 여유는 어떻게 되고, 초과는 사라질까?
여유는 (1 − 0.75) / 0.0625 = 4로 두 배가 된다. z=2.2로는 더 이상 넘지 않는다. 하지만 z에는 상한이 없으므로 4보다 큰 z가 나오면 여전히 넘는다. 줄어드는 것은 초과 확률이지 초과 가능성 자체가 아니다.
롤아웃 로그에 남길 값과 이 계산이 닿지 않는 곳
직접 따라 계산하려면 example.py(고정 커밋 b4381ef)를 내려받는다. 이 파일에는 위의 샘플 계산, 여유, 역산한 z=2.5, 로그우도 이차항 6.25까지 9개 산술 사례가 assert로 묶여 있다. 외부 패키지는 필요 없다. 파일을 저장한 폴더에서 아래 명령을 실행해 종료 코드 0이 나오면 모든 사례가 기대값과 맞은 것이다. 이번 검산은 2026년 9월 25일 KST에 Python 3.12.3으로 했으며 다른 버전에서는 실행해 보지 않았다. 사례별 기대값·실제값과 가정·한계는 verification.json에 기록돼 있다. 꼬리 확률, 몬테카를로, μ=0에서의 z=4.5, 하한 여유 7.5는 Research 단계에서 따로 계산한 값이라 이 파일에는 들어 있지 않다.
python3 -I example.py
echo $?
자기 정책에 적용할 때는 다음 순서가 현실적이다.
- 롤아웃을 기록할 때 관절별 μ, σ와 함께
min((high − μ) / σ, (μ − low) / σ)를 남긴다. 샘플값만 남기면 앞에서 본 것처럼 반복되는 초과와 드문 초과를 구분할 수 없다. - 여유가 1 안팎인 관절이 반복되면 행동 처리 경로를 확인한다. SB3라면
collect_rollouts의 clip 분기와squash_output설정, Gymnasium이라면ClipAction래퍼 사용 여부, 직접 구현했다면env.step에 넘기는 값과 로그우도에 쓰는 값이 같은지 본다. - 환경의
action_space.low와high가 실제 관절 속도 단위와 같은지, 중간에 재조정이 들어갔는지 확인한다.[-1, 1]로 재조정된 공간에서 계산한 여유는 rad/s 범위의 여유와 같은 숫자가 아닐 수 있다.
이 계산이 말해 주지 않는 것도 있다. μ, σ, z와 ±1 rad/s는 모두 설명용 값이며 특정 로봇이나 Gymnasium 환경의 설정이 아니다. 정책이 실제로 얼마나 자주 경계 근처 평균을 내는지, clip이 학습 성능을 얼마나 바꾸는지는 측정하지 않았다. 실물 로봇이라면 소프트웨어의 clip이나 tanh는 정책 출력을 다듬는 단계일 뿐, 관절 속도 제한과 비상 정지는 제어기와 드라이버 쪽 안전장치가 따로 맡아야 한다. 이 글은 하드웨어 실행 절차를 다루지 않는다.
가우시안 정책을 쓰는 코드를 처음 읽고 있다면, 평균이 범위 안인지 확인하는 대신 관절마다 경계까지 표준편차 몇 개가 남았는지부터 계산한다. 그다음에는 사용하는 라이브러리가 범위 밖 행동을 자르는지 눌러 담는지 코드에서 확인한다. SB3라면 collect_rollouts의 clip 분기가 출발점이다. 버퍼에 무엇을 남기느냐가 학습 계산을 가르는 곳은 행동만이 아니다. 에피소드가 추락으로 끝났는지 시간 제한으로 끊겼는지를 버퍼에 구분해 남기는 문제는 추락과 시간 제한의 목표값 차이를 다룬 글에서 이어진다.
참고 링크
모든 자료의 확인일은 2026-09-25다.
- OpenAI Spinning Up — Key Concepts in RL, Diagonal Gaussian Policies (고정 커밋 2092113)
- OpenAI Spinning Up — Soft Actor-Critic, squashed Gaussian (고정 커밋 2092113)
- Gymnasium — Env API
- Gymnasium — Fundamental Spaces (Box)
- Gymnasium — Action Wrappers (ClipAction, RescaleAction)
- Stable-Baselines3 — Reinforcement Learning Tips and Tricks
- Stable-Baselines3 — on_policy_algorithm.py (고정 커밋 7cfb4dd)
- ICLR 2022 Blog Track — The 37 Implementation Details of Proximal Policy Optimization
- Fujita & Maeda — Clipped Action Policy Gradient, ICML 2018 (초록)
- Python 문서 — statistics.NormalDist
이 글에는 제휴·협찬이 없다.