RGB-D 카메라로 공의 X, Y, Z 좌표를 구하려면: CameraInfo의 K 행렬로 픽셀과 깊이를 미터 좌표로 되돌리기
컬러 영상에서 공을 찾았고 그 자리의 깊이 값도 읽었다. 그런데 로봇에게 넘겨야 하는 값은 미터 단위의 X, Y, Z다. Robotics Stack Exchange에 2015년에 올라온 한 질문(조회 5442회)이 바로 여기서 막혔다. 질문자는 로봇 시뮬레이터 Gazebo 속 Kinect의 컬러 영상에서 허프 변환(Hough transform, 원 같은 도형을 찾는 영상 처리 기법)으로 공의 픽셀 위치를 찾았다. Kinect는 컬러 영상과 픽셀마다의 깊이를 함께 내는 RGB-D 카메라(RGB-D camera)이고, 질문자는 같은 Kinect의 포인트 클라우드(point cloud, 3D 점들의 모음)도 갖고 있었다. 그런데도 픽셀을 미터로 바꿔 줄 “Kinect의 DPI”는 찾지 못했다. RGB-D 카메라로 공의 X, Y, Z 좌표를 구하려면 그런 고정 비율 대신 CameraInfo의 K 행렬로 픽셀과 깊이를 미터 좌표로 되돌려야 한다.
되돌리는 식 자체는 X = (u − cx)·Z/fx, Y = (v − cy)·Z/fy, Z = 깊이(m) 세 줄이다. 실수는 대개 그 앞뒤에서 난다. 배열에서 숫자를 꺼내는 위치, 깊이 영상의 단위, 깊이가 직선 거리인지 Z 성분인지, 그리고 결과를 검산하는 방법이다. 특히 “구한 점을 다시 투영해 원래 픽셀이 나오면 맞다”는 검산은 방향이 틀린 실수는 잡지만 거리의 크기가 틀린 실수는 그대로 통과시킨다. 이 점은 ROS 2 Jazzy 컨테이너에서 합성 깊이 영상으로 5회 실행해 확인했고, 실제 카메라·Gazebo·로봇은 쓰지 않았다. 제목의 K에는 단서도 하나 붙는다. K는 왜곡 보정 전 영상의 값이라, 보정된(rectified) 영상에서 찾은 픽셀이라면 같은 메시지의 P 행렬 값을 써야 한다. 비례식과 ROS 2의 토픽·메시지 개념만 알면 따라올 수 있다.
픽셀 하나가 몇 미터인지는 거리마다 다르다
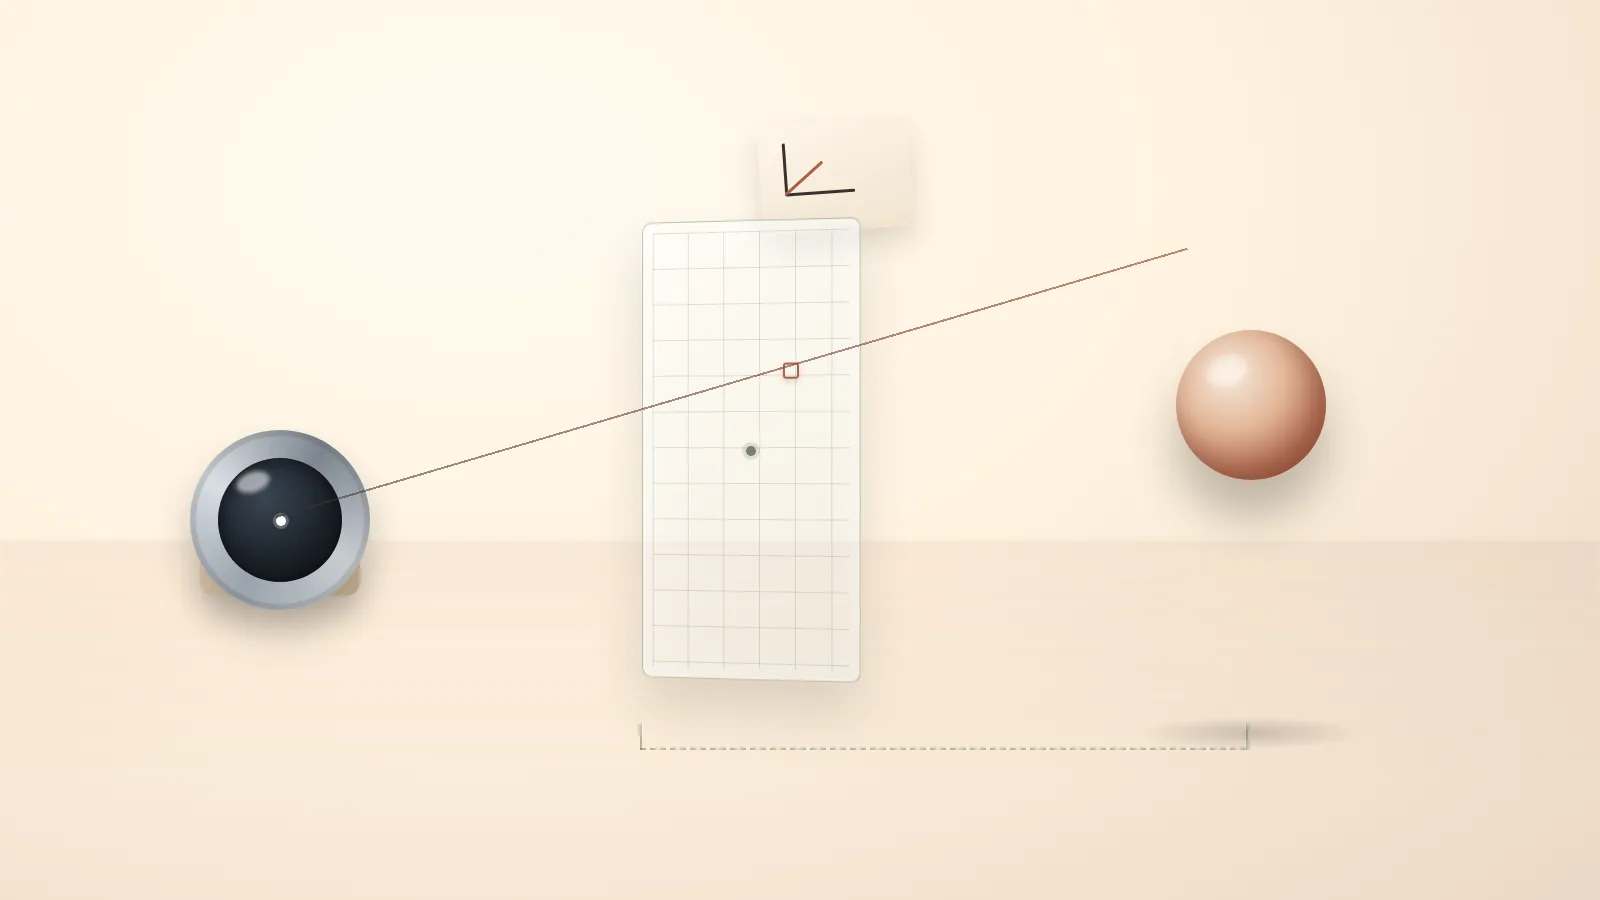
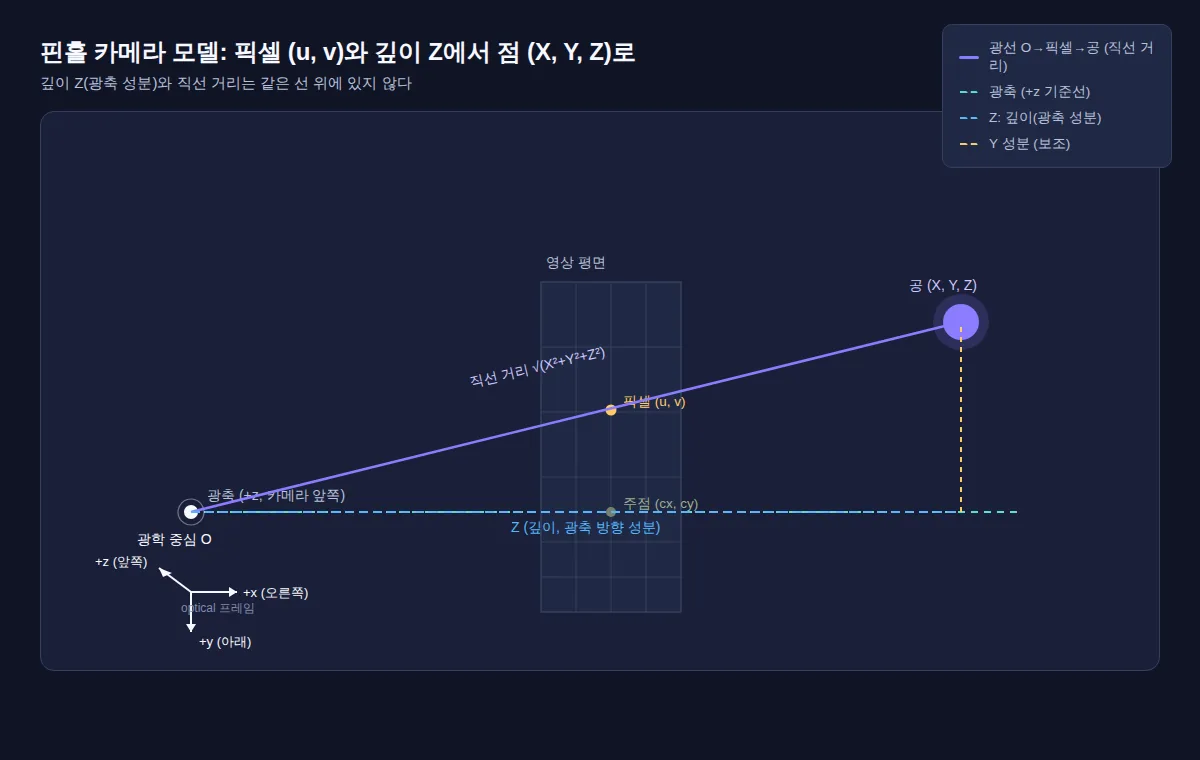
카메라 계산의 출발점은 핀홀 카메라 모델(pinhole camera model)이다. 바늘구멍 사진기처럼 모든 빛이 렌즈 중심 한 점을 지나 영상 평면에 맺힌다고 보는 단순화다. 이 모델에서 카메라 앞의 점 (X, Y, Z)는 다음 픽셀에 찍힌다.
u = fx · X / Z + cx
v = fy · Y / Z + cy
식에 나오는 네 숫자가 카메라마다 다른 값이다. 초점거리(focal length) fx, fy는 렌즈 중심에서 영상 평면까지의 거리를 픽셀 크기 단위로 나타낸 값으로, 미터 길이를 픽셀 수로 바꾸는 배율 역할을 한다. 주점(principal point) cx, cy는 렌즈의 광축이 영상과 만나는 픽셀 위치다. 영상 정중앙과 가깝지만 같다는 보장은 없다. 좌표 (X, Y, Z)는 카메라의 optical 프레임(광학 좌표계)을 기준으로 하며, 원점은 렌즈 광학 중심이고 +x는 영상 오른쪽, +y는 영상 아래, +z는 카메라 앞쪽이다(CameraInfo.msg L29–L35, REP-103 L102–L132).
투영식을 거꾸로 풀면 X = (u − cx)·Z/fx가 된다. Z가 분자에 있으니 “1픽셀 = 몇 미터”는 Z/fx이고, 거리에 따라 바뀐다. fx가 500 px인 카메라라면 X 방향 1픽셀은 1 m 거리에서 0.002 m, 2 m에서 0.004 m, 4 m에서 0.008 m에 해당한다. 멀리 있는 사람이 작게 보이는 것과 같은 원리인데, 이 비유는 크기 변화만 설명할 뿐 주점이 어디인지나 축이 어느 쪽인지는 알려 주지 않는다. 질문자가 찾던 DPI 같은 고정 비율이 카메라에 따로 존재하지 않는 이유다.
같은 이유로 Z를 모르면 X, Y도 정해지지 않는다. 컬러 영상의 픽셀 하나는 카메라에서 뻗어 나가는 광선 하나만 알려 주고, 그 광선 위 어디에 공이 있는지는 깊이가 정한다. REP-118도 일반 영상의 픽셀은 3D 광선으로만 투영되지만 깊이 영상은 보정 정보가 있으면 3D 점 구름으로 바꿀 수 있다고 설명한다(REP-118). 깊이 카메라가 필요한 이유가 여기에 있다.
CameraInfo에서 fx, fy, cx, cy를 꺼내는 자리
ROS 2에서는 이 네 값이 sensor_msgs/msg/CameraInfo 메시지의 k 필드에 들어 있다. 정의는 float64[9] k이고, 3×3 행렬 [fx 0 cx; 0 fy cy; 0 0 1]을 행 우선(row-major, 첫 줄부터 차례로 한 줄로 펼친) 순서로 담는다(CameraInfo.msg L66–L73). 펼치면 인덱스 0이 fx, 2가 cx, 4가 fy, 5가 cy다. 메시지 주석은 K[0] == 0.0이면 보정되지 않은 카메라로 간주해도 된다고 적어 두었다(L21–L23). 이 경우 아래 식은 쓸 수 없다.
같은 메시지의 p 필드는 3×4 행렬이라 인덱스가 다르다. fx는 P[0], cx는 P[2]로 같지만 fy는 P[5], cy는 P[6]이다. K의 인덱스 4, 5를 P에 그대로 쓰면 fy 자리에 P[4]의 0이 들어가 0으로 나누게 된다. 이 실수가 실제로 어떤 모습으로 나타나는지는 뒤의 실행 결과에서 본다.
K와 P 중 어느 쪽을 쓸지는 픽셀을 어느 영상에서 얻었는지로 정한다. CameraInfo 정의에서 K는 왜곡된 원본(raw) 영상의 내부 행렬이고, P의 왼쪽 3×3은 왜곡을 펴고 정렬한 rectified 영상의 내부 행렬이며 그 값은 K와 다를 수 있다(L41–L50, L81–L105). ROS의 표준 도구도 P 쪽을 쓴다. image_geometry의 PinholeCameraModel은 fx(), cx()를 P에서 읽고(cameramodels.py L262–L291), 깊이 영상을 점 구름으로 바꾸는 depth_image_proc도 그 값으로 (u − cx)·depth/fx를 계산한다(conversions.hpp L55–L94). 판단 기준은 세 가지다.
image_rect계열처럼 이미 보정된 영상에서 찾은 픽셀이면 P[0], P[2], P[5], P[6]을 쓴다.image_raw같은 원본 영상의 픽셀이고 왜곡이 무시할 수준이 아니면, 먼저 왜곡을 보정하거나 보정된 영상에서 픽셀을 다시 찾는다.- 왜곡 계수가 0인 단안(렌즈 하나짜리) 카메라는 메시지 주석대로 보통 P의 왼쪽 3×3이 K와 같아서 어느 쪽을 써도 결과가 같다.
CameraInfo의 width, height는 보정할 때의 영상 크기다. 실제로 받은 영상의 해상도가 이와 다르면 K를 그대로 쓰면 안 된다.
뒤의 실험 스크립트는 메시지에서 숫자를 꺼내 계산하는 부분을 다음 함수로 썼다. intrinsics_from_k는 (fx, fy, cx, cy) 순서로 돌려준다.
k, p = [float(c) for c in info.k], [float(c) for c in info.p]


def intrinsics_from_k(k):
    if k[0] == 0.0:
        raise ValueError("uncalibrated camera: K[0] == 0")
    return k[0], k[4], k[2], k[5]


def back_project(u, v, z, fx, fy, cx, cy):
    return (u - cx) * z / fx, (v - cy) * z / fy, z


def reproject(x, y, z, fx, fy, cx, cy):
    return fx * x / z + cx, fy * y / z + cy
back_project가 역투영(back-projection, 픽셀과 깊이에서 3D 점을 되찾는 계산)이고, reproject는 그 점을 다시 픽셀로 보내 원래 위치가 나오는지 보는 재투영(reprojection)이다. 첫 줄에서 float()로 바꾸는 이유도 뒤에서 드러난다.
공 하나로 손계산해 보기
설명용 카메라를 하나 정하자. 640×480 영상, fx = fy = 500 px, cx = 320 px, cy = 240 px, 렌즈 왜곡 없음. 특정 카메라에서 잰 값이 아니라 계산을 따라가기 쉽게 고른 숫자다. 공의 중심이 픽셀 (u, v) = (420, 190)에 있고 그 픽셀의 깊이가 2.0 m라고 하자.
- X = (420 − 320) × 2.0 / 500 = 0.4 m
- Y = (190 − 240) × 2.0 / 500 = −0.2 m
- Z = 2.0 m
Y가 음수인 것은 +y가 영상 아래쪽이기 때문이다. 공이 광축보다 0.2 m 위에 있다는 뜻이다. 다시 투영하면 u = 500 × 0.4 / 2.0 + 320 = 420으로 원래 픽셀이 나온다. 같은 카메라에서 지름 0.1 m 공은 2 m 거리에서 약 500 × 0.1 / 2.0 = 25 px 폭으로 보인다. 이 산술은 교육용 예제 example.py로 다시 계산했고, 실행 결과는 검산 기록 verification.json에 남아 있다. Python으로 수식을 확인한 기록일 뿐 로봇이나 시뮬레이터를 돌린 결과는 아니다.
결과 (0.4, −0.2, 2.0)은 optical 프레임 좌표다. 로봇 몸체 규약(x 앞, y 왼쪽, z 위)으로 축만 바꾸면 원점이 같다는 가정에서 (2.0, −0.4, 0.2) m가 된다. 축 부호를 확인하는 방법은 ROS 카메라 _optical 프레임 축 부호 확인 글에서, 카메라 장착 위치까지 반영하는 변환은 ROS 2와 tf2의 역할 정리에서 다룬다. 좌표계가 처음이라면 피지컬 AI 좌표계 입문을 먼저 읽는 편이 낫다.
직접 판단해 볼 두 가지
첫째, 깊이 영상의 encoding이 16UC1이고 공 중심 픽셀의 값이 2000이다. 이 숫자를 Z에 그대로 넣으면 X는 얼마이고, 맞는 값은 무엇인가?
그대로 넣으면 X = 100 × 2000 / 500 = 400이 나온다.
16UC1은 밀리미터 정수라서 0.001을 곱해 2.0 m로 바꾼 뒤 계산해야 X = 0.4 m가 된다. 근거는 아래 깊이 단위 절의 REP-118 규약이다.
둘째, 검출기가 공 중심을 오른쪽으로 1픽셀 잘못 잡았다. 공이 4 m에 있을 때와 0.5 m에 있을 때 X 오차는 각각 얼마인가?
1픽셀의 X 크기는 Z/fx이므로 4 m에서는 4 / 500 = 0.008 m, 0.5 m에서는 0.001 m다. 같은 1픽셀이라도 거리가 8배면 오차도 8배가 된다. 먼 물체일수록 검출 정확도가 위치 정확도를 더 크게 좌우한다.
깊이 값은 단위와 뜻을 먼저 맞춘다
깊이 영상은 sensor_msgs/Image로 오고, 단위는 encoding 필드가 알려 준다. REP-118의 표준 표현은 32FC1(32비트 실수)이며 각 픽셀은 카메라 Z축 방향의 깊이를 미터로 담는다. 대안 표현인 16UC1(16비트 부호 없는 정수)은 밀리미터 단위이고 0은 “측정값 없음”이다. 실수 표현에서는 NaN과 ±Inf가 같은 역할을 한다(REP-118 L23–L52). ROS의 depth_image_proc도 같은 규약으로 구현돼 있어서 uint16 값에는 0.001을 곱하고 0을 무효로, float 값은 유한한 값만 유효로 본다(depth_traits.hpp L45–L60). RealSense의 ROS 래퍼는 깊이 스트림을 16UC1로 발행한다(base_realsense_node.cpp L214). 다만 실제 장치의 한 단위가 정확히 1 mm인지는 장치 설정에 따라 달라질 수 있어 이번에 확인하지 않았다. 처음 쓰는 카메라라면 거리를 아는 물체로 한 번 대조하는 것이 안전하다.
두 번째로 맞출 것은 깊이의 뜻이다. 깊이는 카메라에서 공까지의 직선 거리가 아니라 그 점의 Z 성분이다. RealSense 공식 문서도 점의 거리는 √(x²+y²+z²)이고 깊이는 Z 성분일 뿐이며, 자사 카메라가 내는 것은 거리가 아니라 깊이라고 명시한다(RealSense 투영 문서). 그래서 깊이 값은 식의 Z 자리에 그대로 들어간다.
이 차이가 실제 코드에서 문제가 되는 곳이 있다. image_geometry의 project_pixel_to_3d_ray()는 픽셀이 가리키는 방향을 길이 1인 단위 벡터로 돌려준다(cameramodels.py L131–L147). 여기에 깊이를 곱하면 깊이를 직선 거리로 취급한 셈이라 Z가 짧아진다. 이 함수를 쓴다면 벡터에 깊이 대신 깊이 / 벡터의 z 성분을 곱해 Z를 깊이와 맞춰야 한다.
마지막은 컬러 픽셀과 깊이 픽셀의 짝이다. 컬러 카메라와 깊이 카메라는 위치와 내부 값이 서로 달라서, 컬러 영상에서 찾은 (u, v)로 깊이 영상을 읽으려면 두 영상이 정합(registration, 깊이 영상을 컬러 카메라 시점에 맞춰 다시 배치하는 처리)돼 있어야 한다. 출발점이 된 질문의 채택 답변도 정합을 핵심으로 꼽았다. RealSense 래퍼에서는 정렬 기능을 켰을 때 나오는 aligned_depth_to_color/image_raw와 같은 이름 공간의 aligned_depth_to_color/camera_info를 짝지어 쓰면 된다. 정합되지 않은 깊이 영상에 컬러 카메라의 K를 쓰면 식이 맞아도 결과가 틀린다.
재투영 검산이 잡는 실수와 지나치는 실수
투영식 u = fx·X/Z + cx에서 X와 Z를 같은 배수로 키우면 X/Z가 변하지 않는다. (X, Y, Z) 세 값에 같은 양수를 곱하면 몇 배를 하든 같은 픽셀로 돌아온다. 재투영은 점이 올바른 광선 위에 있는지, 즉 방향만 확인할 수 있고 광선 위 어디에 있는지는 보지 못한다는 뜻이다. 그래서 주점을 빼먹는 실수처럼 방향을 바꾸는 오류는 잡지만, 깊이를 밀리미터 그대로 X, Y, Z에 일관되게 쓰거나 단위 광선에 깊이를 곱한 오류처럼 같은 광선 위에서 크기만 틀린 오류는 통과시킨다. 크기는 따로 검사해야 한다. 계산한 Z가 미터로 바꾼 깊이와 같은지, 그 값이 센서가 잴 수 있는 범위인지 보는 검사다.
이 판단을 실제 ROS 2 메시지로 확인하려고 실험 스크립트를 만들었다. 정식 실행 전의 시험 실행에서 한 가지가 먼저 드러났다. 예측은 “P에 K 인덱스를 쓰면 0으로 나누게 된다”였는데, 시험 실행은 예외 없이 divide by zero 경고만 남겼다. Jazzy의 rclpy(ROS 2 Python 클라이언트 라이브러리)가 CameraInfo.k와 .p를 numpy 배열(ndarray, float64)로 돌려주기 때문이었다. 그래서 정식 실행에서는 메시지 원소를 그대로 쓴 경우와 Python float로 바꾼 경우를 둘 다 기록하도록 측정 항목을 바꿨다.
측정 환경은 다음과 같다. 공식 ros:jazzy-ros-base 이미지를 digest(이미지 내용의 고유 해시)로 고정했고(Python 3.12.3, numpy 1.26.4, rclpy 7.1.12-1noble.20260902.053513), 메시지 전달에는 기본 RMW(ROS 2가 노드 사이 메시지를 실제로 실어 나르는 통신 계층 구현, ROS middleware)인 rmw_fastrtps_cpp를 썼다. 컨테이너는 네트워크 없이 1 CPU, 1 GiB 제한으로 돌았고 하네스가 2026년 10월 11일에 5회 실행했다. 한 프로세스 안의 가짜 카메라 노드가 CameraInfo 두 개(보정됨, K[0] = 0)와 합성 깊이 영상 세 개(평판 원판 32FC1, 같은 장면 16UC1, 실제 구를 광선 추적(ray casting, 픽셀마다 광선을 쏘아 처음 닿는 표면을 찾는 방법)한 32FC1)를 rclpy 토픽으로 보내고, 받는 노드가 받은 메시지에서만 계산한다. 5회 모두 종료 코드 0이었고 다섯 메시지를 매번 받았다. 좌표·잔차·판정 값은 5회가 모두 같았다. 장면은 공 중심 (0.4, −0.2, 2.0) m, 반지름 0.05 m, 배경 벽 4.0 m로 정했고 (100, 100) 픽셀 하나를 일부러 무효로 만들었다.
재현 스크립트와 실행별 원본 출력은 공개 실험 디렉터리에 있다. 파일 단위로는 experiment.py, results.json, 실행 전 예측을 적은 plan.md다.
받는 노드는 깊이 3.0 m보다 가까운 유효 픽셀의 무게중심으로 공을 찾았다. 두 깊이 영상 모두 공 픽셀 489개, 중심 (420.0, 190.0)이 나왔고, 그 픽셀의 원시값은 32FC1에서 2.0, 16UC1에서 2000이었다. encoding에 따라 단위를 바꾼 뒤 두 영상에서 얻은 좌표는 (0.4, −0.2, 2.0)으로 같았고 차이는 0.0 m였다.
같은 픽셀과 깊이를 여러 방식으로 계산해 재투영 잔차(다시 투영한 픽셀과 원래 픽셀의 차이)와 Z 일치를 확인했다. 재투영은 잔차 0.5 px 미만, Z 검사는 |Z − 깊이| 0.005 m 미만을 통과로 봤다. 예측 열은 실행 전에 plan.md와 research 산술로 적어 둔 값이다.
| 계산 방식 | 실행 전 예측 | 실측 X, Y, Z (m) | 실측 재투영 잔차 (px) | 실측 Z − 깊이 (m) | 잡아낸 검사 |
|---|---|---|---|---|---|
| 정답 | (0.4, −0.2, 2.0), 잔차 0 | 0.4, −0.2, 2.0 | 0.0, 0.0 | 0.0 | 해당 없음(정답) |
| 주점 빼먹음 | (1.68, 0.76, 2.0), 재투영 (740, 430) | 1.68, 0.76, 2.0 | 320.0, 240.0 | 0.0 | 재투영만 |
16UC1 원시값을 X, Y, Z에 일관되게 사용 |
(400, −200, 2000), 잔차 0 | 400.0, −200.0, 2000.0 | 0.0, 0.0 | 1998.0 | Z 검사만 |
| X, Y는 mm 원시값, Z는 m | 재투영 u = 100320 | 400.0, −200.0, 2.0 | 99900.0, −49950.0 | 0.0 | 재투영만 |
| 단위 광선 × 깊이 | (0.39036, −0.19518, 1.95180), 잔차 0 | 0.39036, −0.19518, 1.9518 | 0.0, 0.0 | −0.0482 | Z 검사만 |
| 단위 광선을 Z에 맞춰 다시 늘림 | 정답과 같아야 함 | 0.4, −0.2, 2.0 | 0.0, 0.0 | 0.0 | 해당 없음(정답) |
| 다른 카메라 K(fx = fy = 610, cx = 316, cy = 244)로 계산하고 같은 K로 재투영 | 잔차 0 | 0.340984, −0.177049, 2.0 | 0.0, 0.0 | 0.0 | 둘 다 놓침 |
| 같은 오답을 메시지의 K로 재투영 | 잔차가 생김 | 0.340984, −0.177049, 2.0 | −14.7541, 5.7377 | 0.0 | 재투영만 |
장면의 정답 위치와 비교한 3D 오차는 주점을 빼먹은 경우 1.6 m, mm 일관 사용 2047.340763 m, mm·m 혼합 446.766382 m, 단위 광선 × 깊이 0.04939 m, 다른 카메라 K 0.063322 m였다. 원본 출력의 해당 줄은 다음과 같다(1회차 출력에서 발췌, 줄 내용은 그대로).
{"metric": "p_with_k_indices", "source": "numpy_elements_from_msg", "fy_from_p4": 0.0, "cy_from_p5": 500.0, "exception": null, "xyz": [0.4, "-inf", 2.0]}
{"metric": "p_with_k_indices", "source": "python_floats", "fy_from_p4": 0.0, "cy_from_p5": 500.0, "exception": "ZeroDivisionError", "xyz": null}
{"metric": "case", "name": "16uc1_mm_used_consistently", "xyz": [400.0, -200.0, 2000.0], "reproj_uv": [420.0, 190.0], "residual_px": [0.0, 0.0], "reprojection_pass": true, "z_minus_depth": 1998.0, "z_check_pass": false, "error_vs_truth_m": 2047.340763, "caught_by_reprojection": false, "caught_by_z_check": true}
{"metric": "case", "name": "unit_ray_times_depth", "xyz": [0.39036, -0.19518, 1.9518], "reproj_uv": [420.0, 190.0], "residual_px": [0.0, 0.0], "reprojection_pass": true, "z_minus_depth": -0.0482, "z_check_pass": false, "error_vs_truth_m": 0.04939, "caught_by_reprojection": false, "caught_by_z_check": true}
{"metric": "case", "name": "mismatched_k_reprojected_with_same_k", "xyz": [0.340984, -0.177049, 2.0], "reproj_uv": [420.0, 190.0], "residual_px": [0.0, 0.0], "reprojection_pass": true, "z_minus_depth": 0.0, "z_check_pass": true, "error_vs_truth_m": 0.063322, "caught_by_reprojection": false, "caught_by_z_check": false}
{"metric": "depth_is_z", "pixel": [0.0, 0.0], "depth_m": 2.0, "unit_ray_z": 1.561738, "z_short_percent": 21.913, "euclidean_distance_m": 2.56125}
나머지 측정 항목도 정리해 둔다.
- P에 K 인덱스를 쓴 실수: fy 자리에 0.0, cy 자리에 500.0이 들어갔다. 메시지 원소(numpy float64)를 그대로 쓰면 예외 없이 Y가
-inf가 됐고, Python float로 바꾸면ZeroDivisionError가 났다. - K[0] = 0인 CameraInfo는
intrinsics_from_k가 계산을 거부했다. - 깊이 = Z: (420, 190)에서 단위 광선 × 깊이의 Z는 1.9518 m로 2.41% 짧았고, 이 점의 직선 거리는 2.04939 m다. 영상 모서리 (0, 0)에서는 Z가 1.561738 m로 21.913% 짧았고 직선 거리는 2.56125 m다.
- 1픽셀 검출 오차가 만드는 X 변화: Z = 0.5, 1.0, 2.0, 4.0 m에서 각각 0.001, 0.002, 0.004, 0.008 m.
- 무효 깊이:
16UC1의 0을 그대로 쓰면 Z = 0이 되어 재투영에서ZeroDivisionError가 났다.32FC1의 NaN을 그대로 쓰면 예외 없이 재투영 결과가nan, nan이었다. 두 경우 모두encoding별 유효 마스크로 거르면 건너뛰었다. - 실제 구: 반지름 0.05 m 구의 중심 (0.41, −0.205, 2.05)는 픽셀 (420.0, 190.0)에 투영됐고, 그 픽셀의 깊이는 2.001205 m였다. 구 중심 Z와의 차이는 0.048795 m다.
- 계산 비용(비교용, 성능 기준 아님): 한 점 역투영은 5회 실행에서 0.186~0.191 µs, 640×480 깊이 영상 전체(무효 1픽셀을 뺀 307199개 점)를 numpy로 바꾸는 데 6.413~6.859 ms가 걸렸다.
결과는 실행 전 예측과 모든 행에서 일치했고, 예상과 다른 결과는 없었다. 앞서 적은 대로 “0으로 나누기”가 어떤 모습으로 나타나는지만 값의 타입에 따라 둘로 갈렸다.
여기부터는 해석이다. 재투영 검산은 주점 누락과 mm·m 혼합처럼 방향을 바꾸는 오류를 잡았고, mm 일관 사용과 단위 광선 × 깊이처럼 크기만 바꾸는 오류는 통과시켰다. 놓친 두 경우는 Z 검사가 잡았다. 그런데 다른 카메라의 K로 계산한 경우는 계산과 재투영에 같은 K를 쓰는 한 두 검사 모두 통과했다. 재투영은 계산에 쓴 K로 역산을 제대로 했는지 확인할 뿐, 그 K가 이 영상의 K인지는 확인하지 못한다. 잔차 −14.7541, 5.7377 px는 올바른 K를 따로 알고 있을 때만 볼 수 있는 값이다. P 인덱스 실수에서 나온 -inf와 무효 깊이에서 나온 nan은 다른 종류의 위험이다. 예외가 나지 않으니 프로그램은 멈추지 않고 잘못된 좌표가 다음 단계로 넘어간다. 실제 구 실험에서는 공 중심 픽셀의 깊이가 공 표면까지의 Z라서, 공 중심을 원한다면 반지름에 가까운 값만큼 Z를 더 멀리 잡아야 한다는 점도 확인됐다. 차이가 반지름보다 조금 작은 것은 공 중심을 향한 광선이 광축에서 약간 기울어 있어 반지름의 일부만 Z 성분으로 나타나기 때문으로 해석한다.
같은 조건으로 돌려 보려면 Docker가 있는 Linux 셸에서 빈 디렉터리를 만들고 다음을 실행한다. 이미지를 처음 받을 때만 네트워크가 필요하고, 컨테이너 자체는 네트워크 없이 돈다. 하네스도 같은 이미지, 같은 CPU·메모리 제한, 네트워크 차단 조건으로 실행했다. 다만 하네스는 스크립트 디렉터리를 읽기 전용으로 마운트하고 임시 디렉터리에서 실행하는 격리 옵션을 몇 가지 더 썼다.
mkdir rgbd-xyz && cd rgbd-xyz
curl -fsSLO https://raw.githubusercontent.com/sungpyo9053/blog/main/experiments/rgbd-camera-pixel-depth-to-xyz-camera-info-k/experiment.py
docker run --rm --network none --cpus 1 --memory 1g -v "$PWD":/work ros@sha256:066420e07f60aa18262f2479981def87ebcfcec42eefb0c0c57c4a46098348ca bash -c "source /opt/ros/jazzy/setup.bash && python3 /work/experiment.py"
정상이라면 JSON 줄이 차례로 출력되고 마지막 줄이 "metric": "done"이며 종료 코드는 0이다. abort 줄이 나오면 메시지를 받지 못한 것이다. 좌표와 판정 값은 위와 같아야 하고, 지연 시간과 계산 시간은 컴퓨터 상태에 따라 달라진다.
로봇에 넘기기 전에 남는 확인
실행 결과를 종합하면, 픽셀과 깊이에서 좌표를 얻을 때의 확인 순서는 다음처럼 정리된다.
- 깊이 메시지의
encoding을 본다.16UC1이면 0.001을 곱하고 0은 건너뛴다.32FC1이면 그대로 쓰고 NaN·Inf는 건너뛴다. - 깊이 영상과 짝이 맞는
camera_info인지 확인한다. 컬러 픽셀이면 컬러에 정합된 깊이 토픽과 그camera_info를 쓰고, 해상도가width,height와 같은지,K[0]이 0이 아닌지 본다. 이 단계는 재투영도 Z 검사도 대신해 주지 못한다. - 픽셀을 얻은 영상이 원본인지 보정본인지에 따라 K 또는 P에서 값을 꺼내 역투영한다. 메시지 원소는 Python float로 바꿔 두면 0으로 나누기가 조용히
-inf로 넘어가지 않는다. - 재투영 잔차로 방향을, 계산한 Z와 미터 깊이의 일치로 크기를 확인한다.
이 계산이 다루지 않는 부분도 분명히 남는다. 렌즈 왜곡 보정, 실제 장치의 정합 정확도, 깊이 노이즈와 물체 가장자리에서 배경과 섞인 값, 실제 RealSense의 깊이 단위 설정은 실험하지 않았다. 공 가장자리 픽셀은 배경 깊이와 섞이거나 무효일 수 있어서, 중심 주변 작은 창에서 유효한 깊이의 중앙값을 쓰는 방식이 흔히 쓰이지만 공식 권고로 확인한 방법은 아니다.
구한 좌표는 카메라 optical 프레임 기준이다. 로봇이 쓰려면 몸체 축으로 바꾸고 카메라 장착 위치까지 반영해야 한다. 그리고 좌표가 맞는다는 사실만으로 로봇 팔이나 이동 명령이 안전해지지는 않는다. 실물 로봇에 넘기기 전에는 작업 공간 제한과 비상 정지 수단을 갖춘 환경에서 별도로 확인해야 하며, 이 글은 그 절차를 다루지 않는다.
다음 단계는 축 변환이다. 위 예제의 (0.4, −0.2, 2.0)을 로봇 몸체 규약으로 옮길 때 부호를 어떻게 확인하는지는 ROS 카메라 _optical 프레임으로 점을 옮길 때 축 부호가 맞는지 확인하기에서 이어진다.
공식 자료는 2026년 10월 11일에 고정 커밋 기준으로 확인했다. 이 글에는 제휴·협찬이 없다.