내부 링크 백필 전에 JSON 백업과 공개 URL 검증을 넣은 과정
JSON 백업과 공개 URL 검증을 먼저 나눈 이유
WordPress 내부 링크를 백필하기 전에 JSON 백업과 공개 URL 검증을 운영 절차에 넣었습니다. 여기서 공개 URL 검증은 backfill_internal_links.py에 새 기능을 구현했다는 뜻이 아닙니다. 실제 스크립트와 JSON 백업을 대조한 뒤, 별도의 읽기 전용 HTTP 확인을 백필 전 점검 단계로 배치했다는 의미입니다. 스크립트의 status=publish 필터와 브라우저가 접근할 공개 URL 검증은 서로 다른 작업입니다.
이번 기록은 2026년 7월 29일 기준 코드와 백업 산출물을 바탕으로 합니다. 11개 소스와 글별 타깃 2개는 당시 작업의 범위이며, 이후 확장된 링크 그래프의 현재 크기를 뜻하지 않습니다. 자동 추천 플러그인 이야기가 아니라, 검토한 링크 그래프를 기존 글 11개에 백필할 때 어디까지 읽고 언제부터 쓰는지 확인한 과정입니다.
구현의 읽기·백업·쓰기 순서는 공개 백필 스크립트에서 확인할 수 있습니다. 링크 그래프가 확장된 이 버전에도 첫 100건 조회와 마커 기반 건너뛰기가 남아 있으므로, 과거 명령을 현재 사이트에 그대로 적용해서는 안 됩니다.
먼저 확인한 건 읽기와 쓰기의 경계였다
스크립트는 WordPress에서 다음 조건으로 글 컬렉션을 한 번 읽습니다.
GET posts?status=publish&context=edit&per_page=100
status=publish라서 조회 응답에 들어온 공개 상태 글만 소스와 타깃 후보가 됩니다. context=edit은 수정 전 본문인 content.raw를 읽는 데 쓰입니다. 링크를 어디에 넣을지는 자동으로 계산하지 않습니다. 소스 글 ID 11개와 각 글의 타깃 ID 2개가 LINKS에 미리 정해진 작은 링크 그래프였습니다. 링크 추천을 자동화한 구현은 아닙니다.
여기서 꽤 중요한 경계가 하나 나옵니다. per_page=100으로 첫 응답만 받고 페이지네이션은 처리하지 않습니다. 공개 글이 100건을 넘거나 검토한 ID가 첫 페이지에 없으면 Missing reviewed source/target 오류로 쓰기 전에 중단됩니다. 누락된 타깃을 모른 척하고 섹션을 만드는 건 막지만, 사이트의 모든 공개 글을 읽는 구조는 아닙니다.
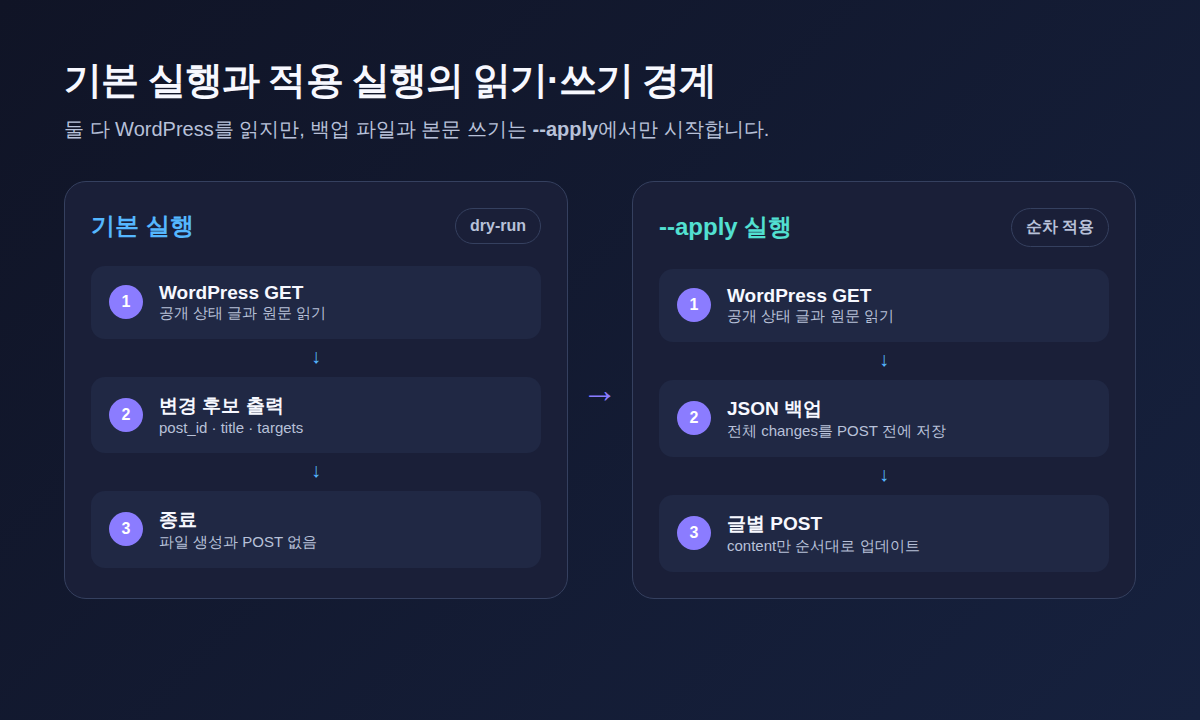
WordPress 쓰기는 --apply를 붙였을 때만 시작합니다. 글마다 POST posts/<id>에 content만 담아 보내며 제목, 카테고리, 태그, slug를 payload에 넣지는 않습니다. 읽기와 업데이트 엔드포인트의 의미는 WordPress Posts REST API 문서와도 대조했습니다.
기본 실행은 쓰기 없는 dry-run, 완전 오프라인은 아니다
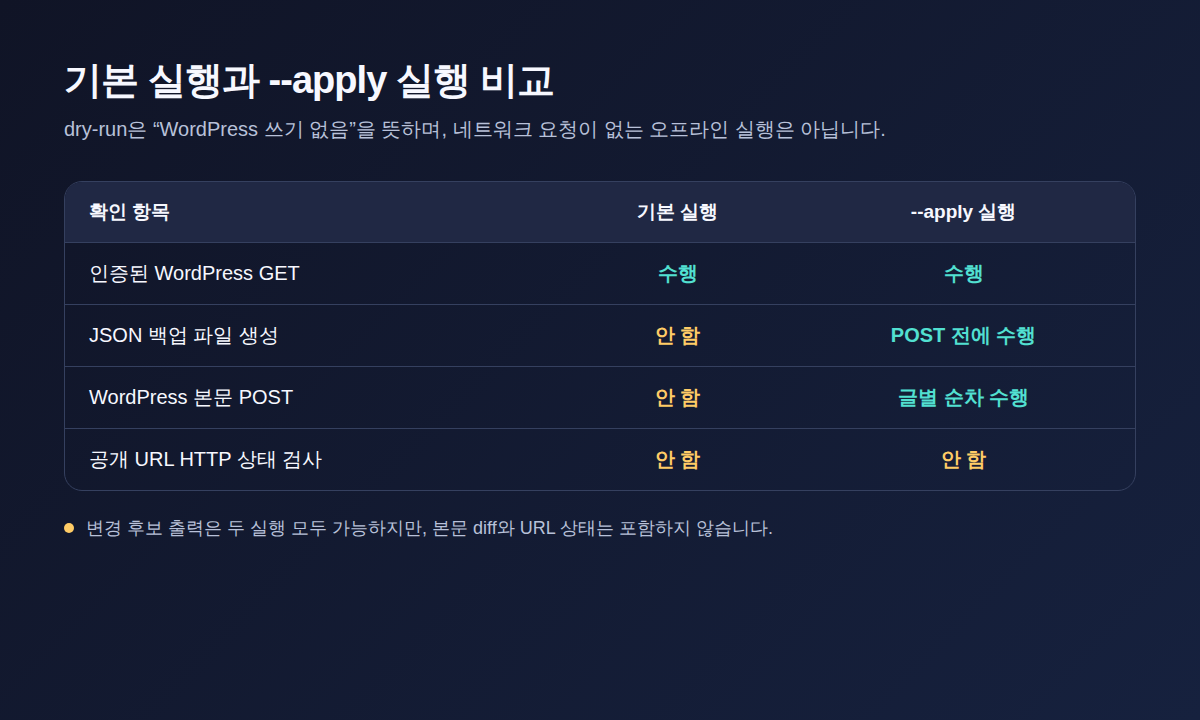
--apply의 기본값은 거짓입니다. 옵션 없이 실행하면 변경 후보의 post_id, title, targets를 JSON으로 표준 출력한 뒤 종료합니다. WordPress 글을 POST로 수정하지 않고 백업 파일도 만들지 않습니다.
그래서 코드 기준으로는 “WordPress 쓰기가 없는 dry-run”이라고 부를 수 있습니다. 그런데 네트워크 요청 자체가 없지는 않습니다. 실행 초기에 인증된 GET으로 공개 상태 글을 읽습니다. dry-run 결과에도 본문 diff, 대상 URL의 HTTP 상태, 생성될 백업 경로는 나오지 않습니다.
변경할 글과 타깃 목록을 확인할 수는 있지만, 이 출력은 본문 변화나 링크 도달성을 검증한 결과가 아닙니다. dry-run을 검토할 때는 실제로 확인한 항목을 함께 읽어야 합니다.
| 확인 항목 | 기본 실행 | --apply 실행 |
|---|---|---|
| 인증된 WordPress GET | 수행 | 수행 |
| 변경 후보 출력 | 수행 | 수행 가능 |
| JSON 백업 파일 생성 | 안 함 | POST 전에 수행 |
| WordPress 본문 POST | 안 함 | 글별 순차 수행 |
| 공개 URL HTTP 상태 검사 | 안 함 | 안 함 |
JSON에는 원문과 수정본을 함께 남겼다
적용 모드에서는 전체 changes 배열을 UTC 시각이 붙은 UTF-8 JSON 파일로 먼저 저장하고, 그다음 각 글을 순서대로 업데이트합니다. 지정된 백업 산출물을 구조적으로 확인한 결과 최상위는 11개 항목의 배열이었습니다.
각 항목에는 다음 다섯 필드가 들어 있습니다.
post_id: 복원할 글을 식별할 IDtitle: 사람이 대조하기 위한 글 제목original_content: 변경 전 본문updated_content: 관련 글 섹션을 붙인 적용 예정 본문targets: 연결할 대상 정보
11개 항목 모두 원문과 수정본이 달랐고, 글별 타깃은 2개였습니다. 원문에는 v1 마커가 없고 수정본에는 모두 마커가 들어 있었습니다. 실제 본문 전체를 여기 다시 옮길 이유는 없어서 구조만 확인했습니다.
이 정도면 post_id에 original_content를 다시 제출하는 별도 복원 도구를 만들 재료는 있습니다. 하지만 자동 rollback이라고 부를 단계는 아닙니다. 현재 스크립트에는 백업을 읽어 복원하는 옵션도, 항목별 성공·실패 상태도, 콘텐츠 해시도 없습니다. 적용 완료 시각이나 WordPress 응답 역시 백업 항목에 남지 않습니다.
백업 저장도 임시 파일을 쓴 뒤 원자적으로 교체하는 방식이 아니며, 작성한 JSON을 다시 읽어 무결성을 확인하지 않습니다. 정확한 평가는 “WordPress 업데이트 전에 복원용 원문을 파일로 쓰도록 했다” 범위입니다. 복구 절차를 시험하지 않았으므로 복구 가능성까지 확정할 수는 없습니다.
백업 JSON에 복원할 원문이 있는지 먼저 검사한다
아래는 2026년 9월 16일 추가한 독자용 검사입니다. Python 3.11 이상에서 블록 전체를 실행하면 정상 입력과 원문이 빈 실패 입력을 비교합니다. 표준 라이브러리만 쓰며 네트워크 요청이나 파일 쓰기는 없습니다. 운영 백업을 외부 서비스에 올릴 필요도 없습니다.
python3 - <<'PY'
import json
import sys
from pathlib import Path

def check(rows):
    if not isinstance(rows, list) or not rows:
        return False
    seen = set()
    for row in rows:
        if not isinstance(row, dict):
            return False
        post_id = row.get('post_id')
        if type(post_id) is not int or post_id <= 0 or post_id in seen:
            return False
        seen.add(post_id)
        if any(not isinstance(row.get(k), str) or not row[k].strip()
               for k in ('title', 'original_content', 'updated_content')):
            return False
        targets = row.get('targets')
        if not isinstance(targets, list) or not targets:
            return False
        if any(type(t) is not int or t <= 0 or t == post_id for t in targets):
            return False
        if len(set(targets)) != len(targets):
            return False
        if row['original_content'] == row['updated_content']:
            return False
    return True

good = [{'post_id': 1, 'title': 'Sample', 'original_content': '<p>Before</p>',
         'updated_content': '<p>Before</p><p>Related</p>', 'targets': [2]}]
bad = [dict(good[0], original_content='')]
if len(sys.argv) == 1:
    for label, rows, expected in [('valid', good, True), ('missing_original', bad, False)]:
        result = check(rows)
        print(f'{label}: passed={str(result).lower()}')
        assert result is expected
else:
    try:
        with Path(sys.argv[1]).open('rb') as source:
            raw = source.read(10_000_001)
        if len(raw) > 10_000_000:
            raise ValueError('too large')
        passed = check(json.loads(raw))
    except (OSError, ValueError, RecursionError):
        passed = False
    print(json.dumps({'passed': passed}))
    sys.exit(0 if passed else 1)
PY
관측 출력은 valid: passed=true, missing_original: passed=false이고 전체 종료 코드는 0이었습니다. 두 판정을 올바르게 구분해야 대조 시험이 통과합니다. 이 합성 예제는 과거 11건 백업의 재실행 결과가 아닙니다.
실제 파일은 첫 줄만 python3 - "backup.json" <<'PY'로 바꿔 로컬 파일을 읽습니다. 경로는 자신의 백업 파일로 지정하고 나머지 블록은 그대로 둡니다. 전체 종료 0과 {"passed": true}면 이 검사의 항목을 통과했고, 1이면 JSON 형식·필수 원문·ID·타깃·본문 차이부터 확인합니다. 10MB를 넘는 파일은 거부합니다. 실패해도 원문이나 경로를 출력하지 않습니다.
여기서 확인하는 것은 복원용 필드와 변경 계획의 기본 일관성뿐입니다. 이 검사는 원문이 실제 WordPress와 같은지, 타깃이 공개 URL로 열리는지, 백업을 복원할 수 있는지 증명하지 않습니다. 본문이 비어 있는 글을 변경하는 계획도 이 예제에서는 보류합니다. 검사가 통과해도 아래의 URL 확인과 부분 실패 대책을 생략하지 않습니다.
중복 방지는 URL 검색이 아니라 v1 마커로 한다
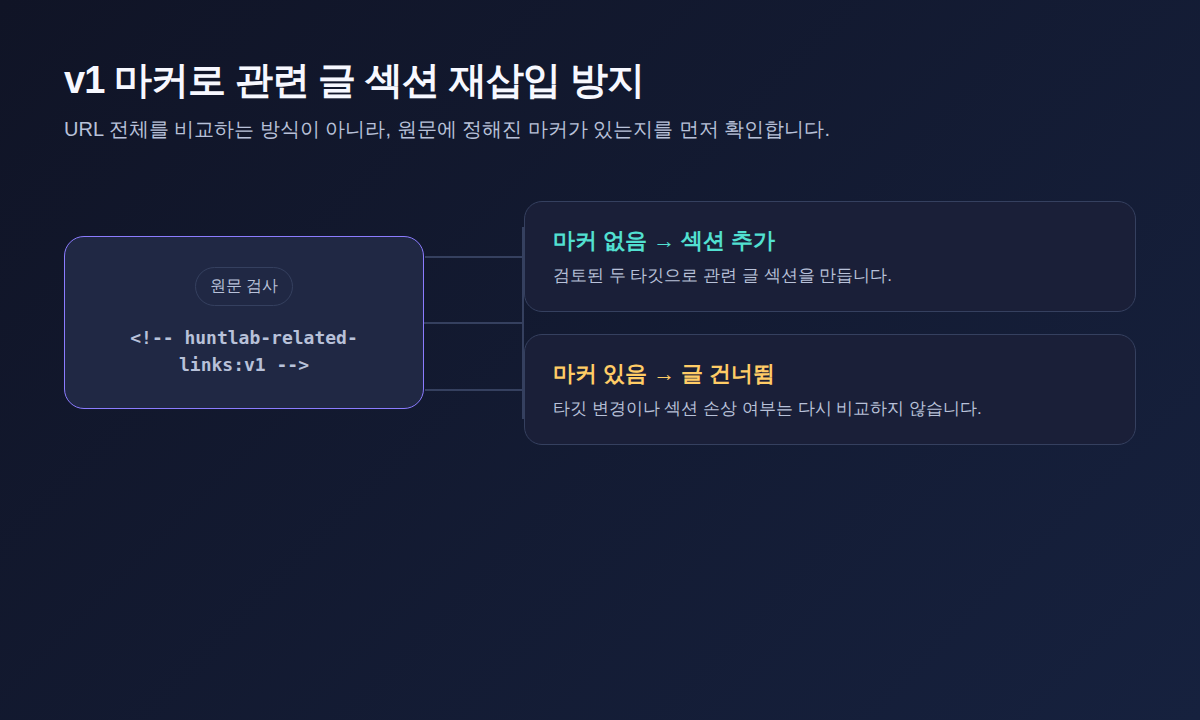
관련 글 섹션 앞에는 다음 마커가 붙습니다.
<!-- huntlab-related-links:v1 -->
원문 어디든 이 문자열이 있으면 해당 글을 통째로 건너뜁니다. 같은 콘텐츠에 같은 스크립트를 다시 적용했을 때 섹션이 한 번 더 붙는 건 막을 수 있습니다. 단순하고 역할이 분명한 재삽입 방지 장치입니다.
대신 “모든 중복 링크 방지”로 넓혀 말하면 안 됩니다.
- 마커 없이 같은 URL이 이미 들어 있으면 알아채지 못합니다.
- 마커가 있어도 섹션이 깨졌거나 타깃 구성이 바뀌면 갱신하지 않습니다.
- 타깃 제목이나 permalink가 바뀌어도 기존 섹션을 다시 만들지 않습니다.
- 자기 참조나 동일 타깃 반복을 일반 규칙으로 검사하지 않습니다.
현재 고정된 LINKS 값에는 소스 자기 참조나 같은 타깃의 반복이 없었지만, 데이터 검토 결과이지 코드가 항상 강제하는 조건은 아닙니다. 그래서 이 구현은 “v1 마커가 있는 글의 섹션 재삽입 방지”라고 구분했습니다.
공개 상태 글과 실제로 열리는 URL은 같은 검증이 아니다
status=publish는 WordPress 레코드가 공개 상태인지 제한하지만, post["link"]로 인증 없는 GET이나 HEAD를 보내지는 않습니다. 따라서 현재 스크립트만으로는 아래 항목을 알 수 없습니다.
- DNS와 TLS 연결이 성공하는지
- 최초 및 최종 HTTP 상태가 무엇인지
- 리다이렉트가 몇 번 발생하고 어디로 도착하는지
- 로그인 벽이나 유지보수 페이지가 나오는지
- 정상 응답처럼 보이는 soft 404인지
별도의 읽기 전용 조사에서는 백업의 관련 글 섹션에서 고유 URL 11개를 추출해, 인증 없이 GET하고 리다이렉트를 따라갔습니다. 2026년 7월 29일 확인 시점에는 11개 모두 최종 HTTP 200, 리다이렉트 0회였습니다.
그래도 이건 조사 시점의 순간 관측입니다. HTTP 200은 요청이 성공 응답 클래스였다는 뜻이지, 연결한 콘텐츠의 의미가 맞다거나 이후에도 계속 열릴 거라는 보장은 아닙니다. 무엇보다 이 검사는 backfill_internal_links.py의 --apply 직전에 자동 수행된 기능이 아닙니다. RFC 9110의 HTTP 상태 의미를 기준으로 별도 확인한 결과로만 적어야 정확합니다.
실제 적용 전 URL 검증을 스크립트에 넣는다면 기대한 HTTPS 호스트인지 먼저 보고, 제한된 횟수로 리다이렉트를 따라 최종 상태와 최종 URL을 기록하는 흐름이 필요합니다. HEAD를 지원하지 않는 경우를 위한 GET fallback 정책도 정해야 합니다. 이 부분은 현재 구현 설명이 아니라 확인된 빈틈에서 나온 개선안입니다.
백업이 먼저여도 11건 전체가 한 트랜잭션은 아니다
적용 순서는 분명합니다. 전체 변경 계획을 JSON으로 쓴 다음, 11개 글을 하나씩 순차 POST합니다. 백업보다 WordPress 쓰기가 먼저 나가는 구조는 아닙니다.
하지만 세 번째 글에서 요청이 실패한다고 가정하면 앞의 두 글을 자동으로 되돌리는 코드는 없습니다. 뒤의 글은 적용되지 않고 앞의 글만 수정된 부분 적용 상태가 될 수 있습니다. 백업에도 어느 항목까지 성공했는지 표시되지 않으니 표준 출력과 현재 WordPress 상태를 다시 대조해야 합니다. 백업 선행과 트랜잭션 보장은 별도 보장입니다.
현재 코드에서 확인한 한계를 바탕으로 다음 완료 조건을 잡을 수 있습니다.
- 첫 100건에 기대지 말고 페이지네이션을 처리하거나 검토 ID만 정확히 조회합니다.
- 공개 URL의 최종 상태, 리다이렉트, 최종 호스트를 적용 전에 기록합니다.
- JSON을 다시 파싱해 항목 수와 필수 필드를 확인하고 콘텐츠 해시도 남깁니다.
- dry-run에 본문 diff, URL 결과, 마커로 건너뛴 글과 누락 ID를 포함합니다.
- POST 직전 본문이 백업 시점의
original_content와 같은지 다시 확인합니다. - 글별 성공·실패를 기록하고 재개 또는 rollback 도구를 따로 둡니다.
- 적용 후 공개 페이지에서 관련 글 섹션과 링크를 다시 확인합니다.
이 일곱 가지가 이미 구현됐다는 뜻은 아닙니다. 지금 코드가 어디까지 안전하고 어디서부터 추가 작업인지 나눠 놓은 체크리스트입니다. 항목별로 구현과 검증을 마친 뒤 적용 여부를 판단해야 합니다.
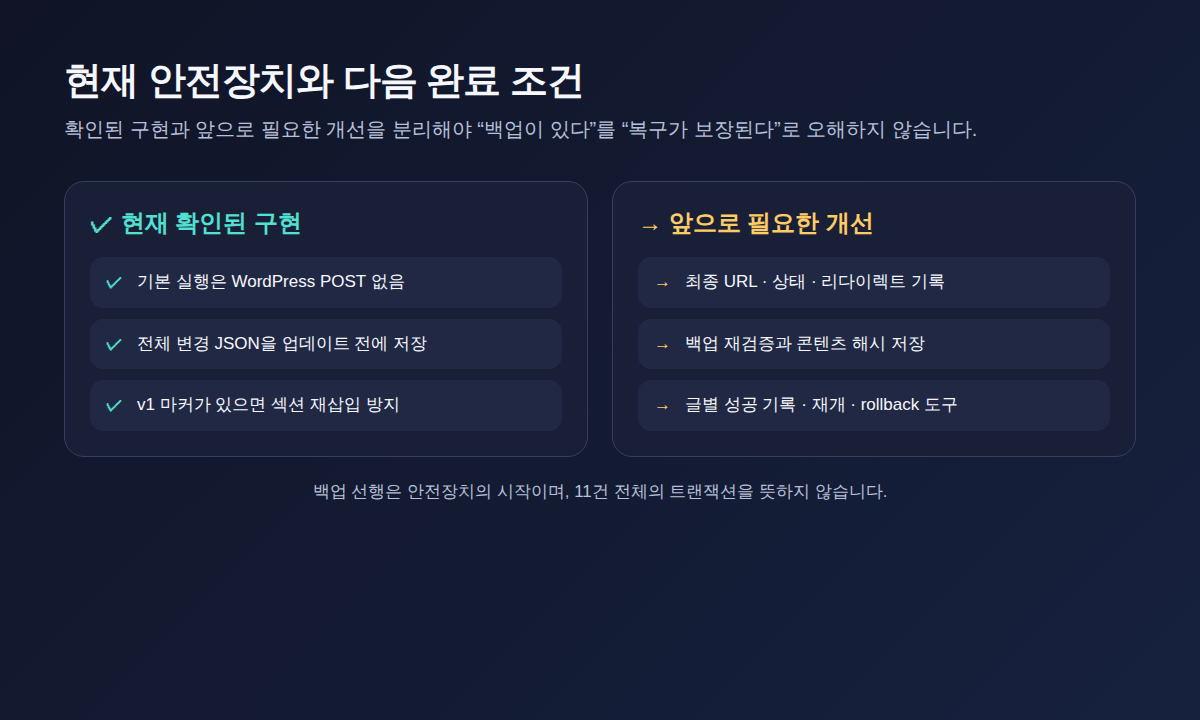
지금 단계에서 내린 판단
이번 internal link backfill은 검토된 링크 그래프, 쓰기 없는 기본 실행, 업데이트 전 JSON 원문 저장, 마커 재삽입 방지까지는 코드와 산출물로 확인됐습니다. 반면 공개 URL의 HTTP 검사는 별도 조사였고 자동 rollback과 전체 트랜잭션도 없습니다. 대량 변경 도구로 일반화하려면 부분 실패 처리와 복원 검증이 더 필요합니다.
특히 여러 글을 순차 수정한다면 “백업 파일이 있다”에서 멈추지 말고 어느 POST가 실패했는지, 어떻게 재개할지를 같이 설계해야 합니다. 다음 단계가 필요하다면 WordPress REST API 재시도 글에서 글별 POST 실패와 재시도 정책을 별도로 점검할 수 있습니다.
제휴 링크나 협찬은 없습니다.